10/09

Thứ Năm · 28 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 50/100

Salesforce đề xuất phương pháp hiệu chỉnh chính sách giúp mô hình AI học tập hiệu quả hơn

Nice paper from Salesforce on co-evolving harnesses and models. Harness engineering is a hot topic …

DịchNghiên cứu mới từ Salesforce giải quyết vấn đề mô hình AI bị 'sao chép thất bại' khi cùng tiến hóa với các hệ thống hỗ trợ (harnesses), thông qua kỹ thuật hiệu chỉnh chính sách (on-policy correction).

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnDF26: Khi ranh giới giữa video thật và giả do AI tạo ra đã hoàn toàn bị xóa nhòa

DF26 là bộ dữ liệu chuẩn mới gồm hơn 2.700 video, cho thấy cả con người lẫn các công cụ phát hiện deepfake hiện đại đều gần như bất lực trước các video do AI tạo ra. Nghiên cứu này gióng lên hồi chuông cảnh báo về sự cần thiết của các tiêu chuẩn kiểm chứng mới trong kỷ nguyên AI tạo sinh.


Vì sao đáng đọc: Chủ đề cực kỳ cấp thiết về an ninh mạng và deepfake. Kết quả nghiên cứu gây sốc về khả năng phát hiện của con người tạo tính thời sự cao, thu hút sự quan tâm lớn.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Đồng tiến hóa Harness và Mô hình: Khi hiệu chỉnh On-Policy giúp mô hình nhỏ bắt kịp hiệu suất

Nghiên cứu chỉ ra rằng việc tối ưu hóa hệ thống hỗ trợ (harness) giúp mô hình nhỏ đạt hiệu suất cao, nhưng việc huấn luyện bắt chước từ chuyên gia lại gây phản tác dụng, đòi hỏi phương pháp hiệu chỉnh on-policy thay thế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnDianShi-RxnDB: Nền tảng dữ liệu phản ứng hữu cơ quy mô lớn được tự động hóa cho AI và nghiên cứu hóa học

DianShi-RxnDB là kho dữ liệu khổng lồ với 14,8 triệu phản ứng hữu cơ được trích xuất tự động từ bằng sáng chế, cung cấp thông tin chi tiết về quy trình thí nghiệm, nhiệt độ và hiệu suất, hỗ trợ đắc lực cho các tác nhân AI trong lĩnh vực hóa học.


Vì sao đáng đọc: Đây là nguồn tài nguyên dữ liệu quý giá, giải quyết bài toán thiếu hụt dữ liệu cấu trúc chất lượng cao cho AI trong ngành hóa học, có tính ứng dụng thực tiễn rất lớn.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DATPO: Tối ưu hóa chính sách dạng cây thích ứng độ khó để mở rộng khả năng suy luận trong RLVR

Nghiên cứu giới thiệu DATPO, phương pháp tối ưu hóa cấu trúc suy luận dạng cây giúp tăng cường độ đa dạng ngữ nghĩa và khả năng giải quyết vấn đề của các mô hình AI thông qua học tăng cường có thưởng (RLVR).

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 47/100

Programmable World Model: Mô hình thế giới có thể lập trình giúp tách biệt trạng thái và tạo hình ảnh

Mô hình này cho phép AI chuyển đổi ngôn ngữ tự nhiên thành mã thực thi để kiểm soát trạng thái thế giới, giúp việc tạo video và mô phỏng trở nên chính xác, nhất quán hơn thông qua một engine nhẹ.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 51/100

Nghiên cứu từ ETH Zürich: Điểm số môn Khoa học máy tính dự đoán khả năng 'vibe coding' tốt hơn kỹ năng viết

If you think vibe coding makes computer science fundamentals irrelevant, this study points the other…

DịchNghiên cứu trên 100 sinh viên cho thấy điểm số môn Khoa học máy tính có khả năng dự đoán hiệu suất 'vibe coding' (lập trình qua AI) cao gấp đôi so với kỹ năng viết, dù cả hai đều đóng vai trò quan trọng trong việc tạo ra các câu lệnh (prompt) hiệu quả.

Elvis Saravia@omarsar0
NgànhĐiểm AI 43/100

AutoResearchExam: Bộ tiêu chuẩn mới đánh giá năng lực nghiên cứu của AI Agent

This is a really neat benchmark. It's super interesting that Astra starts strong and holds the lead …

DịchAutoResearchExam đánh giá khả năng tự nghiên cứu của AI trong 24 giờ qua 7 lĩnh vực chuyên sâu. Kết quả cho thấy Fable 5.1 đang dẫn đầu, trong khi Qwen, Gemini và Grok chiếm ưu thế về hiệu suất chi phí.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGraph Machine: Đột phá kiến trúc mới giúp tối ưu hóa tiền huấn luyện mô hình ngôn ngữ

Graph Machine (GM) là kiến trúc mới sử dụng các 'cạnh' (edges) linh hoạt để truy xuất dữ liệu, giúp duy trì độ phức tạp O(n) mà vẫn đảm bảo tính thưa thớt hiệu quả. Phương pháp này cho phép thay thế phần lớn các lớp Transformer truyền thống với hiệu suất vượt trội và chi phí tính toán thấp.


Vì sao đáng đọc: Đây là một nghiên cứu kỹ thuật chuyên sâu có tiềm năng thay đổi cách thiết kế kiến trúc mô hình ngôn ngữ, giúp giảm tài nguyên tính toán mà vẫn giữ được độ chính xác.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 57/100

Đột phá từ Đại học Thanh Hoa và Qwen: Tái cấu trúc quỹ đạo AI thành môi trường huấn luyện lập trình

New Tsinghua + Qwen Team's paper flips the usual agent-data recipe: Reconstructing and re-solving o…

DịchNhóm nghiên cứu từ Thanh Hoa và Qwen giới thiệu Terminal-Universe, phương pháp khôi phục không gian làm việc từ quỹ đạo AI để tạo dữ liệu huấn luyện chất lượng cao, giúp cải thiện đáng kể hiệu suất của mô hình Qwen3.5-27B trong các tác vụ lập trình thực tế.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 57/100

Thực nghiệm suy luận: Qwen3.8 đạt độ tương đồng 18,18% với GPT-5.5 Pro nhờ kỹ thuật tiền nạp

Tác giả sử dụng GPT-5.5 Pro làm mô hình giáo viên để thực hiện kỹ thuật tiền nạp (pre-filling) 1% dữ liệu suy luận vào Qwen3.8, kết quả cho thấy độ tương đồng câu trả lời tăng đáng kể trên 45 bài kiểm tra.

Elvis Saravia@omarsar0
NgànhĐiểm AI 45/100

Google giới thiệu khung Procedural Graph: Bước tiến giúp AI tự tiến hóa

Another banger paper from Google. If you build memory for long-horizon agents, this one is worth yo…

DịchGoogle đề xuất khung Procedural Graph giúp AI lưu trữ kiến thức dưới dạng sơ đồ quy trình, cho phép tự động tinh chỉnh và tối ưu hóa hành động dựa trên kinh nghiệm thực tế, từ đó vượt qua các giới hạn của thiết kế thủ công.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VDiff-Bench: Bộ tiêu chuẩn đánh giá khả năng nhận diện thay đổi chi tiết giữa hai hình ảnh

VDiff-Bench là bộ tiêu chuẩn mới gồm 1.756 câu hỏi trắc nghiệm, giúp kiểm tra khả năng phát hiện các thay đổi tinh vi giữa hai hình ảnh của các mô hình ngôn ngữ đa phương thức (MLLM) vốn thường gặp khó khăn trong tác vụ này.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 64/100

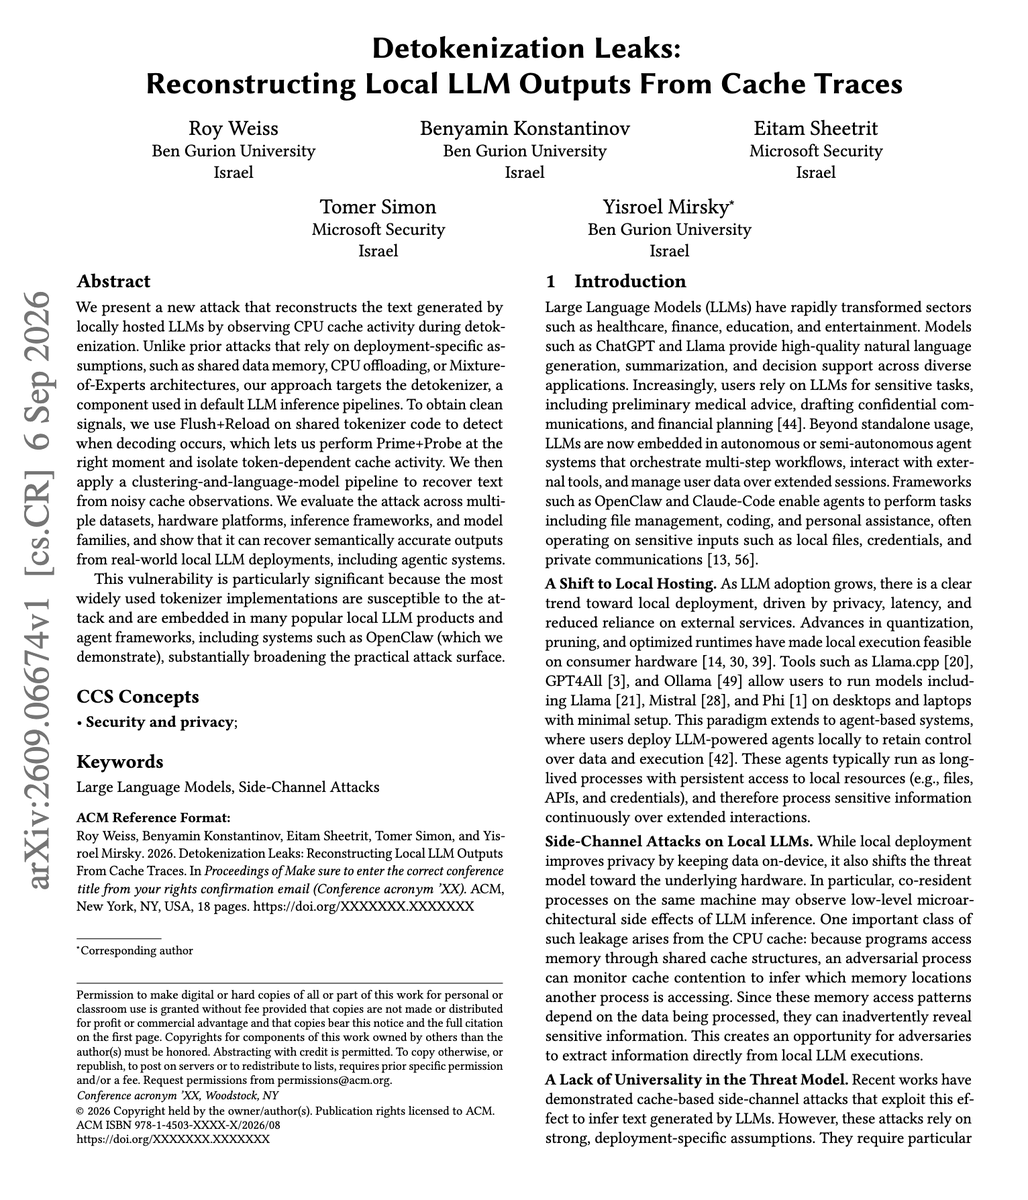
Microsoft phát hiện lỗ hổng 'Detokenization Leaks': Đánh cắp dữ liệu LLM qua bộ nhớ đệm CPU

Wild paper from Microsoft and colleagues. They show a new attack that reconstructs the text a local…

DịchCác nhà nghiên cứu từ Microsoft và ĐH Ben Gurion đã phát triển kỹ thuật tấn công mới, cho phép khôi phục văn bản từ các mô hình LLM chạy cục bộ bằng cách theo dõi hoạt động bộ nhớ đệm CPU trong quá trình giải mã token.

AK@_akhaliq
NgànhĐiểm AI 24/100

NeoHorse-1: Bước tiến mới trong huấn luyện hậu kỳ cho tác nhân AI với khả năng tự cải tiến đệ quy

NeoHorse-1 Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness paper…

DịchNeoHorse-1 giới thiệu khung làm việc dựa trên định tuyến (routing framework), cho phép các tác nhân AI thực hiện quá trình tự cải tiến đệ quy sau huấn luyện, giúp tối ưu hóa hiệu suất một cách tự động.

09/09

Thứ Tư · 37 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 43/100

SynthGait-19K: Bộ dữ liệu video tổng hợp phục vụ phân tích dáng đi

SynthGait-19K là bộ dữ liệu gồm hơn 19.000 video mô phỏng dáng đi từ 437 đối tượng, đi kèm chú thích chuyển động SMPL và 6 thông số dáng đi quan trọng, hỗ trợ đắc lực cho nghiên cứu thị giác máy tính.

Fei-Fei Li@drfeifei
NgànhĐiểm AI 37/100

Fei-Fei Li: Nghiên cứu AI đang phân hóa thành kỷ nguyên 'dư thừa token'

The world of R&D is forking into two paths: the token-abundant research, and the token-starved resea…

DịchFei-Fei Li nhận định tương lai AI thuộc về các đơn vị sở hữu nguồn lực token dồi dào. Bà kêu gọi các trường đại học tái định hình chiến lược nghiên cứu trước sự bùng nổ của các phòng thí nghiệm AI tiên tiến.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

PLANFENCE: Giải pháp đảm bảo tính nhất quán giữa trí nhớ và kế hoạch của AI Agent

The paper shows that refreshing an agent's memory does not refresh its plan, so the plan should be c…

DịchNghiên cứu chỉ ra rằng AI Agent thường thực hiện các thao tác lỗi thời dù trí nhớ đã được cập nhật. PLANFENCE giải quyết vấn đề này bằng cách liên kết kế hoạch với dữ liệu đầu vào, tự động lập kế hoạch lại khi dữ liệu thay đổi để đảm bảo tính chính xác.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 31/100

A*-Thought-V2: Tối ưu hóa suy luận LLM thông qua động lực học hình học

A*-Thought-V2 cải thiện hiệu suất suy luận bằng cách mô hình hóa chuỗi tư duy dưới dạng quỹ đạo trạng thái ẩn, giúp tăng độ chính xác lên 2,6% và giảm đáng kể thời gian tính toán cũng như tài nguyên huấn luyện.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OpenWAM: Bước tiến mở và mô-đun hóa trong huấn luyện trước mô hình Thế giới - Hành động

OpenWAM giới thiệu một nền tảng nghiên cứu mở giúp tách biệt các thành phần trong mô hình Thế giới - Hành động (WAM), cho phép thử nghiệm có kiểm soát để hiểu rõ cách thức tri thức từ video chuyển hóa thành tín hiệu điều khiển cho robot.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 45/100

Marigold V2: Đột phá ước tính độ sâu từ ảnh đơn bằng kiến trúc Diffusion Transformer

Marigold V2 ứng dụng kiến trúc Diffusion Transformer để tối ưu hóa việc ước tính độ sâu, cho phép suy luận một bước với độ chính xác vượt trội trên các chi tiết phức tạp như lông thú hay tán lá, đồng thời giảm đáng kể chi phí vận hành.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cadence: Nén dữ liệu chuỗi thời gian có kiểm soát sai số bằng mô hình nền tảng

Cadence kết hợp mô hình TimesFM-3 với bộ mã hóa số học thích ứng để nén chuỗi thời gian, đảm bảo sai số nằm trong ngưỡng cho phép. Phương pháp này vượt trội hơn các thuật toán truyền thống như xz hay zstd nhờ khả năng tận dụng dự báo chính xác để tối ưu hóa dung lượng lưu trữ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giải mã tư duy Transformer: Khi nào mô hình thực sự hiểu trình độ của đối phương?

Nghiên cứu khám phá khoảng cách giữa việc mô hình nhận diện thông tin và thời điểm sử dụng chúng. Kết quả cho thấy dù mô hình sớm nhận diện được trình độ chuyên môn của đối tác, nhưng phải đến các lớp sâu hơn thông tin này mới thực sự tác động đến phản hồi.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tại sao AI vẫn cố trả lời những câu hỏi vô nghĩa? Nghiên cứu về sự lệch lạc trong nhận thức của LLM

Nghiên cứu chỉ ra rằng các mô hình ngôn ngữ lớn có khả năng nhận diện câu hỏi vô lý trước khi tạo văn bản, nhưng lại thất bại trong việc từ chối do sự lệch lạc giữa cơ chế nhận thức và cơ chế an toàn.

JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnMetaRSI-v1: Bước tiến đột phá cho phép AI tự tối ưu hóa 'cách thức tự cải thiện' của chính mình

MetaRSI-v1 là kiến trúc đầu tiên cho phép AI không chỉ tự cải thiện mô hình mà còn tự tiến hóa cả quy trình cải thiện đó. Công nghệ này giúp các mô hình nhỏ đạt hiệu suất vượt trội mà không cần giáo viên hướng dẫn, mở ra kỷ nguyên 'tự cải thiện bình phương'.


Vì sao đáng đọc: Đây là nghiên cứu mang tính đột phá về khả năng tự tiến hóa của AI, giải quyết giới hạn của các hệ thống RSI hiện tại. Nội dung có tính học thuật cao, tầm ảnh hưởng lớn đến tương lai của AGI.
IT Home
NgànhĐiểm AI 44/100

Viện Hàn lâm Khoa học Trung Quốc chế tạo robot cá đuối sinh học điều khiển bằng ánh sáng

Các nhà nghiên cứu đã phát triển robot cá đuối sử dụng cơ xương ếch làm bộ truyền động, đạt tốc độ bơi ấn tượng nhờ điều khiển bằng tia hồng ngoại gần. Công trình này thiết lập kỷ lục mới về tốc độ cho robot sinh học sử dụng mô cơ.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 44/100

Procedural Graphs: Cấu trúc tự tiến hóa cho tác nhân AI (LLM Agents)

Procedural Graphs tổ chức kiến thức dưới dạng các bộ ba (quy trình, quan hệ, quy trình), giúp mô hình LLM đưa ra quyết định thông minh bằng cách chuyển đổi đồ thị con thành hướng dẫn ngữ cảnh, thay vì ép buộc các bước thực thi cứng nhắc.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

Đột phá mới trong huấn luyện AI: Phương pháp OPRD giúp mô hình học sinh vượt mặt thầy giáo yếu

Phương pháp On-Policy Reverse Distillation (OPRD) cho phép mô hình AI học từ giáo viên yếu nhưng vẫn đạt hiệu suất vượt trội, nhờ cơ chế lọc và khuếch đại các cập nhật tối ưu từ trình xác thực.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 36/100

Mask Forcing: Tối ưu hóa chất lượng video AI bằng kỹ thuật che nhiễu kép

Phương pháp Mask Forcing giúp khắc phục tình trạng video bị bão hòa hoặc mờ nhòe trong các mô hình khuếch tán tự hồi quy bằng cách chèn các lớp mặt nạ ngẫu nhiên. Kỹ thuật này cải thiện đáng kể chất lượng hình ảnh mà không cần dữ liệu thực tế hay bước hậu huấn luyện phức tạp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cùng sự kiệnGE-Act 2.0: Bước tiến mới trong huấn luyện mô hình hành động thế giới cho robot

GE-Act 2.0 là mô hình hành động thế giới (WAM) được huấn luyện từ đầu với kiến trúc tối ưu, giúp robot thao tác chính xác hơn thông qua việc kết hợp lập kế hoạch hình ảnh và động lực học nghịch đảo.

Cùng sự kiện, bài đại diện «OpenWAM: Bước tiến mở và mô-đun hóa trong huấn luyện trước mô hình Thế giới - Hành động»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (61 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 11 | AIHOT.vn