Hôm qua · 27/09

Chủ Nhật · 2 tin
OpenAI Developers@OpenAIDevs
Mô hìnhĐiểm AI 36/100

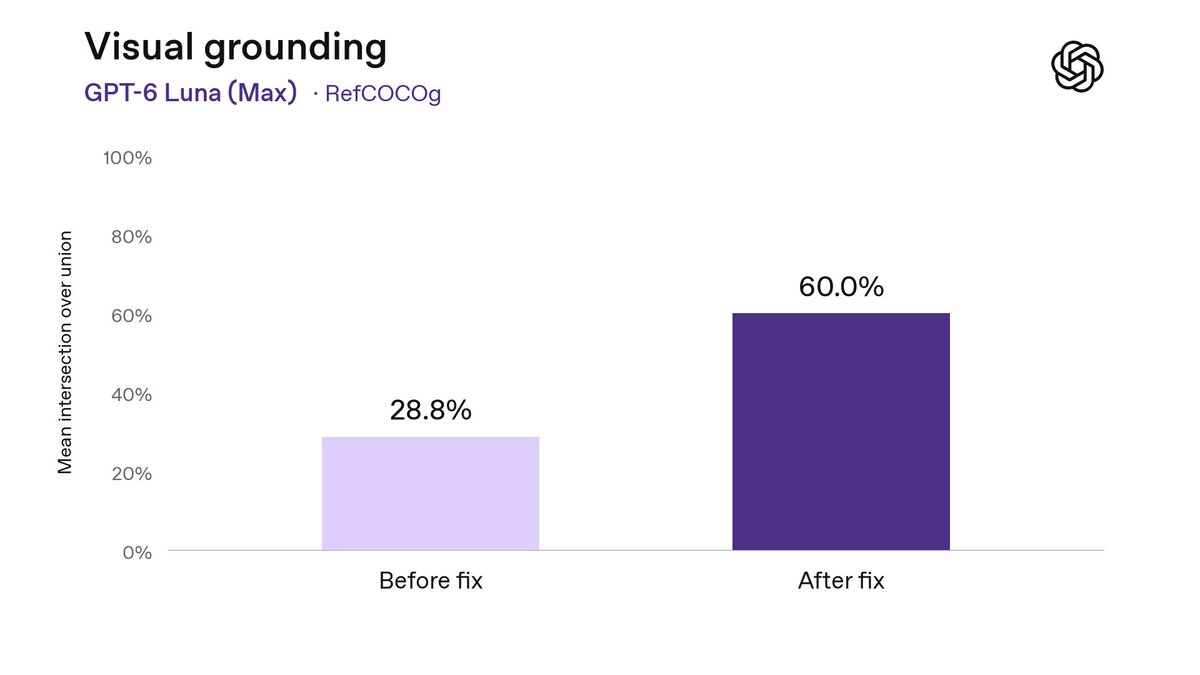
Cùng sự kiệnOpenAI khắc phục lỗi suy giảm khả năng hiểu hình ảnh trên GPT-6 Sol và GPT-6 Luna

We've fixed a bug that was degrading image understanding in GPT-6 Sol and GPT-6 Luna. You should now…

DịchOpenAI đã sửa lỗi kỹ thuật ảnh hưởng đến khả năng xử lý hình ảnh của GPT-6 Sol và GPT-6 Luna. Người dùng hiện có thể trải nghiệm kết quả chính xác hơn trên các tác vụ thị giác và tính năng computer use thông qua API và Codex.

Cùng sự kiện, tinh chọn hiển thị «Arena ra mắt thử nghiệm GPT-6 Sol và GPT-6 Luna, chuẩn bị công bố bảng xếp hạng»
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnCoRL 2026: LIFT giúp mô hình VLA 'cảm nhận' lực mà không cần dữ liệu tiền huấn luyện

Nhóm nghiên cứu từ ĐH Giao thông Thượng Hải giới thiệu LIFT, phương pháp cho phép mô hình VLA học cách phản ứng với lực thông qua hậu huấn luyện trực tuyến, giúp cải thiện đáng kể hiệu suất thao tác vật lý mà không làm mất đi kiến thức thị giác sẵn có.


Vì sao đáng đọc: Đột phá quan trọng trong robot học, giải quyết bài toán thiếu dữ liệu lực bằng cách tối ưu hóa hậu huấn luyện, được hội nghị CoRL 2026 uy tín công nhận.

26/09

Thứ Bảy · 4 tin
IT Home
Nghiên cứuĐiểm AI 48/100

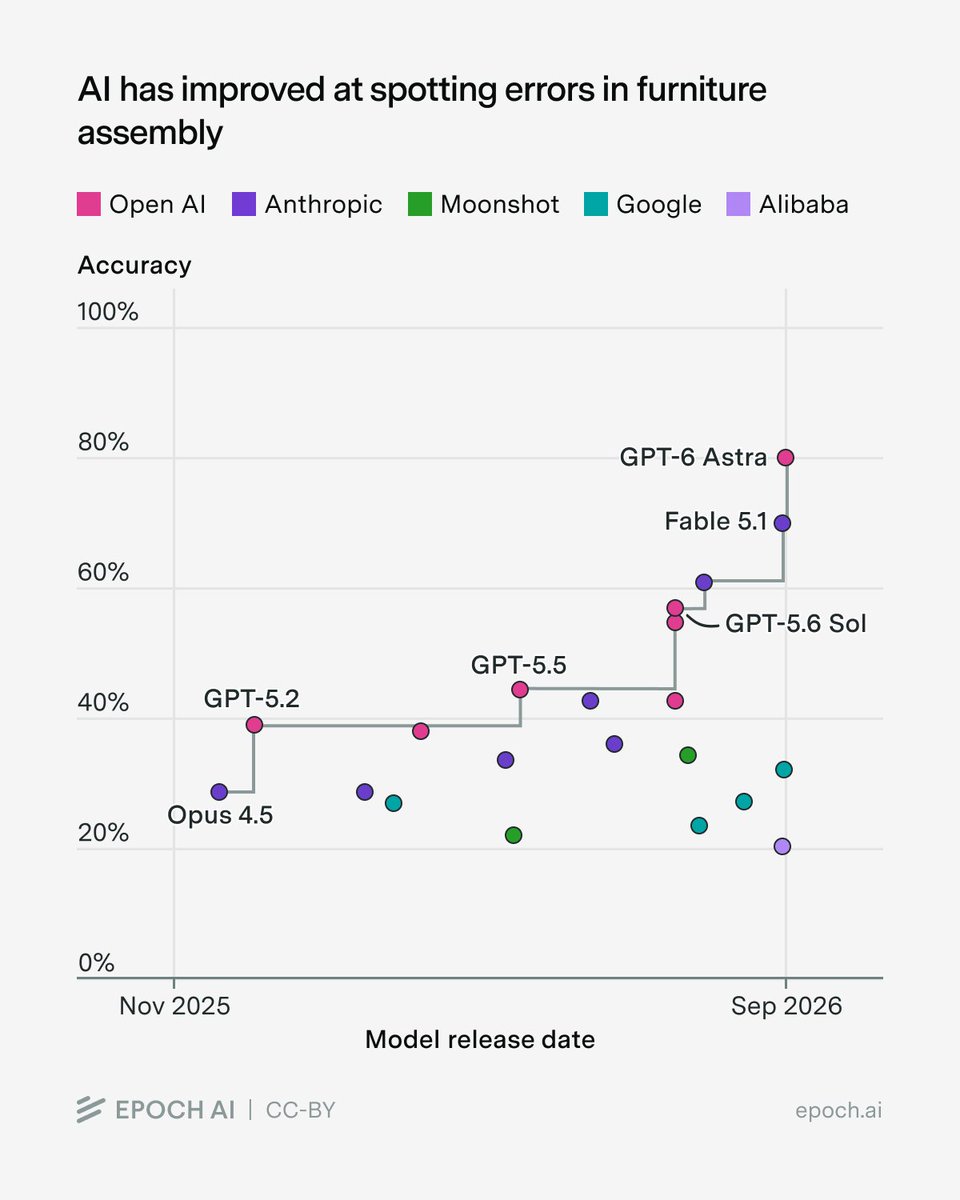
Cùng sự kiệnAI học cách 'bắt lỗi': GPT-6 Astra đạt 80% độ chính xác khi kiểm tra lắp ráp nội thất

Benchmark FAB từ Epoch AI cho thấy OpenAI GPT-6 Astra dẫn đầu với 80% độ chính xác trong việc phát hiện lỗi lắp ráp nội thất, vượt qua Claude Fable 5.1 (70%) và Claude Opus 5 (61%).

Cùng sự kiện, bài đại diện «GPT-6 Astra của OpenAI đạt độ chính xác 80% trong việc phát hiện lỗi lắp ráp nội thất IKEA»
The Decoder: AI News
Mô hìnhĐiểm AI 47/100

GPT-6 Astra của OpenAI đạt độ chính xác 80% trong việc phát hiện lỗi lắp ráp nội thất IKEA

GPT-6 Astra đã vượt qua bài kiểm tra Furniture Assembly Benchmark (FAB) của Epoch AI với độ chính xác 80%, giúp người dùng nhận diện chính xác các lỗi sai khi tự lắp ráp đồ nội thất IKEA chỉ trong 3 phút mỗi ảnh.

Thêm 1 nguồn khác đưa tinIT Home
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 31/100

RGBD20K: Bộ dữ liệu chuẩn quy mô lớn cho phân đoạn ngữ nghĩa RGB-D

RGBD20K cung cấp 20.000 cặp ảnh RGB-D với 160 lớp chi tiết, vượt xa các bộ dữ liệu cũ như NYUv2 hay SUN RGB-D. Nghiên cứu cũng giới thiệu phương pháp SPF giúp đạt hiệu suất SOTA trong phân đoạn ngữ nghĩa.

25/09

Thứ Sáu · 3 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

Tối ưu hóa tỷ lệ méo hình cho các chỉ số chất lượng ảnh toàn tham chiếu bằng ước tính Hessian ngẫu nhiên

Nghiên cứu giới thiệu IDQD-RDO, phương pháp sử dụng ước tính Hessian ngẫu nhiên để tối ưu hóa các chỉ số chất lượng ảnh như MS-SSIM và LPIPS trong mã hóa VVC, giúp tiết kiệm 14.2-36.7% BD-rate mà không cần thay đổi bộ giải mã.

Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 48/100

Trải nghiệm thực tế Space Bunny: Mô hình AI đột phá trong thiết kế 3D và tạo lập giao diện

Not sure what model Space Bunny is, but I am impressed. I had a chance to test it this week. It's …

DịchSpace Bunny gây ấn tượng với khả năng hiểu hình ảnh, hỗ trợ cửa sổ ngữ cảnh 1M token và tự kiểm chứng kết quả. Mô hình này xuất sắc trong việc chuyển đổi bản vẽ tay thành mã nguồn, tạo mô hình 3D, hoạt ảnh và các trò chơi tương tác.

24/09

Thứ Năm · 5 tin
Liquid AI Mô hình và Blog kỹ thuật (Web)
Mô hìnhĐiểm AI 57/100

Cùng sự kiệnLiquid AI ra mắt LFM2.5-VL-DSpark: Tăng tốc suy luận mô hình thị giác ngôn ngữ lên tới 3,13 lần

Liquid AI giới thiệu mô hình drafter LFM2.5-VL-DSpark với 280 triệu tham số, giúp tăng tốc độ giải mã trên thiết bị biên lên 3,13 lần và trên GPU lên 2,66 lần mà chỉ tốn thêm 8,9% tài nguyên.

Cùng sự kiện, bài đại diện «Liquid AI ra mắt LFM2.5-VL-DSpark: Tăng tốc suy luận cho mô hình đa phương thức»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

Tối ưu hóa khả năng khuếch tán trong không gian tiềm ẩn cao chiều với x0-prediction

Nghiên cứu giải quyết vấn đề suy giảm hiệu suất của các bộ mã hóa RAE bằng cách chuyển sang tham số hóa dữ liệu sạch (x0-prediction), giúp tập trung học tập vào cấu trúc đa tạp tín hiệu thay vì nhiễu, từ đó cải thiện đáng kể chất lượng tạo ảnh từ văn bản.

Thêm 1 nguồn khác đưa tinX: AK (@_akhaliq)
Epoch AI@EpochAIResearch
Nghiên cứuĐiểm AI 37/100

Epoch AI ra mắt FAB: Bộ tiêu chuẩn đánh giá khả năng lắp ráp nội thất của AI

Can AI tell if you've built your IKEA furniture wrong? Our new benchmark, the Furniture Assembly Ben…

DịchEpoch AI giới thiệu Furniture Assembly Benchmark (FAB), thử thách khả năng của AI trong việc phát hiện lỗi lắp ráp nội thất dựa trên hướng dẫn và hình ảnh thực tế. Hiệu suất của các mô hình đã tăng vọt từ 28% lên 80% chỉ trong 10 tháng.

Thêm 1 nguồn khác đưa tinX: Ethan Mollick (@emollick)

23/09

Thứ Tư · 7 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 37/100

StableVQ: Hướng dẫn thực tế tối ưu hóa huấn luyện bộ mã hóa Vector Quantization

StableVQ giới thiệu ba cải tiến kỹ thuật giúp giải quyết vấn đề mất ổn định khi huấn luyện bộ mã hóa-giải mã và codebook, từ đó nâng cao chất lượng tái tạo hình ảnh mà không cần thêm tham số học tập.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ScriptMoE: Bước tiến mới trong nhận diện văn bản đa ngôn ngữ với kiến trúc Mixture-of-Experts

Nghiên cứu giới thiệu ScriptMoE, mô hình nhận diện văn bản đa ngôn ngữ hiệu quả hơn các mô hình ngôn ngữ thị giác lớn (VLM) nhờ kiến trúc chuyên gia và bộ dữ liệu tổng hợp quy mô lớn TextMuSS-10M.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 82/100

Segment-Snap: Kết hợp hình học và ngữ nghĩa để hiểu tương tác trong không gian 3D

Segment-Snap là phương pháp mới giúp máy tính hiểu cách tương tác với vật thể 3D bằng cách liên kết các bộ phận chuyển động với tay cầm, giúp dự đoán chuyển động chính xác mà không cần huấn luyện bộ hồi quy phức tạp.

22/09

Thứ Ba · 9 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTAPe+ML: Kiến trúc thị giác máy tính siêu gọn nhẹ cho đa tác vụ

TAPe+ML v3 là hệ thống thị giác máy tính đột phá với chưa đầy 100.000 tham số, sử dụng lý thuyết nhận thức chủ động để xử lý hiệu quả các tác vụ phân loại, phát hiện vật thể và phân đoạn ảnh với độ chính xác ấn tượng.


Vì sao đáng đọc: Đột phá về hiệu suất khi đạt kết quả cao với số lượng tham số cực nhỏ, mở ra tiềm năng ứng dụng AI trên các thiết bị biên hạn chế tài nguyên.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ShieldVLA: Căn chỉnh an toàn dựa trên khả năng thực thi cho mô hình Thị giác-Ngôn ngữ-Hành động

ShieldVLA là khung tinh chỉnh mới giúp robot vận hành an toàn hơn bằng cách học hàm giá trị khả năng tiếp cận Hamilton-Jacobi trực tiếp từ dữ liệu hình ảnh, giúp phân tách tối ưu hóa phần thưởng và vùng hoạt động an toàn.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKỷ nguyên mới của AI tạo sinh: Đại học Fudan và Wan công bố tổng quan đầu tiên về Agentic Visual Generation

Nhóm nghiên cứu từ Fudan, Wan và CUHK đã công bố bài tổng quan toàn diện về Agentic Visual Generation, thiết lập khung phân loại mới cho các hệ thống AI có khả năng tự ra quyết định, chỉnh sửa và học hỏi kinh nghiệm trong quá trình tạo nội dung thị giác.


Vì sao đáng đọc: Đây là bài tổng quan hệ thống đầu tiên về một hướng đi quan trọng trong AI. Nội dung mang tính học thuật cao, có khung phân loại rõ ràng, rất hữu ích cho giới nghiên cứu và phát triển.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Mira-Scene: Giải pháp tái tạo cảnh 3D từ ảnh đơn thông qua ánh xạ tọa độ điểm ảnh

Mira-Scene là khung tái tạo cảnh 3D mới, sử dụng bản đồ tọa độ chính tắc (CCM) để ánh xạ điểm ảnh vào không gian vật thể, giúp sắp xếp các đối tượng 3D vào cảnh một cách chính xác và chi tiết hơn so với các phương pháp truyền thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnGrounded Action Model: Đưa nhận thức không gian 3D vào nền tảng điều khiển robot

Grounded Action Model (GAM) là mô hình robot mới giúp máy móc hiểu rõ vị trí và hình học 3D của vật thể thay vì chỉ học ngầm định từ dữ liệu, giúp việc điều khiển chính xác và hiệu quả hơn thông qua các lệnh ngôn ngữ hoặc hình ảnh.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong robotics, giải quyết điểm yếu về nhận thức không gian của các mô hình VLA hiện nay, có tính ứng dụng thực tiễn cao trong tự động hóa.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnHuRo: Chuyển đổi video hành động của người thành dữ liệu huấn luyện robot quy mô lớn

HuRo là phương pháp mới giúp chuyển đổi video hành động của con người thành dữ liệu điều khiển robot, tạo ra tập dữ liệu khổng lồ với 630.000 tập mẫu để huấn luyện các mô hình VLA hiệu quả hơn.


Vì sao đáng đọc: Nghiên cứu giải quyết bài toán thiếu hụt dữ liệu robot bằng cách tận dụng kho video con người khổng lồ, có tiềm năng lớn trong việc thúc đẩy khả năng học tập của robot.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

WorldCrafter: Mô hình thế giới video với khả năng ghi nhớ không gian 3D ẩn

WorldCrafter giải quyết vấn đề thiếu nhất quán trong video dài bằng cách sử dụng bộ nhớ 3D ẩn, cho phép tạo video từ ảnh hoặc văn bản với độ chính xác cao về góc quay và bối cảnh.

Thêm 1 nguồn khác đưa tinX: AK (@_akhaliq)
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnACM Multimedia 2026: ForgeryVCR - Bước tiến mới trong xác thực hình ảnh bằng suy luận thị giác

Các nhà nghiên cứu từ Tencent và Đại học Thâm Quyến giới thiệu ForgeryVCR, một khung tác tử AI giúp chuyển đổi việc xác thực hình ảnh từ mô tả văn bản sang suy luận dựa trên bằng chứng thị giác trực tiếp, giúp phát hiện ảnh giả mạo chính xác hơn.


Vì sao đáng đọc: Nghiên cứu đột phá được chấp nhận tại hội nghị hàng đầu ACM Multimedia 2026, giải quyết vấn đề cấp thiết về xác thực nội dung trong kỷ nguyên AI tạo sinh.

21/09

Thứ Hai · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RefineEdit: Chỉnh sửa ảnh bằng văn bản không cần huấn luyện thông qua mạng tinh chỉnh thế hệ

RefineEdit là khung chỉnh sửa ảnh mới giúp thay đổi nội dung theo yêu cầu mà vẫn giữ nguyên các chi tiết gốc, bằng cách kết hợp định vị chỉnh sửa với tạo nội dung thông qua mã nhị phân toàn cục mà không cần huấn luyện lại.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OmniVChat: Bước tiến mới trong đối thoại đa phương thức trực tiếp qua âm thanh và hình ảnh

OmniVChat giới thiệu phương thức tương tác trực tiếp giữa người dùng và mô hình AI thông qua âm thanh và video mà không cần chuyển đổi văn bản, giúp giảm độ trễ và giữ trọn vẹn các tín hiệu cảm nhận.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 75/100

Tối ưu hóa mã hóa thưa tích chập thích ứng qua nút thắt thông tin cho biểu diễn thị giác

Nghiên cứu đề xuất khung mã hóa thưa tích chập (CSC) có khả năng tự học hệ số thưa thông qua thuật toán FISTA, giúp cân bằng hiệu quả giữa việc nén dữ liệu và bảo toàn thông tin quan trọng cho các tác vụ thị giác máy tính.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnMintAct: Tác nhân thị giác hợp nhất cho mọi môi trường kỹ thuật số

MintAct là dòng mô hình ngôn ngữ-thị giác đa quy mô, có khả năng điều hướng và sử dụng công cụ trên cả di động, máy tính và web với hiệu suất tương đương các chuyên gia riêng biệt.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc tạo ra tác nhân AI đa năng, giải quyết bài toán khó về tính đồng nhất giữa các nền tảng khác nhau với hạ tầng RL quy mô lớn.

20/09

Chủ Nhật · 3 tin
AK@_akhaliq
Mô hìnhĐiểm AI 36/100

Cùng sự kiệnMô hình Qwen-Image-2.1 chính thức có mặt trên Hugging Face

Qwen-Image-2.1 is out on Hugging Face app: https://huggingface.co/spaces/akhaliq/Qwen-Image-2.1

DịchMô hình xử lý hình ảnh Qwen-Image-2.1 vừa được ra mắt trên nền tảng Hugging Face, cho phép người dùng trải nghiệm trực tiếp các tính năng mới nhất.

Cùng sự kiện, tinh chọn hiển thị «Alibaba ra mắt Qwen-Image-2.1: Mô hình 7B tích hợp tạo và chỉnh sửa ảnh trong một checkpoint»
IT Home
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnAlibaba ra mắt Qwen-Image-2.1: Mô hình tạo ảnh mã nguồn mở hỗ trợ ảnh trong suốt và đa tham chiếu

Qwen-Image-2.1 tích hợp tạo và chỉnh sửa ảnh trong một mô hình 7B nhỏ gọn, hỗ trợ tạo ảnh nền trong suốt và sử dụng tới 10 ảnh tham chiếu để giữ độ trung thực cho sản phẩm và nhân vật.

Cùng sự kiện, tinh chọn hiển thị «Alibaba ra mắt Qwen-Image-2.1: Mô hình 7B tích hợp tạo và chỉnh sửa ảnh trong một checkpoint»
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnVBVR-Pro: Hệ thống huấn luyện và đánh giá toàn diện khả năng suy luận thị giác cho mô hình AI

VBVR-Pro cung cấp bộ 300 tác vụ suy luận thị giác cùng cơ chế chấm điểm tự động, giúp tối ưu hóa khả năng tư duy không gian và logic cho các mô hình đa phương thức thông qua học tăng cường.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng từ các đại học hàng đầu, giải quyết bài toán cốt lõi về khả năng suy luận thị giác thay vì chỉ nhận diện hình ảnh đơn thuần, có tính ứng dụng cao.

19/09

Thứ Bảy · 1 tin

18/09

Thứ Sáu · 6 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnTPAMI 2026: PolaFormer++ nâng tầm cơ chế chú ý tuyến tính với tính toán phân cực và độ nhọn cấp kênh

PolaFormer++ cải tiến cơ chế chú ý tuyến tính bằng cách tối ưu hóa ánh xạ đặc trưng thông qua tính toán phân cực và độ nhọn cấp kênh, giúp đạt hiệu suất vượt trội trên nhiều tác vụ thị giác máy tính.


Vì sao đáng đọc: Nghiên cứu được đăng trên tạp chí uy tín TPAMI, giải quyết bài toán cốt lõi về hiệu suất của Transformer, có mã nguồn mở và tính ứng dụng cao trong xử lý dữ liệu lớn.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (74 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Thị giác máy tính” | AIHOT.vn