26/09

Thứ Bảy · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnV-Rubrics: Tối ưu hóa học tăng cường đa phương thức với 350.000 tiêu chí đánh giá chi tiết

V-Rubrics giải quyết vấn đề 'phân bổ tín dụng' trong mô hình đa phương thức bằng cách chia nhỏ đánh giá thành các tiêu chí chi tiết, giúp mô hình học từ cả những suy luận đúng ngay cả khi kết quả cuối cùng sai.


Vì sao đáng đọc: Nghiên cứu quan trọng được chấp nhận tại EMNLP 2026, giải quyết bài toán hóc búa trong huấn luyện mô hình đa phương thức bằng phương pháp đánh giá phân đoạn sáng tạo.

25/09

Thứ Sáu · 4 tin
Clément Delangue (Hugging Face CEO)@ClementDelangue
Mô hìnhĐiểm AI 49/100

Hugging Face ra mắt SmolDataEnvs: 5.000 tác vụ RL giúp huấn luyện mô hình nhỏ

Super happy to release SmolDataEnvs: 5, 000 verifiable RL environment tasks for hill-climbing small m…

DịchHugging Face vừa công bố SmolDataEnvs, bộ dữ liệu gồm 5.000 tác vụ học tăng cường (RL) có thể kiểm chứng, hỗ trợ tối ưu hóa các mô hình AI nhỏ trong lĩnh vực khoa học dữ liệu và lập trình.

QbitAI
Mô hìnhĐiểm AI 88/100

Tinh chọn“AlphaGo” phiên bản bóng đá: Robot tự luyện tập 140 năm để trở thành “khắc tinh của Messi”

Các nhà nghiên cứu đã huấn luyện robot thông qua mô phỏng tự đối kháng tương đương 140 năm, giúp chúng đạt kỹ năng chơi bóng đỉnh cao và khả năng phòng ngự vượt trội trước các cầu thủ chuyên nghiệp.


Vì sao đáng đọc: Tin tức thú vị về ứng dụng học tăng cường trong robot học, cho thấy bước tiến lớn trong việc chuyển đổi từ môi trường ảo sang thực tế.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

AV-GRPO: Khung học tăng cường khuếch tán tách biệt đa phương thức cho tạo video-âm thanh đồng bộ

AV-GRPO là khung học tăng cường khuếch tán trực tuyến giúp tách biệt các ưu tiên đa phương thức thành bài toán đơn lẻ, tối ưu hóa sự đồng bộ giữa âm thanh và hình ảnh. Kết quả thực nghiệm trên JavisBench và VABench cho thấy hiệu suất vượt trội so với LTX-2.3 trong việc căn chỉnh ngữ nghĩa và chất lượng tạo nội dung.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

Jev: Mô hình RLCD giúp phát hiện lỗi căn chỉnh AI chỉ với một lần truy vấn

Jev sử dụng kỹ thuật RLCD để trả lời đa câu hỏi và đưa ra xác suất tin cậy trong một lần gọi, đạt hiệu suất vượt trội với AUROC 0.886 trong việc phát hiện lỗi căn chỉnh AI mà không cần huấn luyện lại.

24/09

Thứ Năm · 8 tin
Tencent Hunyuan@TencentHunyuan
Nghiên cứuĐiểm AI 40/100

Cùng sự kiệnTencent Hunyuan: Nghiên cứu tối ưu hóa kích thước batch trong học tăng cường cho LLM

⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…

DịchNghiên cứu từ Tencent Hunyuan cho thấy việc điều chỉnh learning rate giúp tăng hiệu suất huấn luyện GRPO và PPO, giúp tăng tốc độ xử lý lên 2,29 lần và tiết kiệm 29% thời gian huấn luyện.

Cùng sự kiện, bài đại diện «Tencent Hunyuan: Nghiên cứu mở rộng kích thước batch trong học tăng cường LLM»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 47/100

VHD-Play: Tạo môi trường RL cho tác nhân AI từ các cơ chế đã giải, giúp Qwen3.6-35B-A3B tăng điểm từ 0.204 lên 0.815

VHD-Play giới thiệu quy trình tạo môi trường RL bằng cách mô hình hóa toán học và chuyển đổi thành các công cụ có trạng thái, giúp huấn luyện tác nhân hiệu quả với chi phí cực thấp.

Tencent Hunyuan@TencentHunyuan
Nghiên cứuĐiểm AI 39/100

Tencent Hunyuan: Nghiên cứu mở rộng kích thước batch trong học tăng cường LLM

⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…

DịchNhóm nghiên cứu Tencent Hunyuan tối ưu hóa học tăng cường cho LLM bằng cách mở rộng kích thước batch, giúp tăng tốc độ xử lý của PPO lên 2,29 lần và rút ngắn 29% thời gian huấn luyện GRPO mà vẫn đảm bảo hiệu suất.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RewardVerse: Tối ưu hóa chính sách dựa trên tiêu chí đánh giá cho mô hình tạo video

RewardVerse giải quyết vấn đề điểm số không ổn định trong mô hình tạo video bằng cách sử dụng hệ thống đánh giá dựa trên tiêu chí (rubric), giúp việc chấm điểm trở nên nhất quán và đáng tin cậy hơn cho học tăng cường.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

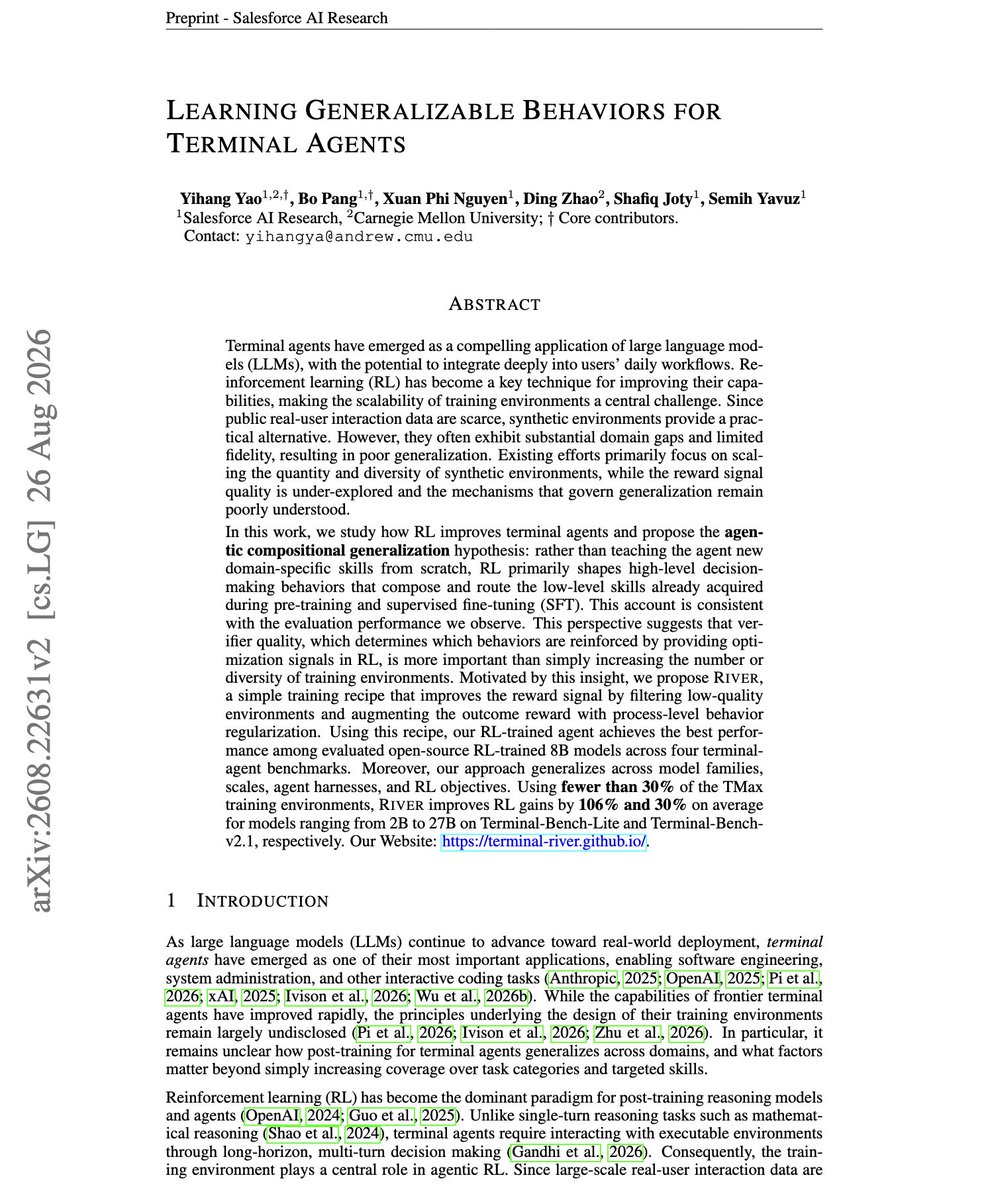
Nghiên cứu từ Salesforce: Chất lượng trình xác thực quyết định hiệu quả huấn luyện AI

Impressive paper from Salesforce. It discusses the importance of good verifiers for RL environments…

DịchNghiên cứu của Salesforce chỉ ra rằng chất lượng trình xác thực môi trường RL là yếu tố then chốt. Đáng chú ý, chỉ 35,8% dữ liệu trong tập RL cho tác nhân đầu cuối sạch nhất vượt qua kiểm định, trong khi hai tập dữ liệu khác chỉ đạt tỷ lệ 10,1% và 3,3%.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Đã có đại diệnDeepSeek công bố nghiên cứu mới: DSec - Hạ tầng Sandbox cho huấn luyện Agent quy mô lớn

DeepSeek vừa giới thiệu DSec, nền tảng sandbox sản xuất giúp quản lý hàng triệu instance Agent mỗi ngày, đóng vai trò then chốt trong quá trình huấn luyện RL từ phiên bản DeepSeek V3.2 đến V4.1.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek công bố nghiên cứu mới về huấn luyện Agent với sự tham gia của Lương Văn Phong»

23/09

Thứ Tư · 4 tin
TechNode
Nghiên cứuĐiểm AI 88/100

Cùng sự kiệnDeepSeek công bố chi tiết hạ tầng DSec phục vụ huấn luyện AI Agent

DeepSeek vừa giới thiệu DSec, nền tảng sandbox quy mô lớn giúp hợp nhất các môi trường thực thi như container và VM để tối ưu hóa quá trình huấn luyện AI Agent thông qua học tăng cường.

Cùng sự kiện, bài đại diện «DeepSeek công bố DSec: Nền tảng sandbox tính toán đàn hồi cho huấn luyện AI Agent»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Bellman Policy Optimization: Phương pháp tối ưu hóa mới giúp LLM suy luận toán học chính xác hơn

Bellman Policy Optimization (BPO) là phương pháp huấn luyện mô hình ngôn ngữ không cần critic, giúp tối ưu hóa khả năng suy luận thông qua các phần thưởng cuối cùng mà không cần ước tính giá trị trạng thái trung gian.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RULER: Phương pháp đánh giá và tối ưu hóa mới cho việc tạo hình ảnh vector (SVG) bằng AI

RULER giải quyết vấn đề thiếu tiêu chuẩn đánh giá trong tạo mã SVG bằng cách sử dụng hệ thống chấm điểm đa tiêu chí dựa trên mô hình ngôn ngữ thị giác, giúp tối ưu hóa mô hình học tăng cường hiệu quả hơn so với các chỉ số truyền thống.

22/09

Thứ Ba · 12 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

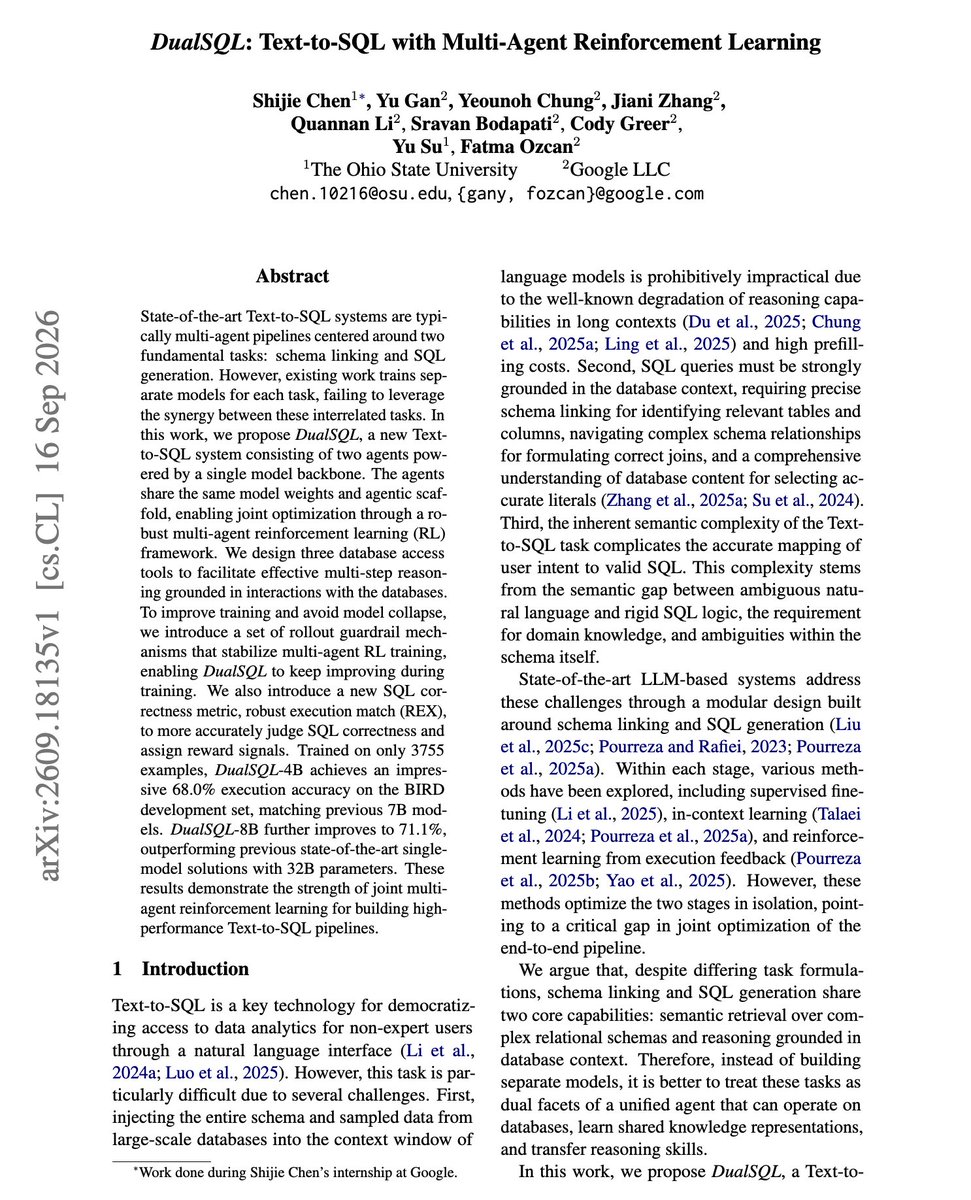
Google giới thiệu DualSQL: Sử dụng học tăng cường đa tác nhân để tối ưu hóa Text-to-SQL

Great paper from Google and colleagues. Trains Text-to-SQL agents using multi-agent RL. (bookmark …

DịchDualSQL chia nhiệm vụ Text-to-SQL thành hai tác nhân phối hợp, giúp mô hình 4B đạt hiệu suất tương đương các mô hình 7B hiện có trên tập dữ liệu BIRD, tối ưu hóa đáng kể tài nguyên tính toán.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ShieldVLA: Căn chỉnh an toàn dựa trên khả năng thực thi cho mô hình Thị giác-Ngôn ngữ-Hành động

ShieldVLA là khung tinh chỉnh mới giúp robot vận hành an toàn hơn bằng cách học hàm giá trị khả năng tiếp cận Hamilton-Jacobi trực tiếp từ dữ liệu hình ảnh, giúp phân tách tối ưu hóa phần thưởng và vùng hoạt động an toàn.

TechNode
Mô hìnhĐiểm AI 85/100

Xiaomi mã nguồn mở dòng mô hình MiMo-V2.6 sau khi tối ưu hóa học tăng cường

Xiaomi vừa công bố mã nguồn mở bộ mô hình MiMo-V2.6, bao gồm các phiên bản Pro và Flash với khả năng đa phương thức mạnh mẽ, vượt qua nhiều đối thủ trong các bài kiểm tra hiệu năng nhờ ứng dụng học tăng cường quy mô lớn.

Thêm 4 nguồn khác đưa tinThe Decoder: AI NewsXiaomi MiMo: Phát hành và blog chính thứcWeChat: Carl AI WattsWeChat: Khazix
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 42/100

VideoGen-Agent: Đột phá mới trong việc huấn luyện tác nhân AI tạo video bằng học tăng cường

VideoGen-Agent sử dụng học tăng cường đa nhiệm để điều phối các công cụ bên ngoài, giúp tối ưu hóa quy trình tạo video. Giải pháp này đã cải thiện đáng kể hiệu suất của các mô hình văn bản-thành-video trên bộ tiêu chuẩn VABench mới.

Pandaily
Mô hìnhĐiểm AI 85/100

Cùng sự kiệnXiaomi mã nguồn mở MiMo-V2.6 Pro và bộ công cụ huấn luyện RL chuyên sâu

Xiaomi vừa công bố mã nguồn mở cho MiMo-V2.6-Pro cùng bộ trọng số Flash, đi kèm mã nguồn RL và hơn 7.000 môi trường tác vụ, cho phép cộng đồng tải về và tự triển khai thay vì chỉ xem qua trình diễn trực tuyến.

Cùng sự kiện, bài đại diện «Xiaomi MiMo-V2.6-Pro: Bước tiến mới trong tối ưu hóa nghiên cứu vật liệu»
AK@_akhaliq
Nghiên cứuĐiểm AI 23/100

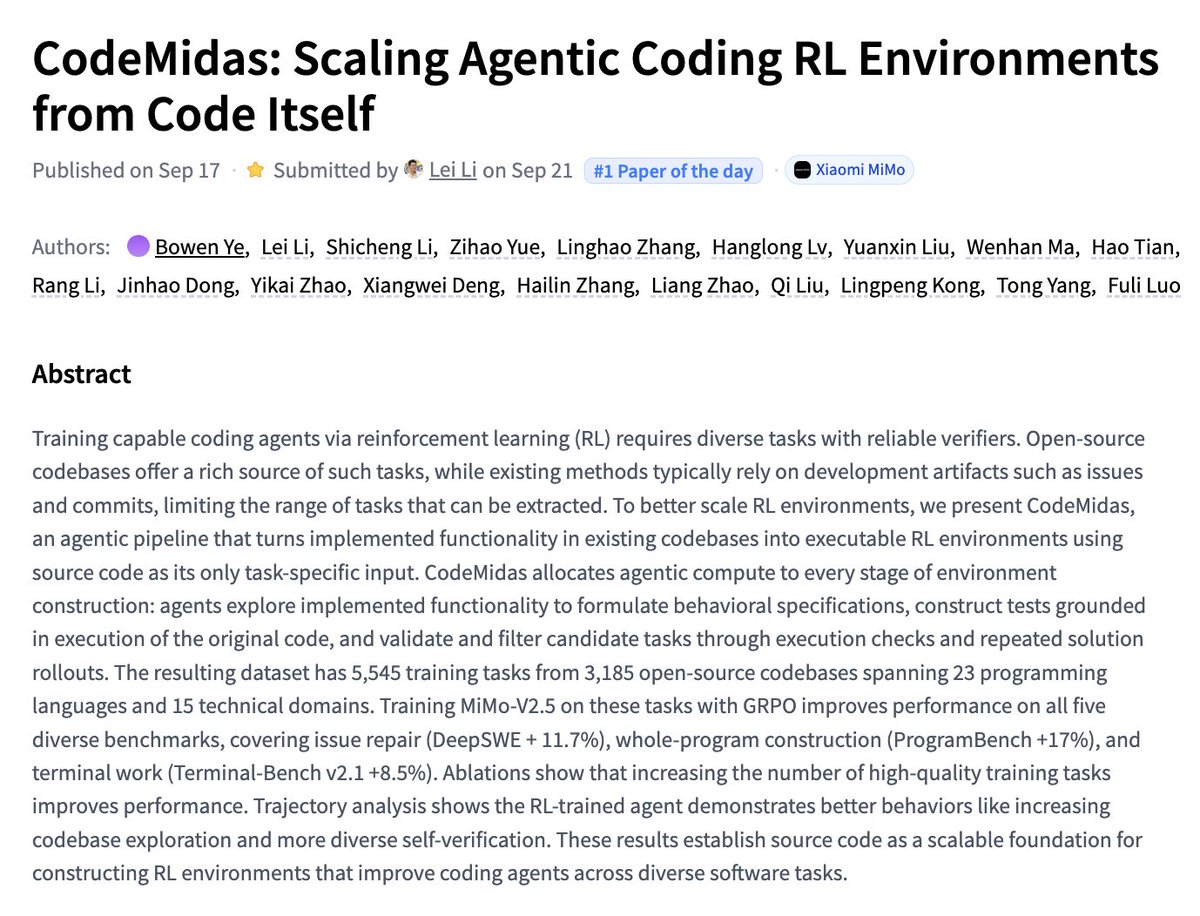
CodeMidas: Mở rộng môi trường học tăng cường cho lập trình tác nhân từ chính mã nguồn

CodeMidas Scaling Agentic Coding RL Environments from Code Itself paper: https://huggingface.co/pa...

DịchCodeMidas giới thiệu phương pháp mới giúp mở rộng môi trường học tăng cường (RL) cho các tác nhân lập trình bằng cách khai thác trực tiếp cấu trúc của mã nguồn, tối ưu hóa khả năng tự học và thực thi tác vụ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnSteerDuplex: Mô hình hội thoại giọng nói song công có khả năng tùy biến linh hoạt

SteerDuplex là mô hình hội thoại song công (full-duplex) đột phá, cho phép người dùng điều chỉnh linh hoạt tông giọng, phong cách và tốc độ nói thông qua các hướng dẫn trực tiếp, giúp tương tác tự nhiên và thông minh hơn.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề quan trọng về khả năng tùy biến trong hội thoại thời gian thực, kết hợp kỹ thuật RL tiên tiến, rất có giá trị cho tương lai của trợ lý ảo.
Luo Fuli@_LuoFuli
Mô hìnhĐiểm AI 70/100

Cùng sự kiệnXiaomi ra mắt MiMo-V2.6: Bước tiến đột phá trong huấn luyện RL quy mô lớn

MiMo-V2.6: The Hard Road to Scaling Up RL MiMo-V2.6 is very likely one of the largest single RL run…

DịchXiaomi vừa công bố MiMo-V2.6, mô hình mã nguồn mở mạnh mẽ nhất hiện nay nhờ tối ưu hóa quy trình học tăng cường (RL) quy mô lớn. Đội ngũ cũng chia sẻ khung huấn luyện RL, bộ dữ liệu đa dạng và các mô hình Qwen được chưng cất từ quỹ đạo RL của MiMo.

Cùng sự kiện, bài đại diện «Xiaomi MiMo-V2.6-Pro: Bước tiến mới trong tối ưu hóa nghiên cứu vật liệu»
WeChat: Xiaomi MiMo
Mô hìnhĐiểm AI 74/100

Tinh chọnXiaomi ra mắt và mã nguồn mở dòng MiMo-V2.6: Bước tiến mới trong tự cải thiện mô hình AI

Xiaomi chính thức công bố và mã nguồn mở dòng MiMo-V2.6, bao gồm hai phiên bản Pro và Flash, đánh dấu bước ngoặt quan trọng trong việc ứng dụng kỹ thuật tự cải thiện đệ quy (RSI) để mở rộng quy mô học tăng cường.

Thêm 7 nguồn khác đưa tinX: OpenRouter (@OpenRouter)WeChat: Carl AI WattsTechNodeWeChat: KhazixXiaomi MiMo: Phát hành và blog chính thứcX: Nathan Lambert (@natolambert)X: Xiaomi MiMo (@XiaomiMiMo)

Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng từ một tập đoàn công nghệ lớn, việc mã nguồn mở giúp cộng đồng nghiên cứu tiếp cận sâu hơn với hướng đi tự cải thiện (RSI).
Nathan Lambert@natolambert
Mô hìnhĐiểm AI 66/100

Cùng sự kiệnXiaomi ra mắt dòng MiMo-V2.6: Đột phá với mô hình 1.02T tham số và khả năng tự cải tiến

MiMo-V2.6-Pro: 1.02T-42B active MiMo-V2.6-Flash: 310B-15B active Top open model on Artificial Analys…

DịchXiaomi vừa công bố dòng MiMo-V2.6 với các phiên bản Pro và Flash, tập trung vào khả năng tự cải tiến thông qua học tăng cường (RL) quy mô lớn và hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token.

Cùng sự kiện, tinh chọn hiển thị «Xiaomi ra mắt MiMo-V2.6-Pro: Lọt Top 10 bảng xếp hạng lập trình WebDev»
Nathan Lambert@natolambert
Sản phẩmĐiểm AI 48/100

Cùng sự kiệnXiaomi ra mắt MiMo V2.6: Công khai mã nguồn bảng điều khiển RL cho các mô hình AI

Real open model nerds knew Xiaomi is cooking with MiMo! An open RL dashboard for the top scoring ope…

DịchXiaomi vừa chính thức phát hành và mở mã nguồn MiMo V2.6, cung cấp bảng điều khiển học tăng cường (RL) chuyên dụng cho các mô hình mã nguồn mở hàng đầu, đánh dấu bước tiến lớn trong hệ sinh thái AI của hãng.

Cùng sự kiện, tinh chọn hiển thị «Xiaomi ra mắt và mã nguồn mở dòng MiMo-V2.6: Bước tiến mới trong tự cải thiện mô hình AI»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

PARTS: Tối ưu hóa robot thông qua học tăng cường trên các tác vụ phụ khó

PARTS là khung làm việc giúp robot tự học cách vượt qua các điểm nghẽn trong những tác vụ dài mà không cần con người can thiệp toàn bộ, bằng cách tập trung huấn luyện học tăng cường vào các bước phụ cụ thể thay vì toàn bộ quy trình.

21/09

Thứ Hai · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnCodeMidas: Tự động hóa tạo môi trường học tăng cường cho AI lập trình từ mã nguồn

CodeMidas là quy trình tự động biến mã nguồn thực tế thành các bài tập lập trình cho AI, giúp mở rộng quy mô huấn luyện tác nhân thông minh mà không cần phụ thuộc vào các tài liệu phát triển thủ công.

Thêm 1 nguồn khác đưa tinX: AK (@_akhaliq)

Vì sao đáng đọc: Giải quyết bài toán hóc búa về dữ liệu huấn luyện cho AI lập trình bằng cách tận dụng kho mã nguồn khổng lồ, có tiềm năng lớn trong việc nâng cao khả năng tự học của AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnMintAct: Tác nhân thị giác hợp nhất cho mọi môi trường kỹ thuật số

MintAct là dòng mô hình ngôn ngữ-thị giác đa quy mô, có khả năng điều hướng và sử dụng công cụ trên cả di động, máy tính và web với hiệu suất tương đương các chuyên gia riêng biệt.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc tạo ra tác nhân AI đa năng, giải quyết bài toán khó về tính đồng nhất giữa các nền tảng khác nhau với hạ tầng RL quy mô lớn.

20/09

Chủ Nhật · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnVBVR-Pro: Hệ thống huấn luyện và đánh giá toàn diện khả năng suy luận thị giác cho mô hình AI

VBVR-Pro cung cấp bộ 300 tác vụ suy luận thị giác cùng cơ chế chấm điểm tự động, giúp tối ưu hóa khả năng tư duy không gian và logic cho các mô hình đa phương thức thông qua học tăng cường.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng từ các đại học hàng đầu, giải quyết bài toán cốt lõi về khả năng suy luận thị giác thay vì chỉ nhận diện hình ảnh đơn thuần, có tính ứng dụng cao.

19/09

Thứ Bảy · 2 tin
Haider@haider1
Quan điểmĐiểm AI 32/100

Jeff Dean: Học tăng cường (RL) sẽ rút ngắn chu kỳ thiết kế chip từ 2 năm xuống còn 3 tháng

Jeff Dean says: "if you speed up chip design loops enough for RL to search them, you can compress t…

DịchJeff Dean khẳng định việc ứng dụng RL vào thiết kế chip giúp tối ưu hóa quy trình, cho phép một nhóm nhỏ 10 người hoàn thành công việc trong 3 tháng thay vì 150 người trong 2 năm, thúc đẩy kỷ nguyên phần cứng chuyên dụng.

Nathan Lambert@natolambert
Quan điểmĐiểm AI 24/100

Phòng thí nghiệm nào sẽ là đơn vị đầu tiên vô tình 'hack' vào doanh nghiệp khi huấn luyện AI?

Who's gonna be the first academic lab to accidentally hack a company during RL or eval. That's gotta…

DịchNathan Lambert đặt câu hỏi thú vị về việc liệu một phòng thí nghiệm học thuật có vô tình xâm nhập vào hệ thống doanh nghiệp trong quá trình huấn luyện tăng cường (RL) hoặc đánh giá mô hình hay không, coi đây là một cột mốc đáng chú ý hơn cả các giải thưởng học thuật.

18/09

Thứ Sáu · 6 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

ActObs: Tối ưu hóa hành vi khám phá của tác nhân AI thông qua giám sát quan sát trong RL

Nghiên cứu giới thiệu ActObs, phương pháp giám sát các token quan sát trong giai đoạn SFT mà không làm tăng dữ liệu hay chi phí tính toán, giúp cải thiện khả năng khám phá của tác nhân trong học tăng cường.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

RetireOPD: Phương pháp chưng cất chính sách tự động giải phóng cho tác nhân học tăng cường

RetireOPD giới thiệu cơ chế tự động loại bỏ giáo viên khi học sinh đạt ngưỡng hiệu suất, giúp tối ưu hóa quá trình huấn luyện tác nhân thông qua việc kết hợp học tăng cường và chưng cất chính sách.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

Vision-RL2: Tối ưu hóa chiến lược cấp vùng cho mô hình ngôn ngữ đa phương thức (MLLM)

Vision-RL2 sử dụng học tăng cường cấp vùng để tối ưu hóa mạng đề xuất khu vực trong MLLM mà không cần nhãn dữ liệu, giúp cải thiện độ chính xác vượt trội với số lượng token thị giác ít hơn gấp 4 lần.

karminski@karminski3
Mô hìnhĐiểm AI 40/100

Cùng sự kiệnMô hình Jev: Từ bỏ tự hồi quy, tối ưu hóa quyết định bằng RLCD

Jev loại bỏ kiến trúc tự hồi quy truyền thống để tập trung vào đầu ra có cấu trúc thông qua kỹ thuật RLCD, giúp đưa ra các quyết định chính xác với độ tin cậy cao, thay vì tạo văn bản thông thường.

Cùng sự kiện, bài đại diện «Simon Willison đánh giá Jev: Mô hình ra quyết định thế hệ mới từ TypeSafe AI»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnKhi ngón tay trở thành đôi chân: Robot bàn tay tự di chuyển và thao tác linh hoạt

Nghiên cứu giới thiệu cách huấn luyện bàn tay robot sử dụng chính các ngón tay để di chuyển, giữ thăng bằng và thực hiện thao tác phức tạp mà không cần dây dẫn, mở ra hướng đi mới cho robot tự hành nhỏ gọn.


Vì sao đáng đọc: Đột phá thú vị trong việc kết hợp di chuyển và thao tác trên cùng một cơ cấu, ứng dụng học tăng cường hiệu quả trên phần cứng thực tế.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (62 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Học tăng cường” | AIHOT.vn