Super interesting paper from Google and colleagues. It studies where it's possible to distill an ag…
DịchNhóm nghiên cứu từ Đại học Bắc Kinh, Google và HKUST giới thiệu Harness-Zero, phương pháp chưng cất khả năng 'agent-as-harness' để tối ưu hóa phản hồi của mô hình trong không gian hành động mục tiêu thông qua dữ liệu huấn luyện tinh chỉnh.
DịchKhám phá kỹ thuật chưng cất tri thức từ các mô hình ngôn ngữ lớn (LLM) áp dụng theo phương pháp Jev, nhằm tối ưu hóa hiệu suất và giảm tài nguyên tính toán.
Baseten Base Labs công bố nghiên cứu so sánh hiệu quả giữa huấn luyện trực tiếp GRPO và phương pháp chưng cất qua SFT với giáo viên gpt-5.6-sol trên các dòng mô hình Qwen3, thử nghiệm qua 16 tác vụ suy luận.
The biggest disagreement JSD and I had in this podcast was on the impact of distillation. In our res…
DịchTrong podcast mới nhất, Nathan Lambert và chuyên gia từ Epoch AI đã có những bất đồng quan điểm sâu sắc về việc liệu kỹ thuật chưng cất (distillation) có thực sự giúp các phòng thí nghiệm AI tại Trung Quốc vượt qua rào cản hạn chế chip hay không.
Cal-OPD giải quyết vấn đề mô hình học sinh vô tình học phải các sai lệch nội tại của giáo viên trong quá trình chưng cất (distillation), bằng cách tách biệt và loại bỏ các nhiễu này để cải thiện khả năng suy luận.
Nghiên cứu chỉ ra rằng sự lệch pha giữa token kết thúc (EOS) của mô hình giáo viên và học sinh trong chưng cất chính sách trực tuyến (OPD) khiến mô hình phản hồi quá dài hoặc cạn kiệt tài nguyên tính toán.
Apple giới thiệu TS-DFM, kỹ thuật chưng cất mô hình sử dụng 'la bàn năng lượng' để chọn lọc bước nhảy hiệu quả thay vì ngẫu nhiên. Kết quả cho thấy mô hình 8 bước vượt trội hơn mô hình 1024 bước tới 32% về độ chính xác, đồng thời tăng tốc độ suy luận gấp 128 lần.
Meta vừa công bố phương pháp chưng cất mô hình mới giúp các mô hình Byte vượt qua giới hạn hiệu suất truyền thống, mở ra hướng đi đột phá cho việc tối ưu hóa AI.
Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng trong lĩnh vực nén và tối ưu hóa mô hình ngôn ngữ, có tính ứng dụng cao cho cộng đồng nghiên cứu AI.
Chuyên gia Zhao Chunxiang phân tích hai khía cạnh của việc OpenAI tố cáo các bên lạm dụng mô hình cho mục đích quân sự, đồng thời cảnh báo về sự khan hiếm dữ liệu toàn cầu và hệ quả từ chiến lược 'đốt sách' của các ông lớn AI.
Lan Tịch cho rằng các mô hình nội địa Trung Quốc khó phủ nhận việc 'chưng cất' dữ liệu từ mô hình khác. Vấn đề hiện nay không nằm ở kỹ thuật mà ở góc độ đạo đức và pháp lý, khi đây được coi là thông lệ phổ biến trong ngành thay vì vi phạm pháp luật.
Anthropic latest "misuse of AI" report claims distillation can improve general reasoning enough to i…
DịchBáo cáo mới từ Anthropic chỉ ra rằng kỹ thuật chưng cất tri thức (knowledge distillation) có thể giúp mô hình nhỏ đạt khả năng suy luận nguy hiểm vượt ngoài phạm vi huấn luyện ban đầu, dù các rào cản an toàn hiện tại vẫn khó bị sao chép qua phương pháp này.
Big W for people saying that distillation was mostly an SFT artifact, and how its unclear how it wou…
DịchMột góc nhìn mới khẳng định tầm quan trọng của kỹ thuật chưng cất mô hình trong kỷ nguyên học tăng cường (RL), bác bỏ quan điểm cho rằng đây chỉ là sản phẩm phụ của quá trình tinh chỉnh có giám sát (SFT).
Jensen Huang on "distillation" In this interview with axios, he was asked this question: "Should op…
DịchJensen Huang khẳng định việc AI học hỏi từ các mô hình khác (chưng cất tri thức) là bản chất của trí tuệ, đồng thời nhấn mạnh các mô hình thông minh hơn cũng sẽ an toàn hơn.
Phương pháp TGOPD cải thiện quá trình chưng cất mô hình bằng cách kiểm tra độ tin cậy của giáo viên ở cấp độ prompt trước khi áp dụng giám sát, giúp tránh việc học theo các phản hồi sai lệch.
Nghiên cứu khám phá vai trò của dữ liệu trong chưng cất mô hình (OPD), chứng minh rằng chỉ với một truy vấn duy nhất, mô hình có thể cải thiện hiệu suất liên tục qua hàng trăm bước và đạt được phần lớn lợi ích so với việc dùng toàn bộ tập dữ liệu.
Nghiên cứu giới thiệu phương pháp IDA-OPD giúp mô hình học sinh kế thừa khả năng suy luận đa dạng từ giáo viên bằng cách lọc bỏ các cập nhật làm giảm entropy, thay vì chỉ tập trung vào độ chính xác đơn lẻ.
Does On-Policy Distillation Really Distill? From Noisy Teacher to Self-Improvement paper: https: /…
DịchNghiên cứu này phân tích bản chất thực sự của quá trình chưng cất On-Policy và giới thiệu OPSA, một phương pháp mới giúp tối ưu hóa mà không cần dữ liệu giám sát.
Nghiên cứu chỉ ra rằng hiệu quả của chưng cất On-Policy (OPD) chủ yếu đến từ việc ức chế các token có xác suất thấp thay vì phụ thuộc vào giáo viên. Từ đó, nhóm tác giả đề xuất OPSA, phương pháp không cần giám sát giúp tối ưu hóa mô hình hiệu quả hơn.
Interesting study on model distillation. A distilled student model copies how its teacher reasons …
DịchNghiên cứu chỉ ra rằng mô hình học sinh ưu tiên bắt chước cách suy luận của giáo viên thay vì kiến thức thuần túy. Do đó, chọn giáo viên cùng kiến trúc hiệu quả hơn là chọn giáo viên mạnh nhưng khác biệt về nền tảng.
Nghiên cứu chỉ ra rằng phương pháp chưng cất đa giáo viên (M-OPD) hiện nay gặp hạn chế lớn trong việc tích hợp năng lực, chỉ đạt 35,6% hiệu suất tối ưu. Nhóm tác giả đề xuất giải pháp khắc phục tình trạng suy giảm chất lượng khi huấn luyện mô hình tổng quát từ các chuyên gia RL.
D^3-MOPD là phương pháp lập lịch động giúp tối ưu hóa quá trình chưng cất kiến thức từ nhiều giáo viên bằng cách tự động điều chỉnh tỷ lệ dữ liệu theo tốc độ hội tụ của từng miền, giúp tiết kiệm tài nguyên và nâng cao hiệu quả huấn luyện.
OPDVR là phương pháp mới kết hợp học tăng cường dựa trên phần thưởng kiểm chứng (RLVR) với chưng cất chính sách trực tuyến (OPD) mà không cần thêm siêu tham số, giúp tối ưu hóa mô hình hiệu quả hơn.
Nghiên cứu đề xuất phương pháp R2-OPD giúp lọc phản hồi từ giáo viên trong quá trình chưng cất mô hình, đảm bảo việc học tập tập trung vào tiến trình suy luận thực tế thay vì chỉ bắt chước đầu ra của giáo viên.
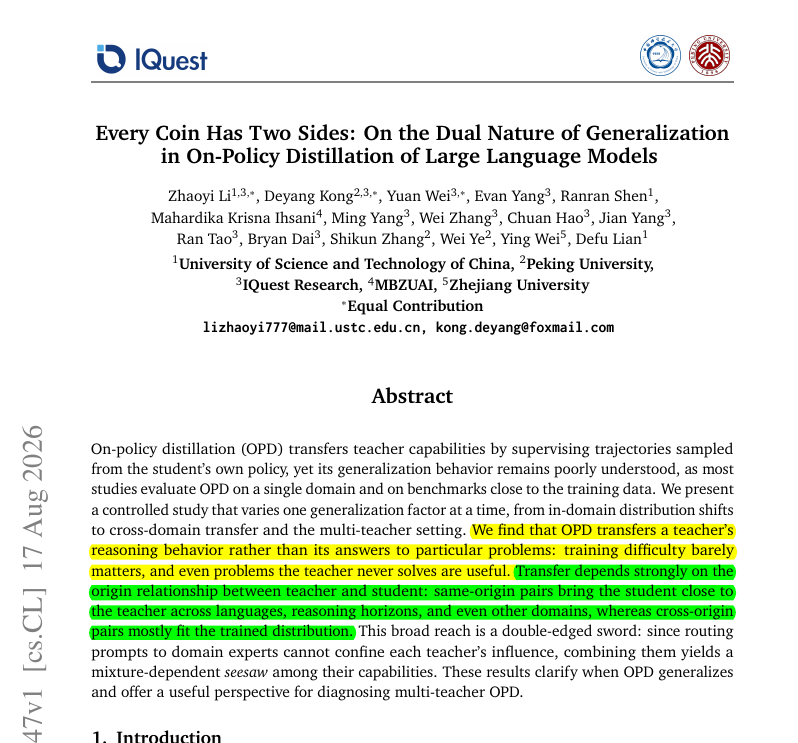
Nghiên cứu chỉ ra rằng chưng cất mô hình (OPD) giúp truyền tải tư duy thay vì chỉ là đáp án. Hiệu quả phụ thuộc lớn vào mối quan hệ nguồn gốc giữa mô hình giáo viên và học sinh, thay vì độ khó của bài toán.
SimpleOPD giải quyết các thách thức khi chuyển giao khả năng suy luận từ mô hình ngữ cảnh dài sang mô hình ngữ cảnh ngắn, thông qua việc đồng bộ hóa không gian văn bản và tối ưu hóa quá trình huấn luyện để tránh lỗi độ dài và mất ổn định.
Nghiên cứu giới thiệu S^2VOPD, phương pháp tạo tín hiệu học tập bằng cách lược bỏ thông tin từ mô hình học sinh thay vì bổ sung dữ liệu cho giáo viên, giúp huấn luyện mô hình thị giác hiệu quả mà không cần nhãn hay mô hình giáo viên mạnh.
Nghiên cứu mới chỉ ra lỗ hổng cho phép trích xuất chuỗi tư duy ẩn từ các mô hình AI hàng đầu của Anthropic, OpenAI và Google với chi phí thấp, đặt ra thách thức lớn về bảo mật mô hình.
CMD giới thiệu khung làm việc DMD nhân quả, giúp đồng bộ hóa sự giám sát của giáo viên với quá trình tạo video của học sinh, từ đó tối ưu hóa hiệu suất tạo video ngắn và dài, đồng thời cải thiện khả năng kiểm soát camera theo thời gian.
Một nghiên cứu mới chỉ ra phương pháp khai thác lỗ hổng API để trích xuất các bước suy luận ẩn của AI. Dữ liệu cho thấy các mô hình như Kimi và GLM có dấu hiệu bị ảnh hưởng khi chưng cất từ các mô hình mạnh hơn như Opus, làm dấy lên tranh cãi về việc sao chép công nghệ.
 Elvis Saravia@omarsar0