26/09

Thứ Bảy · 1 tin
@completeskeptic@completeskeptic
Quan điểmĐiểm AI 16/100

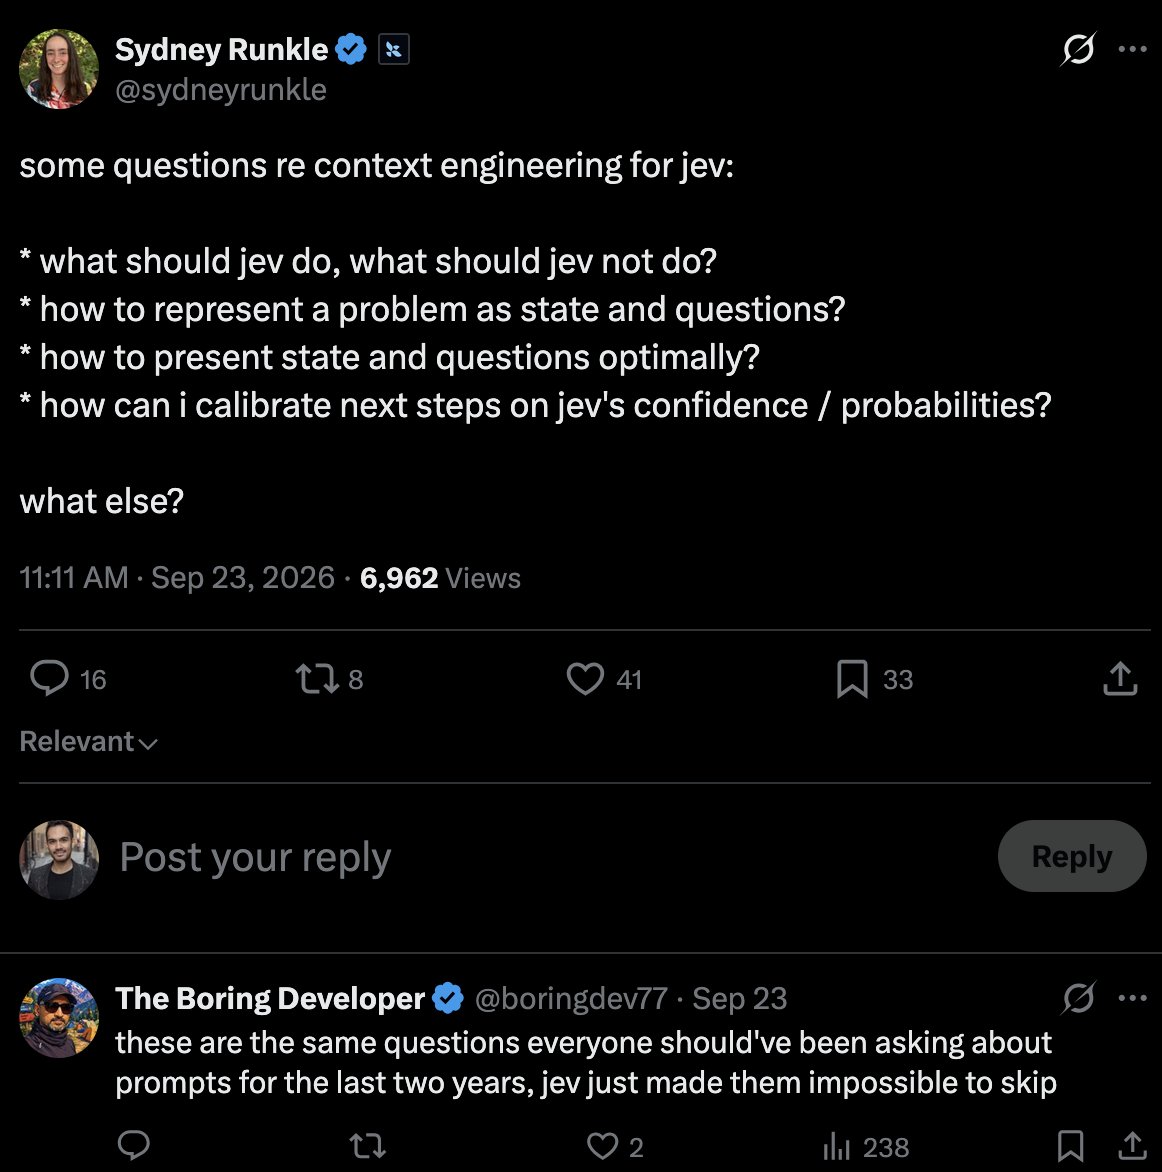
jev: Hồi sinh các nguyên tắc kiến trúc phần mềm kết hợp cùng sức mạnh ML

SO MUCH THIS I believe that one of jev's greatest benefits to automation will come from resurrectin…

Dịchjev hứa hẹn mang lại bước tiến cho tự động hóa bằng cách kết hợp các thực hành kiến trúc kinh điển như quản lý trạng thái, đóng gói, trừu tượng hóa với các tiêu chuẩn ML hiện đại như đo lường, đánh giá và kiểm soát độ bất định.

24/09

Thứ Năm · 2 tin

23/09

Thứ Tư · 1 tin

22/09

Thứ Ba · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 57/100

Meta ra mắt A-MLE: Khung tác tử AI tự động hóa quy trình thử nghiệm mô hình quảng cáo

Meta published A-MLE, a new AI agent framework they actually built and deployed to automate ML exper…

DịchMeta giới thiệu A-MLE, khung tác tử LLM giúp tự động hóa toàn bộ quy trình từ đề xuất ý tưởng, chạy thử nghiệm đến phân tích kết quả và tối ưu hóa mô hình quảng cáo quy mô lớn.

21/09

Thứ Hai · 2 tin
@mark_k@mark_k
Sản phẩmĐiểm AI 45/100

Xiaomi ra mắt CodeMidas: Hệ thống tự động xây dựng môi trường huấn luyện cho AI lập trình

Coding agents can now create their own training environments from existing software! Xiaomi's new C…

DịchCodeMidas của Xiaomi giúp AI tự động trích xuất tác vụ từ các dự án mã nguồn mở để tạo môi trường kiểm thử, giúp cải thiện đáng kể hiệu suất sửa lỗi và xây dựng chương trình của mô hình MiMo-V2.5.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

ECDYSIS: Tối ưu hóa huấn luyện AI Agent thông qua phân tích mô hình lỗi

If an agent rewrites its runtime for every bad decision, it can learn the wrong lesson Fix recurrin…

DịchECDYSIS là khung vận hành mới giúp AI Agent học từ các nhóm lỗi tương đồng thay vì sửa lỗi đơn lẻ, giúp tăng độ chính xác, tốc độ huấn luyện và khả năng thích ứng trên nhiều mô hình khác nhau.

20/09

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 71/100

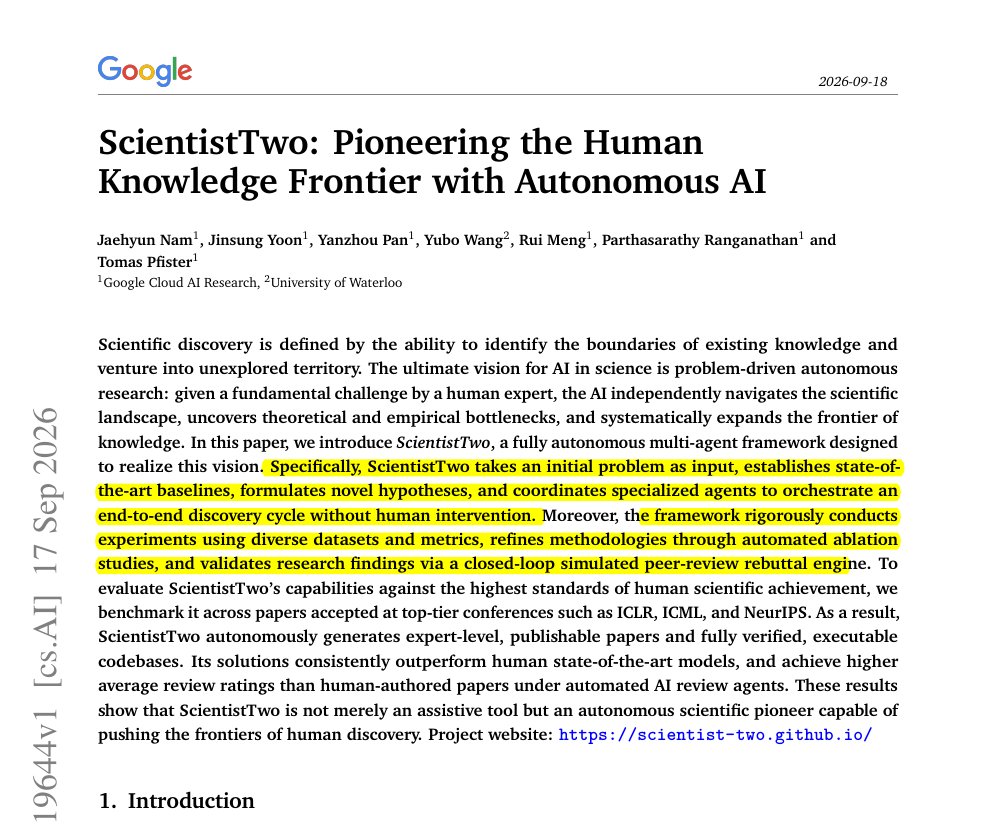
Google ScientistTwo: Bước tiến đột phá của AI trong khả năng tự cải tiến nghiên cứu

Beautiful paper from Google. ScientistTwo shows another progress of recursive self-improvement in A…

DịchGoogle giới thiệu ScientistTwo, mô hình AI có khả năng tự lặp lại quy trình nghiên cứu: từ đề xuất ý tưởng, thực nghiệm đến tối ưu hóa dựa trên phản hồi. Hệ thống đã tự cải thiện 80,4% các bài toán ML từ các hội nghị lớn, vượt xa hiệu suất ban đầu của con người.

19/09

Thứ Bảy · 1 tin
TechCrunch: AI
Mô hìnhĐiểm AI 68/100

Cùng sự kiệnCựu chuyên gia OpenAI ra mắt Jev: Mô hình AI mới tập trung vào xác suất thay vì tạo văn bản

TypeSafe, startup do đồng tác giả RLHF sáng lập, vừa giới thiệu Jev - mô hình transformer đột phá không tạo văn bản mà tập trung đưa ra các quyết định dựa trên xác suất đã được hiệu chỉnh.

Cùng sự kiện, bài đại diện «OpenRouter ra mắt Jev: Mô hình chuyên biệt cho các quyết định nhanh và rẻ»

18/09

Thứ Sáu · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 64/100

Phân loại bằng LLM thực chất là kỹ thuật đặc trưng: Kết hợp LLM với hồi quy logistic

Thay vì dùng LLM trực tiếp làm bộ phân loại thiếu độ tin cậy, tác giả đề xuất sử dụng kết quả từ LLM như một đặc trưng đầu vào cho các mô hình học máy truyền thống như hồi quy logistic để tối ưu hóa hiệu suất.

Francois Chollet@fchollet
NgànhĐiểm AI 26/100

Keras 3 đã giúp Expedia hiện đại hóa hệ thống xếp hạng dịch vụ lưu trú như thế nào

How Keras 3 helped modernise Expedia's ranking stack https://medium.com/expedia-group-tech/how-keras...

DịchKhám phá cách Expedia Group tận dụng tính linh hoạt của Keras 3 để tối ưu hóa và hiện đại hóa hạ tầng xếp hạng phòng khách sạn, giúp tăng hiệu suất triển khai mô hình học máy.

17/09

Thứ Năm · 1 tin
Apple Machine Learning Research
NgànhĐiểm AI 45/100

Cùng sự kiệnApple ra mắt TS-DFM: Tối ưu hóa mô hình ngôn ngữ với 'la bàn năng lượng' siêu tốc

Apple giới thiệu TS-DFM, kỹ thuật chưng cất mô hình sử dụng 'la bàn năng lượng' để chọn lọc bước nhảy hiệu quả thay vì ngẫu nhiên. Kết quả cho thấy mô hình 8 bước vượt trội hơn mô hình 1024 bước tới 32% về độ chính xác, đồng thời tăng tốc độ suy luận gấp 128 lần.

Cùng sự kiện, bài đại diện «DACA-GRPO: Apple tối ưu hóa học tăng cường cho mô hình ngôn ngữ khuếch tán»

16/09

Thứ Tư · 2 tin

13/09

Chủ Nhật · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKỹ sư thuật toán sắp thất nghiệp? Alibaba và Đại học Chiết Giang ra mắt Astar: AI tự tối ưu hóa chính mình

Astar là mô hình ngôn ngữ lớn được thiết kế để tự động hóa quá trình tiến hóa của hệ thống AI bằng cách học hỏi từ lịch sử thử nghiệm thực tế. Công nghệ này giúp tăng hiệu suất tạo ý tưởng lên gấp 100 lần và đã cải thiện đáng kể các chỉ số kinh doanh cốt lõi tại Alibaba.


Vì sao đáng đọc: Tin tức đột phá về việc AI tự cải tiến (AI-for-AI), giải quyết bài toán chi phí thử nghiệm cao trong kỹ thuật thuật toán. Nội dung có tính ứng dụng thực tiễn cao và tác động lớn đến ngành.
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 43/100

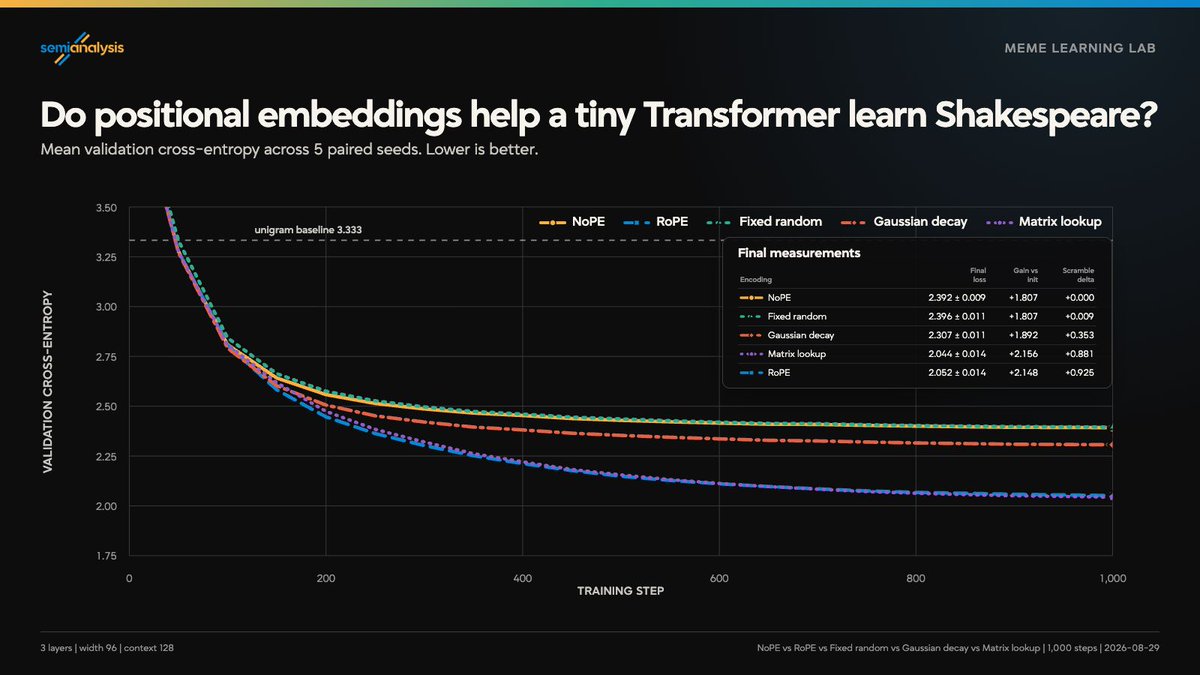
Khám phá các ràng buộc toán học và khả năng tổng quát hóa của cơ chế nhúng vị trí (Position Embedding)

Attention has no innate notion of time. Positional embeddings are how language models tell how far a…

DịchBài viết phân tích cách các mô hình ngôn ngữ sử dụng nhúng vị trí để hiểu khoảng cách giữa các token, đồng thời đặt câu hỏi liệu việc nới lỏng các ràng buộc toán học truyền thống có mở ra không gian hàm mới hiệu quả hơn hay không.

12/09

Thứ Bảy · 1 tin
DAIR.AI@dair_ai
NgànhĐiểm AI 43/100

Ecdysis: Khung tác nhân tự tiến hóa giúp tăng tốc huấn luyện gấp 1,84 lần

Great paper on self-evolving agent harnesses. Self-evolving agent harnesses have two practical prob…

DịchEcdysis tối ưu hóa quy trình tự sửa lỗi của AI bằng cách phân tích lỗi theo lô và thống nhất chiến lược trước khi sửa code, giúp tăng tốc huấn luyện 1,84 lần và cải thiện 18,56% độ chính xác với ít dữ liệu hơn.

11/09

Thứ Sáu · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnNegative Self-Distillation: Cải thiện khả năng suy luận của AI bằng cách tránh các lỗi sai

Thay vì bắt chước đáp án mẫu, phương pháp Negative Self-Distillation (NSD) giúp mô hình ngôn ngữ tự tối ưu hóa bằng cách nhận diện và tránh xa các suy luận sai lầm, từ đó thúc đẩy tư duy phản biện và tự sửa lỗi.


Vì sao đáng đọc: Đây là một hướng tiếp cận mới đầy tiềm năng trong việc huấn luyện LLM, giải quyết trực tiếp điểm yếu của phương pháp tự chưng cất (self-distillation) truyền thống.

10/09

Thứ Năm · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

HybridAL: Tối ưu hóa chiến lược huấn luyện trong Active Learning bằng tín hiệu ổn định

Nghiên cứu đề xuất HybridAL, phương pháp tự động chuyển đổi giữa huấn luyện lại từ đầu và tinh chỉnh (fine-tuning) dựa trên tín hiệu ổn định của mô hình, giúp tiết kiệm tài nguyên mà vẫn duy trì hiệu suất tối ưu.

07/09

Thứ Hai · 4 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 57/100

Google DeepMind và MIT giới thiệu SMART: Khi tài liệu thiết kế thay thế mã nguồn trong mô hình hóa ML

// Design Docs Are All You Need // Banger paper from Google DeepMind, MIT, and colleagues. What a …

DịchSMART là thư viện mô hình hóa hiệu năng ML đột phá, nơi mã nguồn được tự động tạo từ các tài liệu thiết kế dạng đồ thị thay vì viết tay, giúp tối ưu hóa quy trình cập nhật và quản lý hệ thống.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

Microsoft và Cornell công bố phương pháp huấn luyện AI hiệu quả, đạt hiệu suất tương đương mô hình lớn hơn 50%

Nghiên cứu mới từ Microsoft và Đại học Cornell giới thiệu kỹ thuật tối ưu hóa giúp mô hình AI đạt kết quả tương đương các mô hình tiêu chuẩn dù được huấn luyện với ít dữ liệu hơn 50%, hứa hẹn giảm đáng kể chi phí tính toán.

Ma Dongxi NLP@dongxi_nlp
NgànhĐiểm AI 28/100

Điểm tin tuần 26: Rủi ro khi huấn luyện AI theo cơ chế phần thưởng và hệ lụy của việc tự động hóa chấm điểm

Bài viết phân tích các lỗ hổng trong việc huấn luyện AI dựa trên mục tiêu phần thưởng và cảnh báo rằng việc lạm dụng tự động hóa trong chấm điểm có thể làm suy giảm chất lượng đánh giá của mô hình.

06/09

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 51/100

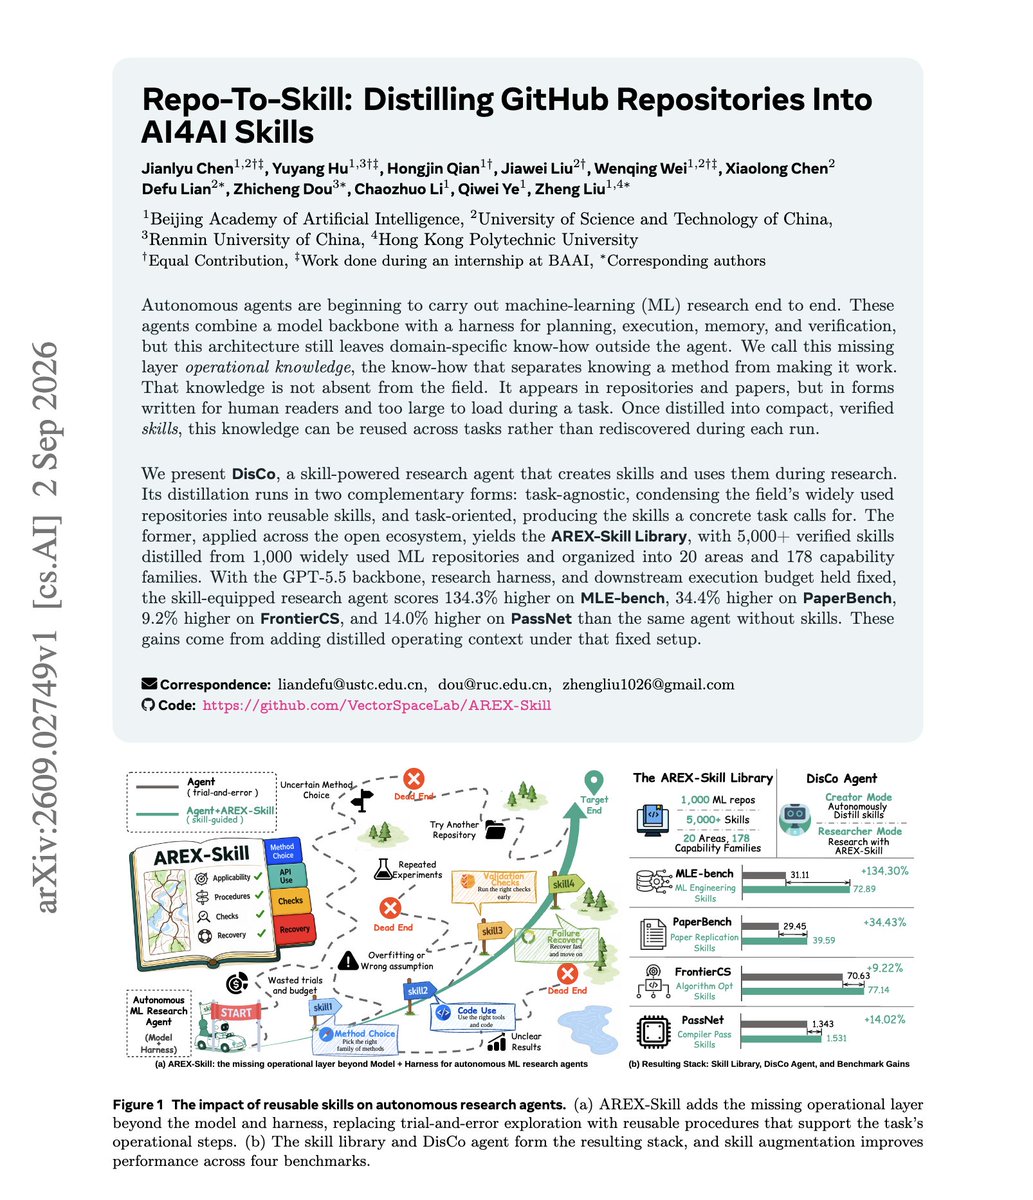
DisCo: Phương pháp chưng cất kho lưu trữ GitHub thành kỹ năng, giúp AI đạt 72.89% trên MLE-bench

Very useful insight in this paper. AI agents may be wasting huge amounts of effort rediscovering t…

DịchNghiên cứu DisCo giới thiệu cách chuyển đổi kho lưu trữ GitHub và tài liệu kỹ thuật thành các 'kỹ năng' tinh gọn, giúp AI tự chủ trong việc chọn công cụ và xử lý lỗi, từ đó nâng cao đáng kể hiệu suất giải quyết tác vụ thực tế.

05/09

Thứ Bảy · 1 tin

04/09

Thứ Sáu · 3 tin
AK@_akhaliq
Nghiên cứuĐiểm AI 26/100

Repo-To-Skill: Nghiên cứu mới về cách chắt lọc kho lưu trữ GitHub thành kỹ năng cho AI

Repo-To-Skill Distilling GitHub Repositories Into AI4AI Skills paper: https://huggingface.co/paper...

DịchNghiên cứu Repo-To-Skill giới thiệu phương pháp chắt lọc dữ liệu từ các kho lưu trữ GitHub để huấn luyện và nâng cao kỹ năng chuyên biệt cho các mô hình AI (AI4AI).

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sparse Readout Prism: Giải mã Logit-Lens thông qua các đặc trưng thay vì token

Nghiên cứu giới thiệu Sparse Readout Prism (SRP), một phương pháp phân tích mới giúp tách biệt cấu trúc giải mã của mô hình ngôn ngữ khỏi dữ liệu huấn luyện, cho phép hiểu rõ cách các đặc trưng ẩn tạo nên dự đoán thay vì chỉ nhìn vào các token đơn thuần.

03/09

Thứ Năm · 2 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 45/100

BAAI ra mắt DisCo: Chuyển hóa kho mã nguồn GitHub thành kỹ năng cho AI nghiên cứu

Banger paper from BAAI. If you are building research agents, this one is worth your time. (bookmar…

DịchBAAI giới thiệu DisCo, phương pháp chưng cất 1.000 kho mã nguồn ML thành thư viện kỹ năng AREX, giúp các tác nhân AI (AI Agents) nâng cao đáng kể hiệu suất giải quyết các nhiệm vụ nghiên cứu phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

DisCo: Đột phá biến 1.000 kho lưu trữ ML thành thư viện 5.000+ kỹ năng cho AI Agent

Nghiên cứu giới thiệu phương pháp Repo-To-Skill giúp chắt lọc kiến thức từ GitHub thành thư viện kỹ năng AREX, cho phép AI Agent thực thi tác vụ hiệu quả hơn thông qua các kỹ năng đã được kiểm chứng.

01/09

Thứ Ba · 2 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 62/100

Nghiên cứu mới: Giảm tỷ lệ 'hack phần thưởng' của AI từ 23,6% xuống 5,3% nhờ cơ chế báo cáo lỗi

Brilliant paper on reducing reward hacking in agents. If you follow the recent OpenAI <> HuggingFac…

DịchMột nghiên cứu trên arXiv giới thiệu công cụ báo cáo lỗi có cấu trúc giúp các tác nhân AI xử lý sự cố hạ tầng kiểm thử hiệu quả hơn, từ đó giảm đáng kể tình trạng 'hack phần thưởng' (reward hacking) từ 23,6% xuống còn 5,3%.

30/08

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

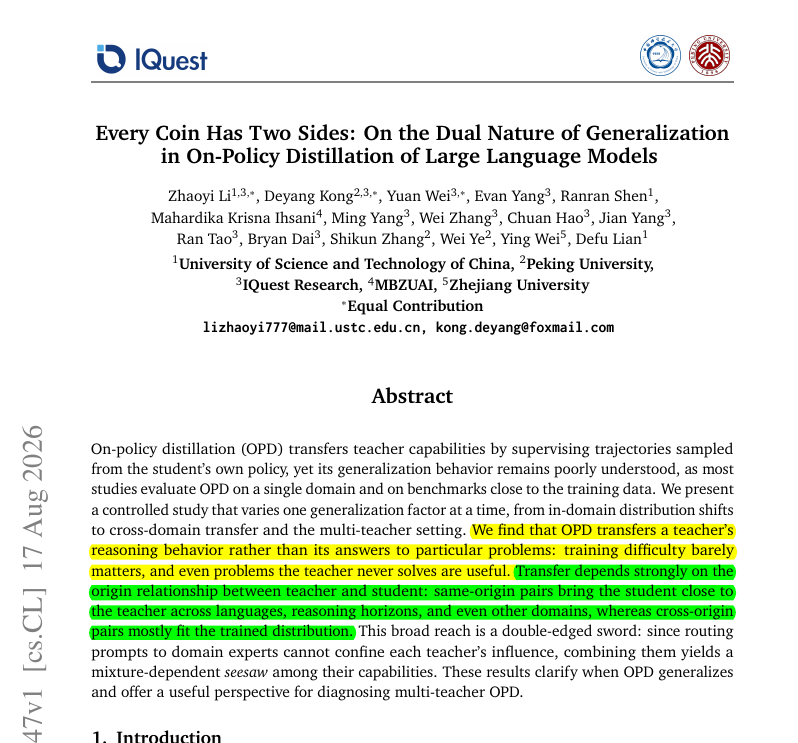
Nghiên cứu chưng cất mô hình: Cách suy luận của giáo viên quan trọng hơn điểm số

Interesting study on model distillation. A distilled student model copies how its teacher reasons …

DịchNghiên cứu chỉ ra rằng mô hình học sinh ưu tiên bắt chước cách suy luận của giáo viên thay vì kiến thức thuần túy. Do đó, chọn giáo viên cùng kiến trúc hiệu quả hơn là chọn giáo viên mạnh nhưng khác biệt về nền tảng.

28/08

Thứ Sáu · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

Giải mã dữ liệu cho AI Agent: Góc nhìn ACE trong việc tối ưu hóa huấn luyện LLM

Nghiên cứu đề xuất khung làm việc ACE (Accuracy-Complexity-divErsity) để chuẩn hóa dữ liệu cho AI Agent, giúp tối ưu hóa quá trình tạo dữ liệu thông qua việc phân tách các yếu tố môi trường, nhiệm vụ và tương tác.

27/08

Thứ Năm · 1 tin
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 51/100

Hướng dẫn thiết lập môi trường Machine Learning trên DGX Spark

I've put together an up-to-date, validated DGX Spark setup for ML experiments such as post-training: …

DịchHướng dẫn cấu hình tối ưu cho DGX Spark bao gồm PyTorch 2.13 trên CUDA 13, nhân huấn luyện đã kiểm chứng qua GB10 và môi trường vLLM biệt lập, giúp tăng hiệu suất cho các thử nghiệm hậu huấn luyện.

25/08

Thứ Ba · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Chỉ huấn luyện lớp chiếu: Mở rộng đa phương thức cho LLM mà không làm mất khả năng vốn có

You can teach a language model a new modality without ever touching the backbone's weights. Train …

DịchNghiên cứu mới đề xuất phương pháp chỉ huấn luyện lớp kết nối giữa encoder và mô hình ngôn ngữ, giúp bổ sung đa phương thức mà không cần tinh chỉnh toàn bộ tham số, vừa tăng tốc độ huấn luyện vừa bảo toàn hiệu suất gốc của mô hình.

23/08

Chủ Nhật · 1 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (53 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Machine Learning” | AIHOT.vn