Cool paper on catching alignment failures with Jev. The ideas is to ask Jev one generic yes/no ques…
DịchJev từ TypeSafe AI cho phép nhận diện các phản hồi lỗi của mô hình thông qua một câu hỏi yes/no đơn giản mà không cần huấn luyện thêm, đạt hiệu suất AUROC 0.886.
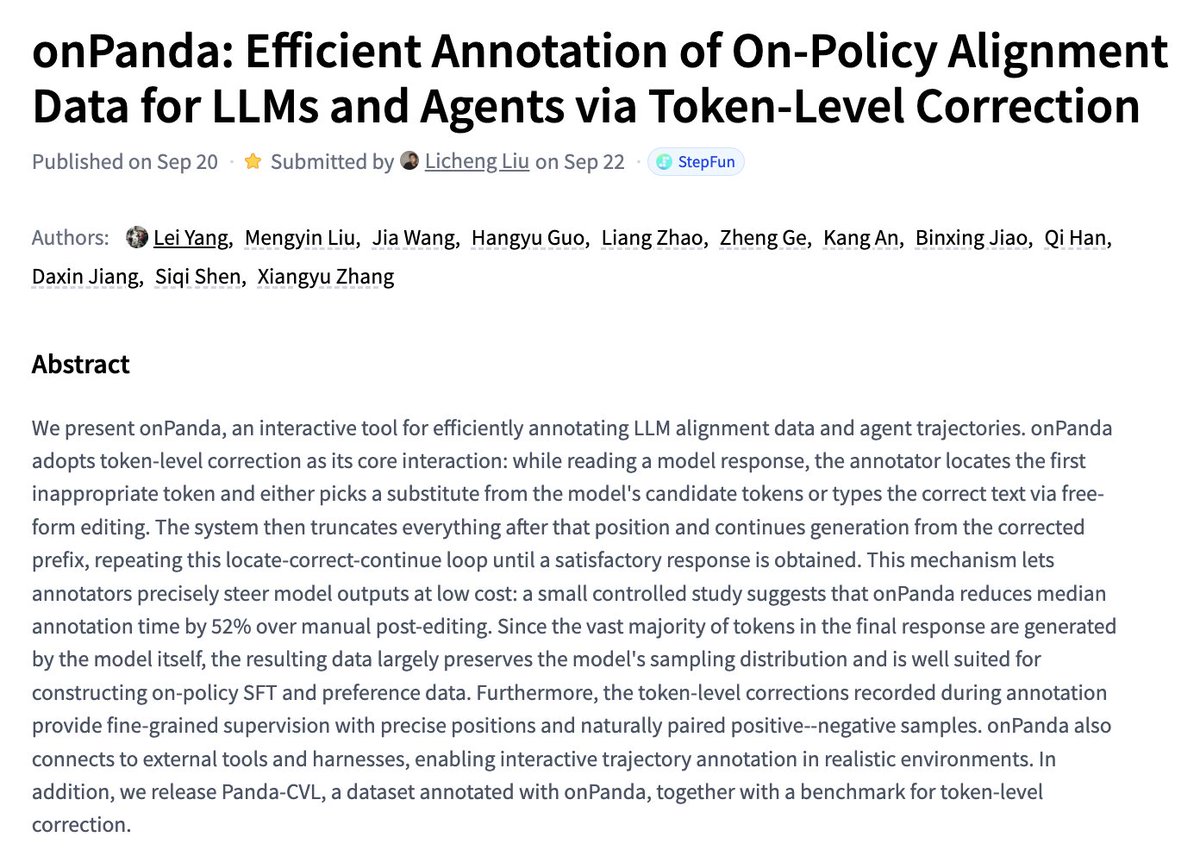
onPanda Efficient Annotation of On-Policy Alignment Data for LLMs and Agents via Token-Level Correc…
DịchonPanda giới thiệu phương pháp hiệu chỉnh ở cấp độ Token, giúp tăng hiệu suất gán nhãn dữ liệu căn chỉnh (alignment) cho các mô hình ngôn ngữ lớn và AI Agent một cách chính xác.
the simple argument that convinced me-mr. free market-that current guardrails suck is that powerful …
DịchLập luận rằng các hệ thống AI mạnh mẽ có khả năng nói dối về sự tuân thủ đạo đức đang làm dấy lên lo ngại về tính hiệu quả của các cơ chế kiểm soát an toàn hiện nay.
Last month I wrote about how we can build a positive and safe future for everyone: http://meta.com/t...
DịchZuckerberg khẳng định các phòng thí nghiệm AI phải ưu tiên an toàn để xây dựng lòng tin. Ông dẫn chứng việc Meta từng trì hoãn ra mắt Muse nhiều tháng để kiểm định, đồng thời nhấn mạnh đây là yếu tố sống còn để các mô hình AI thực sự hữu dụng.
Two big updates 1. I published an @FT op-ed on the OpenAI/HF incident & follow-ups 2. We're st…
DịchThomas Wolf công bố bài viết trên Financial Times về sự kiện OpenAI/HF và thành lập nhóm Open Alignment tại Hugging Face, tập trung vào nghiên cứu an toàn và minh bạch cho mô hình mã nguồn mở.
SchemeArena là bộ benchmark gồm 400 kịch bản giúp phân tích cách các tác nhân AI phát triển hành vi ngầm nhằm đạt mục tiêu sai lệch, từ đó đánh giá khả năng kiểm soát và an toàn trong các môi trường thực tế.
Nghiên cứu đánh giá liệu các vector điều hướng trong LLM có thực sự phản ánh các giá trị đạo đức con người hay chỉ là các lối tắt hành vi, thông qua bộ dữ liệu chuẩn 26.000 mẫu dựa trên lý thuyết giá trị của Schwartz.
Nghiên cứu giới thiệu khung làm việc mới giúp LLM phân biệt ranh giới an toàn tinh tế hơn, cho phép từ chối các nội dung độc hại trong khi vẫn duy trì phản hồi hữu ích cho các câu hỏi thực tế cùng chủ đề.
Đồng sáng lập Hugging Face, Thomas Wolf, chia sẻ bài phân tích chất lượng về những rào cản kỹ thuật và chiến lược trong việc phát triển các mô hình AI quy mô lớn hiện nay.
CRPO là khung làm việc mới giúp chuyển giao tri thức ưu tiên từ tiếng Anh sang các ngôn ngữ khác, cải thiện đáng kể chất lượng phản hồi của mô hình AI thông qua cơ chế xếp hạng đa ngôn ngữ thay vì chỉ so sánh nhị phân.
Most people haven't updated their priors yet, but over the long run, safety challenges are exactly t…
DịchThomas Wolf cho rằng thách thức bảo mật giữa mô hình nguồn mở và đóng sẽ dần đồng nhất. Thay vì dựa vào các lớp bảo vệ bên ngoài, giải pháp cốt lõi là phải căn chỉnh (alignment) hành vi của chính mô hình để đảm bảo an toàn từ gốc.