Hôm qua · 27/09

Chủ Nhật · 1 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 67/100

Cùng sự kiệnPrivatemode biến GLM-5.3-Flash thành mô hình ra quyết định có cấu trúc chỉ với một lần suy luận

Nhóm Privatemode giới thiệu kỹ thuật không cần tinh chỉnh, tận dụng log probability của GLM-5.3-Flash để thực hiện các quyết định có kiểu dữ liệu cụ thể chỉ trong một lần forward pass.

Cùng sự kiện, bài đại diện «Hướng dẫn sử dụng Jev: Kiểm duyệt nội dung với mô hình ra quyết định của TypeSafe trên OpenRouter»

26/09

Thứ Bảy · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnNature Machine Intelligence: Tín hiệu não người giúp tối ưu hóa khả năng suy luận của mô hình ngôn ngữ

Nghiên cứu mới từ ĐH Bắc Kinh, Thanh Hoa và Microsoft cho thấy việc sử dụng tín hiệu fMRI từ não người có thể định hướng và cải thiện độ chính xác, tính bền vững trong suy luận của các mô hình ngôn ngữ lớn.


Vì sao đáng đọc: Nghiên cứu đột phá kết nối khoa học thần kinh và AI, chuyển từ việc chỉ so sánh biểu diễn sang ứng dụng thực tế để cải thiện hiệu năng mô hình, rất có giá trị học thuật.

24/09

Thứ Năm · 2 tin
QbitAI
NgànhĐiểm AI 92/100

Tinh chọnCard đồ họa PCIe bị đánh giá thấp: Tối ưu nhân và tái cấu trúc giao tiếp giúp DeepSeek tăng tốc suy luận gấp 7 lần

Nhờ cải tiến kỹ thuật, hệ thống sử dụng 1,5 card 6000D đã vượt qua hiệu suất của 1 card B300 trong tác vụ suy luận DeepSeek.


Vì sao đáng đọc: Bài viết mang tính đột phá về kỹ thuật tối ưu hóa phần cứng, giúp giảm chi phí hạ tầng đáng kể cho các mô hình AI lớn, rất hữu ích cho cộng đồng kỹ thuật.

23/09

Thứ Tư · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

LatentPort: Chuyển giao bộ nhớ đệ quy giữa các mô hình ngôn ngữ lai mà không cần đọc lại ngữ cảnh

Nghiên cứu giới thiệu kỹ thuật LatentPort cho phép chuyển giao trạng thái bộ nhớ trực tiếp giữa Qwen3.5 4B và 9B mà không cần nạp lại tiền tố, giúp tối ưu hóa hiệu suất suy luận thông qua việc tái sử dụng trạng thái Gated DeltaNet.

21/09

Thứ Hai · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cal-OPD: Tối ưu hóa chưng cất mô hình thông qua hiệu chỉnh sai lệch giữa giáo viên và học sinh

Cal-OPD giải quyết vấn đề mô hình học sinh vô tình học phải các sai lệch nội tại của giáo viên trong quá trình chưng cất (distillation), bằng cách tách biệt và loại bỏ các nhiễu này để cải thiện khả năng suy luận.

20/09

Chủ Nhật · 1 tin
Nathan Lambert@natolambert
NgànhĐiểm AI 32/100

Các phòng thí nghiệm AI hàng đầu Trung Quốc chuyển hướng sang dùng chip Huawei để suy luận

My best guess is that for scaled RL most of the top Chinese AI labs are starting to use a lot of Hua…

DịchCác phòng thí nghiệm AI lớn tại Trung Quốc đang dần chuyển sang sử dụng chip Huawei cho tác vụ suy luận (inference) và Nvidia cho huấn luyện, nhằm thúc đẩy sự phát triển của hệ sinh thái AI nội địa.

Thêm 1 nguồn khác đưa tinX: Ma Dongxi NLP (@dongxi_nlp)

19/09

Thứ Bảy · 1 tin
Haider@haider1
Mô hìnhĐiểm AI 38/100

GPT-6 Astra tạo đột phá lịch sử khi giải quyết bài toán hóc búa tại FrontierMath

sam is right about the upcoming Astra successor can do things even the best mathematicians can't h…

DịchGPT-6 Astra đã giải quyết thành công một bài toán toán học mở tồn tại từ năm 2017, đánh dấu cột mốc quan trọng đầu tiên trên nền tảng FrontierMath. Mô hình không chỉ chứng minh sự tồn tại của lời giải mà còn đề xuất cơ chế chứng minh mới cùng quy tắc bỏ phiếu sáng tạo.

Thêm 1 nguồn khác đưa tinX: Kim (@kimmonismus)

18/09

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Không chỉ là số lượng: Chiến lược tạo ứng viên ảnh hưởng đến hiệu suất và năng lượng của LLM

Nghiên cứu chỉ ra rằng việc tăng số lượng phản hồi (N) giúp cải thiện khả năng suy luận của LLM, nhưng cách thức thực thi (batching) mới là yếu tố quyết định đến chi phí năng lượng và hiệu suất hệ thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 33/100

CMU và Oxford giới thiệu 'Looped Flows': Giúp mô hình nhỏ suy luận sâu hơn mà không cần kéo dài chuỗi tư duy

New Carnegie Mellon + Oxford Univ paper shows a model can "think longer" by repeatedly improving hid…

DịchCác nhà nghiên cứu đề xuất phương pháp 'Looped Flows', cho phép mô hình cải thiện trạng thái ẩn thay vì tạo thêm token dài dòng. Kỹ thuật này giúp các mô hình nhỏ đạt độ chính xác cao hơn thông qua các bước lặp suy luận, tối ưu hóa hiệu suất tính toán khi kiểm thử.

17/09

Thứ Năm · 3 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 64/100

Zhipu AI tối ưu hạ tầng suy luận với GLM-5.3: Tăng tốc độ xử lý lên gấp 3 lần

A brilliant post from the GLM-5.3 team on RSI (recursive self-improvement). GLM-5.3 was already use…

DịchĐội ngũ Zhipu AI chia sẻ quy trình tối ưu hóa hạ tầng cho GLM-5.3-Flash, giúp đạt hiệu suất sản xuất chỉ trong hai tuần với tốc độ xử lý (throughput) tăng gấp 3 lần so với ban đầu.

Thêm 1 nguồn khác đưa tinX: Kim (@kimmonismus)

16/09

Thứ Tư · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Lightning Weave: Tối ưu hóa sự cân bằng giữa độ chính xác và hiệu suất cho các mô hình suy luận

Lightning Weave là khung huấn luyện hậu kỳ giúp kết hợp các khả năng suy luận từ nhiều mô hình chuyên biệt vào một mô hình duy nhất, giúp cải thiện đồng thời độ chính xác và tốc độ suy luận thông qua kỹ thuật chưng cất chính sách.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 52/100

IEEE Spectrum: Cuộc cách mạng phần cứng AI năm 2026 chuyển dịch sang suy luận

IEEE Spectrum nhận định năm 2026 đánh dấu bước ngoặt khi suy luận (inference) thay thế huấn luyện trở thành tâm điểm cạnh tranh phần cứng, do nhu cầu từ tư duy chuỗi và các AI Agent hoạt động liên tục.

Google DeepMind@GoogleDeepMind
Mô hìnhĐiểm AI 52/100

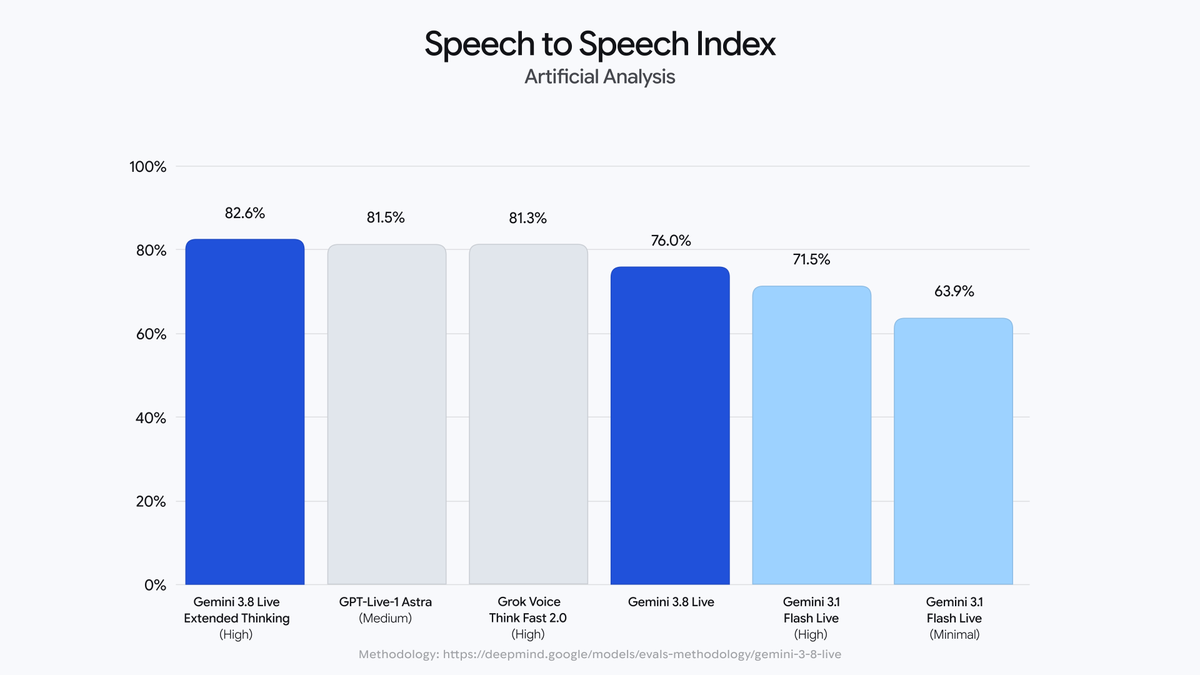
Cùng sự kiệnGoogle DeepMind ra mắt Gemini 3.8 Live và phiên bản Extended Thinking

We're introducing Gemini 3.8 Live and 3.8 Live Extended Thinking - our best conversational AI. The …

DịchGoogle DeepMind vừa công bố Gemini 3.8 Live, mang đến khả năng tương tác thời gian thực mạnh mẽ cùng tính năng Extended Thinking giúp mô hình suy luận sâu sắc và logic hơn trước khi đưa ra phản hồi.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt Gemini 3.8 Live và bản Extended Thinking: Đột phá mới cho trợ lý giọng nói»

15/09

Thứ Ba · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tư duy thiếu tính hệ thống? Đánh giá khả năng suy luận của các mô hình AI qua bài toán quy nạp quy tắc

Nghiên cứu chỉ ra rằng các mô hình AI hiện nay thường thất bại khi đối mặt với các biến thể tương đương về mặt cấu trúc của cùng một bài toán, cho thấy tư duy của chúng thiếu tính hệ thống so với nhận thức con người.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Nghiên cứu về Orthrus: Giải mã suy luận không mất dữ liệu chỉ đạt độ chính xác 40% ở định dạng BF16

Các nhà nghiên cứu đã kiểm chứng phương pháp giải mã suy luận của Orthrus và phát hiện rằng ở định dạng BF16, tỷ lệ khớp hoàn toàn chỉ đạt khoảng 40%, trong khi độ chính xác tuyệt đối chỉ đạt được khi sử dụng FP32.

12/09

Thứ Bảy · 1 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

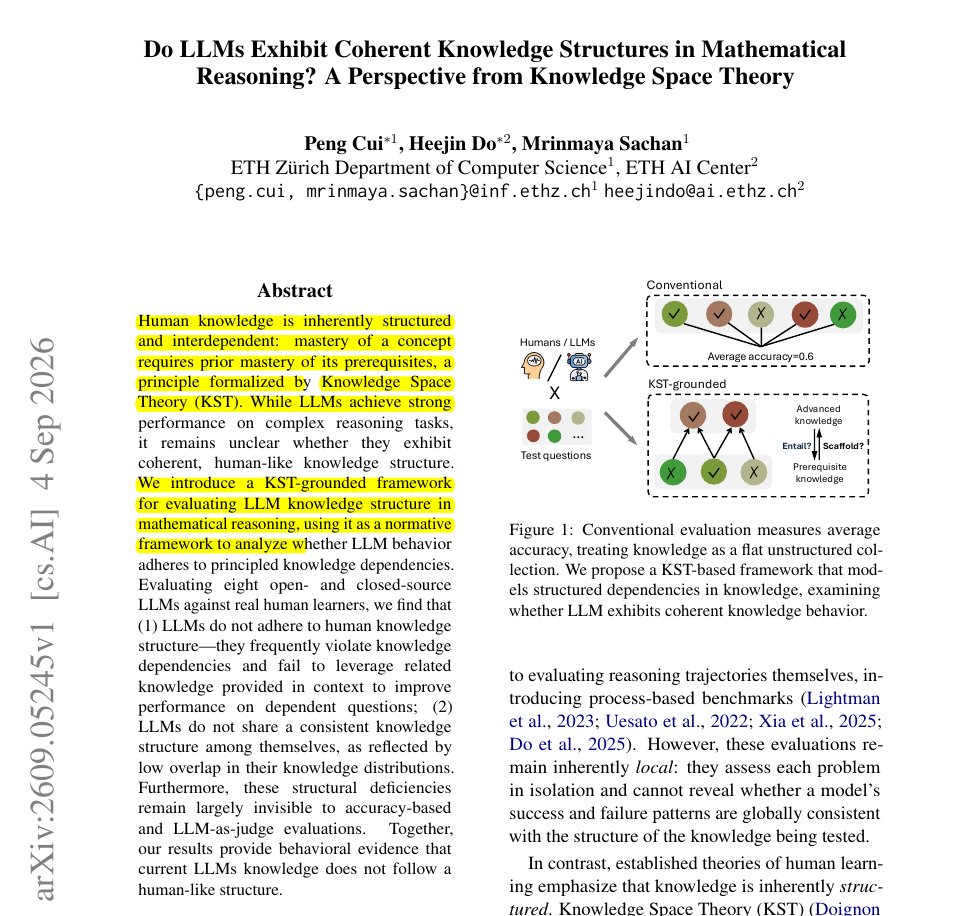
Nghiên cứu: LLM đạt điểm cao nhưng hổng kiến thức nền, Qwen3-80B chỉ đạt 48% độ nhất quán

Humans usually need the foundations before the advanced skill; we need to know the basics before the…

DịchNghiên cứu cho thấy dù Qwen3-80B đạt điểm cao hơn con người trong các bài kiểm tra, nhưng chỉ 48% câu trả lời đúng của nó đảm bảo được tính logic từ các kiến thức nền tảng, cho thấy mô hình AI hiện nay dễ bị 'học vẹt' thay vì hiểu sâu.

11/09

Thứ Sáu · 4 tin
OpenRouter: Announcements
Sản phẩmĐiểm AI 66/100

Tinh chọnOpenRouter ra mắt Fusion: Hệ thống kết hợp nhiều mô hình AI để tối ưu hóa độ chính xác

OpenRouter giới thiệu Fusion, hệ thống cho phép chạy song song nhiều mô hình AI để tranh luận và tổng hợp câu trả lời chính xác nhất. Dù chi phí và độ trễ cao hơn, phương pháp này giúp cải thiện đáng kể hiệu suất trên các bài kiểm tra chuyên sâu.


Vì sao đáng đọc: Đây là bước tiến thú vị trong kỹ thuật suy luận (reasoning), giúp giải quyết vấn đề 'ảo tưởng' của AI bằng cách đối chiếu đa mô hình, rất đáng quan tâm cho người dùng chuyên nghiệp.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnNegative Self-Distillation: Cải thiện khả năng suy luận của AI bằng cách tránh các lỗi sai

Thay vì bắt chước đáp án mẫu, phương pháp Negative Self-Distillation (NSD) giúp mô hình ngôn ngữ tự tối ưu hóa bằng cách nhận diện và tránh xa các suy luận sai lầm, từ đó thúc đẩy tư duy phản biện và tự sửa lỗi.


Vì sao đáng đọc: Đây là một hướng tiếp cận mới đầy tiềm năng trong việc huấn luyện LLM, giải quyết trực tiếp điểm yếu của phương pháp tự chưng cất (self-distillation) truyền thống.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 95/100

Tinh chọnCông thức mở giành Huy chương Vàng IMO: Huấn luyện Nemotron giải toán Olympic

Nghiên cứu giới thiệu quy trình suy luận toán học bằng ngôn ngữ tự nhiên đạt chuẩn Huy chương Vàng IMO 2026, sử dụng các mô hình Nemotron được tinh chỉnh chuyên biệt mà không cần công cụ hỗ trợ bên ngoài.


Vì sao đáng đọc: Đây là bước đột phá quan trọng trong khả năng suy luận logic của AI, chứng minh mô hình ngôn ngữ có thể đạt trình độ toán học cao cấp thông qua kỹ thuật huấn luyện tối ưu.
Ethan Mollick@emollick
Hướng dẫnĐiểm AI 63/100

Ethan Mollick: AI đã chinh phục toàn bộ bài toán FrontierMath Tier 4, xóa tan hoài nghi về khả năng suy luận

The strawberry thing was very funny but probably gave people the wrong impression of where AI was he…

DịchEthan Mollick xác nhận GPT-6 Astra đã giải xong các bài toán FrontierMath khó nhất, chứng minh AI không còn dựa vào các lối tắt logic như lầm tưởng trước đây. Thành tựu này đánh dấu bước tiến lớn, vượt qua những hoài nghi từng nảy sinh từ các lỗi đếm ký tự đơn giản như 'strawberry'.

10/09

Thứ Năm · 1 tin

09/09

Thứ Tư · 3 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 31/100

A*-Thought-V2: Tối ưu hóa suy luận LLM thông qua động lực học hình học

A*-Thought-V2 cải thiện hiệu suất suy luận bằng cách mô hình hóa chuỗi tư duy dưới dạng quỹ đạo trạng thái ẩn, giúp tăng độ chính xác lên 2,6% và giảm đáng kể thời gian tính toán cũng như tài nguyên huấn luyện.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnBeaconKV: Tối ưu bộ nhớ KV Cache cho mô hình suy luận lớn thông qua truy vấn Beacon

BeaconKV giải quyết nút thắt bộ nhớ khi suy luận dài bằng cách xác định các 'Thought Revisiting Tokens' quan trọng, giúp nén KV cache hiệu quả mà không làm giảm khả năng truy xuất ngữ cảnh xa.


Vì sao đáng đọc: Giải pháp kỹ thuật thực tế, giải quyết vấn đề cấp bách về bộ nhớ GPU cho các mô hình suy luận dài (LRMs), có tính ứng dụng cao trong triển khai thực tế.
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 43/100

Uno: Giải pháp tăng tốc suy luận LLM bằng mô hình khuếch tán song song

Uno shows a simple way to speed up existing LLMs without changing their output distribution: keep th…

DịchUno tối ưu hóa suy luận LLM bằng cách sử dụng mô hình khuếch tán để dự đoán song song nhiều token mà không làm thay đổi chất lượng đầu ra. Phương pháp này giúp tăng thông lượng lên tới 2,5 lần và đẩy nhanh quá trình huấn luyện RL tới 40% trên mô hình Qwen3-8B.

08/09

Thứ Ba · 3 tin
DAIR.AI@dair_ai
NgànhĐiểm AI 45/100

Giải mã cấu trúc tư duy của AI: Các bước suy luận nằm sâu trong biểu diễn ẩn

// Beneath the Surface of Chains-of-Thought // Impressive paper on whether reasoning steps have int…

DịchNghiên cứu mới chỉ ra rằng các bước suy luận của AI không chỉ là văn bản mà có cấu trúc hình học riêng biệt trong không gian ẩn. Các thao tác như phân tích mục tiêu hay suy diễn được sắp xếp có hệ thống, cho thấy AI xây dựng logic dựa trên ngữ cảnh thay vì chỉ dự đoán từ ngữ.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

Đột phá cho mô hình ngữ cảnh dài: Phương pháp 'Trace as State' giúp tối ưu hóa suy luận

For hard long-context tasks, the paper suggests a simple fix: run the model again with its previous …

DịchPhương pháp mới sử dụng dấu vết suy luận làm trạng thái điều kiện, giúp mô hình tập trung vào các điểm trọng yếu trong ngữ cảnh dài, giải quyết triệt để tình trạng bỏ lỡ thông tin quan trọng. Kết quả thử nghiệm cho thấy hiệu suất vượt trội trong 26/27 bài kiểm tra.

07/09

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGiải mã tư duy của LLM: Cấu trúc hình học ẩn sau các chuỗi suy luận

Nghiên cứu này khám phá cách các mô hình ngôn ngữ lớn tổ chức các thao tác suy luận như phân tích mục tiêu và suy diễn trong không gian biểu diễn ẩn, chứng minh rằng các thao tác này có cấu trúc hình học riêng biệt và không phụ thuộc vào từ vựng.


Vì sao đáng đọc: Nghiên cứu chuyên sâu về cơ chế nội tại của LLM, giúp hiểu rõ cách mô hình 'tư duy' thực sự, rất quan trọng cho việc cải thiện khả năng suy luận của AI.
Tencent Hunyuan@TencentHunyuan
Sản phẩmĐiểm AI 62/100

Tencent Hunyuan ra mắt bản xem trước Hy4: Tối ưu hóa khả năng suy luận dài

✔️Hy4 preview just shipped an upgrade. You flagged it: long thinking + over-verification on complex …

DịchTencent đã cập nhật mô hình Hy4 preview nhằm khắc phục lỗi suy luận quá đà và xử lý tác vụ phức tạp hiệu quả hơn. Với 770B tham số, mô hình mới giúp giảm số vòng hội thoại và tiết kiệm token mà vẫn đảm bảo chất lượng phản hồi.

Yuchen Jin@Yuchenj_UW
Hướng dẫnĐiểm AI 50/100

Chi phí suy luận AI giảm 1000 lần sau 18 tháng: GLM-5.3 Flash vượt mặt o1 Pro

If you want to understand how fast AI is improving, look at intelligence per dollar. 1.5 years ago: …

DịchYuchen Jin chỉ ra rằng chỉ số 'trí tuệ trên mỗi đô la' đã tăng vọt khi GLM-5.3 Flash đạt hiệu năng vượt trội o1 Pro với mức giá rẻ hơn tới 1000 lần so với các mô hình cách đây 1,5 năm.

Thêm 1 nguồn khác đưa tinX: Kim (@kimmonismus)

05/09

Thứ Bảy · 1 tin

04/09

Thứ Sáu · 3 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 66/100

Nghiên cứu Trace as State: Thay đổi vị trí suy luận giúp tăng độ chính xác cho ngữ cảnh dài lên tới 50 điểm

Great tips on working with reasoning models. Normally you would append what the model figured out a…

DịchNghiên cứu mới đề xuất đặt các bước suy luận trước khối ngữ cảnh dài thay vì để ở cuối, giúp mô hình tận dụng thông tin dẫn dắt để xử lý tài liệu hiệu quả hơn, cải thiện đáng kể độ chính xác.

Testing Catalog@testingcatalog
Hướng dẫnĐiểm AI 67/100

Cùng sự kiệnGPT-6 Astra gây sốc với 99% điểm ARC-AGI: Bước tiến lớn về tư duy logic

OPENAI 🔥: Astra scored 63% on ARC-AGI-3 with a standard harness. > GPT-6 Astra surpasses the huma…

DịchGPT-6 Astra đạt 99% điểm trong bài kiểm tra ARC-AGI-3 nhờ khả năng tự xây dựng mô hình thế giới và ngôn ngữ logic riêng để giải quyết các tình huống lạ, vượt xa hiệu suất trung bình của con người.

Cùng sự kiện, tinh chọn hiển thị «GPT-6 Astra thiết lập kỷ lục mới trên ARC-AGI-3: Đạt 99% điểm số, vượt xa khả năng con người»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Google DeepMind và KAIST giới thiệu Declarative Attention: Cho phép mô hình tự kiểm soát phạm vi chú ý

Banger paper from Google DeepMind and colleagues. (bookmark it) A model reads its entire KV cache …

DịchNghiên cứu mới từ Google DeepMind và KAIST đề xuất phương pháp Declarative Attention, giúp các mô hình ngôn ngữ tự điều chỉnh cơ chế chú ý trong quá trình suy luận chuỗi, từ đó cải thiện độ chính xác.

03/09

Thứ Năm · 2 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (49 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Suy luận” | AIHOT.vn