Nghiên cứu mới từ Salesforce và UIUC cho thấy việc xóa ngẫu nhiên các token trong KV Cache mang lại hiệu quả tương đương các thuật toán phức tạp, đồng thời giúp tăng đáng kể tốc độ suy luận nhờ giảm tải tính toán.
Vì sao đáng đọc: Đây là một phát hiện mang tính 'phản trực giác' nhưng có tác động lớn đến tối ưu hóa hạ tầng AI, giúp giảm chi phí vận hành mô hình ngôn ngữ lớn một cách thực tế.
OceanStor M900 của Huawei tối ưu hóa suy luận AI quy mô lớn với dung lượng KV Cache lên tới 64 PB, độ trễ cực thấp 60μs và băng thông 40 TB/s, giúp tăng hiệu suất xử lý cho các cụm máy chủ AI.
DeepSeek vừa trình làng DeepSeek-V4.1-Flash, mô hình MoE đa phương thức 552 tỷ tham số hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token, hiện đã có sẵn trên Hugging Face.
Vì sao đáng đọc: Đây là bước tiến lớn về hiệu năng của DeepSeek với khả năng xử lý ngữ cảnh cực dài và tối ưu hóa bộ nhớ, thu hút sự quan tâm lớn từ cộng đồng AI.
Fathom giới thiệu phương pháp đọc KV cache linh hoạt dựa trên ngân sách bit cho từng truy vấn, giúp tăng tốc độ giải mã lên 1,67 lần ở quy mô 1 triệu token mà vẫn duy trì độ chính xác cao hơn so với các kỹ thuật hiện có.
Bài viết phân tích kỹ thuật chuyên sâu về DeepSeek-V4.1-Flash, làm rõ cách thức CED và CSA2 tối ưu hóa bộ nhớ KV Cache, đồng thời đánh giá đây là bước nhảy vọt về kiến trúc tương đương thế hệ V5.
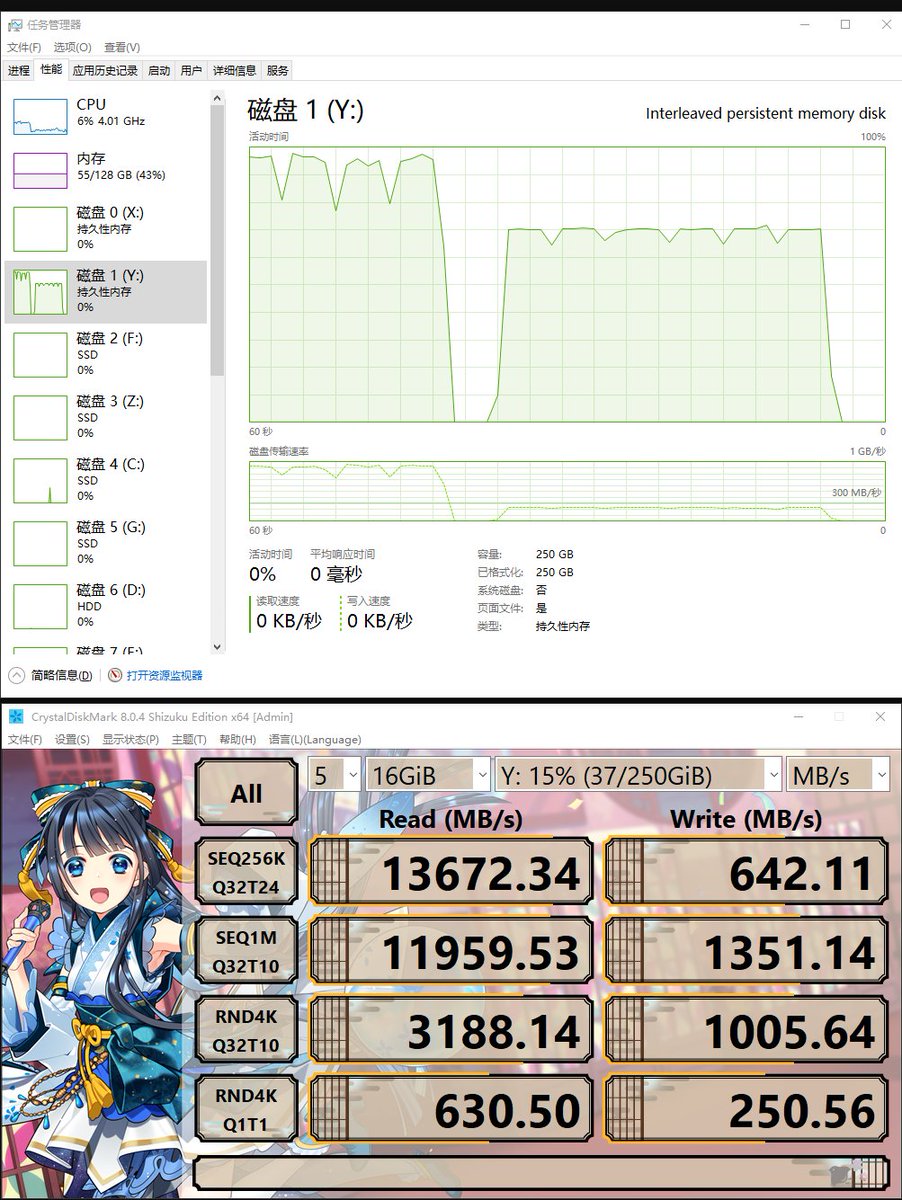
Thử nghiệm thực tế cho thấy Intel Optane PMem không hiệu quả cho KV Cache do tốc độ ghi chậm và giới hạn NUMA. Chuyên gia đề xuất sử dụng hạ tầng RDMA 400Gb để đạt băng thông 40GB/s, đảm bảo hiệu suất tối ưu cho các hệ thống suy luận AI tách biệt tài nguyên tính toán và lưu trữ.
Astera Labs giới thiệu dòng Leo X mới, cho phép chuyển tải KV Cache từ GPU sang bộ nhớ ngoài, giúp giảm độ trễ phản hồi đầu tiên tới 62% và tăng tốc độ xử lý token lên 22%.
GVA là phương pháp mới giúp giảm 45-47% dung lượng bộ nhớ KV cache bằng cách tái tạo khóa nội dung thông qua ánh xạ tuyến tính, thay vì lưu trữ toàn bộ, giúp tăng hiệu suất giải mã cho các mô hình Transformer.
Bài viết của Ma Bo giải thích tường tận mối liên hệ giữa Attention, Prefill, KV Cache và Prefix Caching, giúp bạn nắm vững nền tảng để hiểu sâu hơn về các kỹ thuật nâng cao như Multi-Head Latent Attention.
Bài viết giải thích cách tối ưu hóa LLM thông qua Prefill, lưu trữ KV cache và cơ chế Prefix Caching. Tác giả sử dụng ví dụ thực tế về truy vấn tài liệu để làm rõ giới hạn của việc tái sử dụng bộ nhớ đệm khi đầu vào thay đổi.
Bài viết giải thích cơ chế KV Cache trong suy luận LLM: K và V của các token trước được lưu lại để tái sử dụng, trong khi Q chỉ dùng cho vị trí hiện tại nên không cần lưu trữ.
Tác giả ví von kỹ thuật nén KV Cache của DeepSeek với cách con người chọn lọc ký ức: trưởng thành chính là quá trình tối ưu hóa bộ nhớ, giữ lại những điều cốt lõi để đưa ra quyết định sáng suốt hơn.
DeepSeek trình làng mô hình MoE 552B tham số với kiến trúc Causal Encoder-Decoder bất đối xứng, giúp tối ưu hóa bộ nhớ KV Cache và hỗ trợ đa phương thức thị giác.
DeepSeek-V4.1-Flash giới thiệu kiến trúc Causal Encoder-Decoder mới, cho phép tạo KV Cache toàn cục trực tiếp từ đầu ra của encoder. Cải tiến này giúp lược bỏ việc xử lý prompt qua toàn bộ các lớp decoder, từ đó tối ưu hóa đáng kể tốc độ tiền xử lý (prefill) cho mô hình.
Nice paper to improve inference efficiency. It's been a while we haven't seen good work on efficien…
DịchKVMem tối ưu hóa bộ nhớ cho AI Agent bằng cách phân trang và lưu trữ trạng thái KV trên GPU, RAM và NVMe. Hệ thống sử dụng cơ chế chỉ mục chú ý để truy xuất thông tin lịch sử liên quan, giúp xử lý ngữ cảnh siêu dài một cách hiệu quả.
BeaconKV giải quyết nút thắt bộ nhớ khi suy luận dài bằng cách xác định các 'Thought Revisiting Tokens' quan trọng, giúp nén KV cache hiệu quả mà không làm giảm khả năng truy xuất ngữ cảnh xa.
Vì sao đáng đọc: Giải pháp kỹ thuật thực tế, giải quyết vấn đề cấp bách về bộ nhớ GPU cho các mô hình suy luận dài (LRMs), có tính ứng dụng cao trong triển khai thực tế.
04/09
Thứ Sáu · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Salesforce giới thiệu Random Attention, phương pháp thay thế việc đánh giá token bằng cách loại bỏ ngẫu nhiên trong KV cache. Kỹ thuật này giúp tăng 32-43% lưu lượng xử lý trên vLLM mà vẫn duy trì độ chính xác tương đương các phương pháp tiên tiến nhất.
New Amazon paper shows KV-cache policy is not just an inference optimization; but it can change the …
DịchNghiên cứu mới của Amazon chỉ ra rằng việc đồng bộ hóa chiến lược KV Cache trong quá trình tinh chỉnh (fine-tuning) giúp mô hình tránh lỗi mất ngữ cảnh khi xử lý văn bản dài, thay vì chỉ tập trung vào tối ưu suy luận như trước đây.
CoinRAG cải thiện hiệu suất RAG bằng cách trích xuất và tái sử dụng các đơn vị thông tin nhỏ thay vì toàn bộ đoạn văn bản, giúp giảm độ trễ và tăng độ chính xác cho các truy vấn ngữ cảnh dài.