Hôm nay · 28/09

Thứ Hai · 1 tin

Hôm qua · 27/09

Chủ Nhật · 1 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 67/100

Cùng sự kiệnPrivatemode biến GLM-5.3-Flash thành mô hình ra quyết định có cấu trúc chỉ với một lần suy luận

Nhóm Privatemode giới thiệu kỹ thuật không cần tinh chỉnh, tận dụng log probability của GLM-5.3-Flash để thực hiện các quyết định có kiểu dữ liệu cụ thể chỉ trong một lần forward pass.

Cùng sự kiện, bài đại diện «Hướng dẫn sử dụng Jev: Kiểm duyệt nội dung với mô hình ra quyết định của TypeSafe trên OpenRouter»

25/09

Thứ Sáu · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 38/100

Dynamic Abliteration: Kỹ thuật loại bỏ từ chối không làm thay đổi trọng số trên Qwen3-4B

Phương pháp Dynamic Abliteration sử dụng PyTorch forward hooks để can thiệp vào luồng dư đa tầng, giúp vô hiệu hóa hành vi từ chối của Qwen3-4B mà không cần chỉnh sửa trọng số gốc, đảm bảo hiệu năng mô hình được giữ nguyên vẹn.

24/09

Thứ Năm · 2 tin
Jason Liu@jxnlco
Quan điểmĐiểm AI 30/100

Phải chăng phần cứng không đồng nhất là nguyên nhân khiến các mô hình AI 'trở nên ngốc nghếch'?

Whereas I mostly blame feature flags

DịchGiả thuyết cho rằng cảm giác mô hình bị 'giảm sức mạnh' thực chất đến từ việc sử dụng các loại phần cứng khác nhau (GPU, TPU, Inferentia) để xử lý tải trọng cao, dẫn đến chất lượng đầu ra không đồng nhất.

23/09

Thứ Tư · 2 tin
Simon Willison Blog
NgànhĐiểm AI 21/100

Simon Willison và Jesse Vincent tổ chức sự kiện giao lưu về Kỹ thuật Agent tại San Francisco

Vào ngày 14/10, Simon Willison và Jesse Vincent sẽ tổ chức buổi gặp mặt không chính thức tại San Francisco, nơi các nhà phát triển chia sẻ những thử nghiệm và dự án AI Agent đang dang dở mà không cần thuyết trình hay quảng bá sản phẩm.

22/09

Thứ Ba · 3 tin

21/09

Thứ Hai · 2 tin
Hugging Face: Blog
Mô hìnhĐiểm AI 46/100

Hugging Face ra mắt Tokenizers v1: Tối ưu hóa hiệu năng vượt trội

Hugging Face vừa phát hành Tokenizers v1 với tốc độ xử lý nhanh gấp hàng chục lần phiên bản cũ nhờ kiến trúc workspace mới, kỹ thuật SIMD và tối ưu hóa đa luồng, trong khi vẫn đảm bảo tính tương thích hoàn toàn với các token ID cũ.

Thêm 1 nguồn khác đưa tinX: Clément Delangue (Hugging Face CEO) (@ClementDelangue)
Ethan Mollick@emollick
Quan điểmĐiểm AI 32/100

Hiện tượng 'trôi ngôn ngữ' trên các tác vụ dài của LLM: Khi AI càng chạy càng... dở

It is ironic that the thing that is now most annoying about long-running agentic tasks with Large La…

DịchMột nghịch lý trớ trêu khi vận hành AI Agent lâu dài: thay vì lỗi code hay ảo giác, vấn đề lớn nhất lại là chất lượng ngôn ngữ của mô hình bị suy giảm dần theo thời gian, khiến văn phong trở nên kém tự nhiên.

19/09

Thứ Bảy · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 34/100

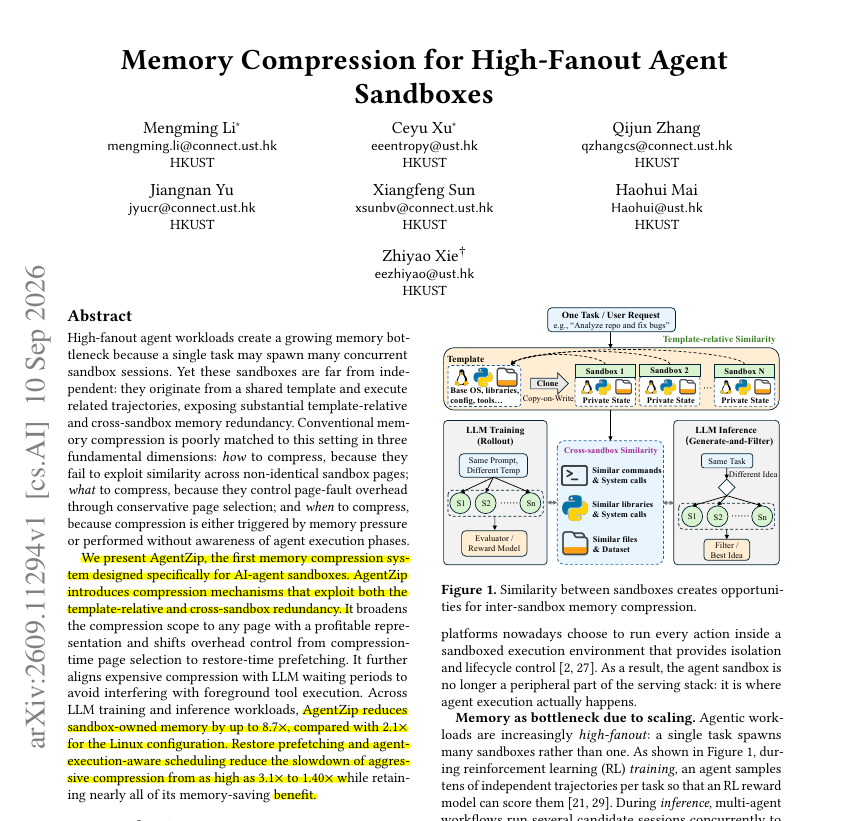
AgentZip: Giải pháp nén bộ nhớ dùng chung cho các tác nhân AI chạy song song

If 1 agent task launches many sandboxes, manage their memory together AgentZip shows that much of t…

DịchAgentZip tối ưu hóa hiệu suất bằng cách nén các dữ liệu trùng lặp trong bộ nhớ giữa các sandbox tác nhân AI. Công nghệ này giúp giảm tới 88,55% dung lượng bộ nhớ dư thừa khi chạy nhiều tác nhân từ cùng một khuôn mẫu, đặc biệt hiệu quả trong thời gian chờ phản hồi từ LLM.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 55/100

EvoSkill v2: Giúp AI tự nâng cấp kỹ năng mà không cần huấn luyện lại

Agents can self-improve without retraining. EvoSkill v2 achieves this with persistent agent skills….

DịchEvoSkill v2 cho phép các Agent tự học và lưu trữ kỹ năng mới vào tệp tin sau mỗi lần thất bại. Khi gặp tác vụ tương tự, Agent sẽ tự động tải các kỹ năng này để tối ưu hiệu suất mà không cần thay đổi trọng số mô hình.

18/09

Thứ Sáu · 1 tin

17/09

Thứ Năm · 2 tin
karminski@karminski3
Quan điểmĐiểm AI 19/100

Giả thuyết: Mô hình AI có thể thông minh và chính xác hơn khi xử lý đơn lẻ?

Một giả thuyết mới cho rằng khi chạy ở chế độ đơn luồng (concurrency=1), việc sử dụng GEMV thay vì GEMM trong quá trình lượng tử hóa cực hạn có thể giúp giảm thiểu sai số và cải thiện hiệu suất mô hình. Đây hiện chỉ là suy đoán cá nhân và chưa có dữ liệu thực nghiệm kiểm chứng.

LlamaIndex: Sản phẩm, kỹ thuật và đánh giá
Hướng dẫnĐiểm AI 49/100

Trích xuất tài liệu bằng AI: Tại sao Schema mới là mắt xích gây lỗi?

Nút thắt của AI trong trích xuất tài liệu không nằm ở mô hình mà ở cách định nghĩa Schema. Khi dữ liệu có nhiều giá trị cùng loại, việc thiếu quy tắc Schema cụ thể sẽ khiến hệ thống đưa ra các kết quả mâu thuẫn.

15/09

Thứ Ba · 8 tin
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 62/100

Giải mã Prefill và Decode: Tại sao AI đọc tài liệu dài mới phản hồi, nhưng viết lại càng lúc càng chậm?

Bài viết giải thích hai giai đoạn suy luận của LLM: Prefill xử lý song song đầu vào quyết định tốc độ phản hồi ban đầu (TTFT), trong khi Decode tạo văn bản từng token một và thường bị nghẽn băng thông bộ nhớ.

Thariq@trq212
NgànhĐiểm AI 10/100

Thariq chia sẻ về tập podcast chuyên sâu về không gian tiềm ẩn (latent space)

just finished recording on latent space I'm excited about this one- we get very technical about thi…

DịchThariq vừa hoàn thành ghi hình tập podcast mới, nơi anh đi sâu vào các chi tiết kỹ thuật chuyên môn về không gian tiềm ẩn (latent space) mà trước đây ít được đề cập.

Elvis Saravia@omarsar0
NgànhĐiểm AI 39/100

Tự xây dựng Agent Harness: Bí quyết cắt giảm chi phí Token hiệu quả

If you build your own harness, you can drive that cost down even further. Out-of-the-box agent harn…

DịchThay vì dùng các bộ khung (harness) cồng kềnh, việc tự xây dựng hệ thống tối giản giúp giảm đáng kể chi phí token thông qua tối ưu hóa prompt, gọi công cụ thông minh và kiểm soát luồng dữ liệu chặt chẽ.

14/09

Thứ Hai · 4 tin
karminski@karminski3
NgànhĐiểm AI 27/100

Tranh cãi về cường độ suy luận trên DeepSeek-V4.1-Flash: Nên chọn 'Max' hay 'High'?

Người dùng tranh luận về việc thiết lập cường độ suy luận trên DeepSeek-V4.1-Flash. Trong khi một số cho rằng cài đặt này không ảnh hưởng hiệu suất, tác giả dẫn chứng nghiên cứu DeepSeek-R1-Zero để khẳng định thời gian suy luận càng dài, năng lực giải quyết vấn đề càng cao.

karminski@karminski3
Hướng dẫnĐiểm AI 53/100

Karminski: Sự khác biệt giữa Skill và tài liệu truyền thống thông qua đồng cấu mã nguồn và dữ liệu

Karminski giải thích rằng trong khi tài liệu truyền thống chỉ là mã hoặc dữ liệu đơn thuần, 'Skill' sử dụng kỹ thuật siêu lập trình (metaprogramming) để đạt được sự đồng cấu, giúp mã nguồn và dữ liệu hòa làm một.

OpenRouter: Announcements
Hướng dẫnĐiểm AI 61/100

Tinh chọnHướng dẫn OpenRouter: Tự động đánh giá đầu ra của AI Agent bằng phương pháp LLM-as-a-judge

OpenRouter chia sẻ cách sử dụng mô hình AI làm giám khảo để chấm điểm tự động cho các phản hồi của AI Agent, giúp kiểm soát chất lượng các câu trả lời mở mà phương pháp kiểm thử truyền thống không làm được.


Vì sao đáng đọc: Đây là kỹ thuật thực tiễn cao cho các nhà phát triển AI, giúp tối ưu hóa quy trình kiểm thử và nâng cao chất lượng phản hồi của Agent một cách tự động.
Elvis Saravia@omarsar0
NgànhĐiểm AI 48/100

Kỹ sư AI có nên tự xây dựng Agent Harness thay vì phụ thuộc vào các nền tảng có sẵn?

Should you build an agent harness? I see lots of opinions about it. My thoughts: As an AI enginee…

DịchElvis Saravia từ DAIR.AI khuyên các kỹ sư nên coi 'agent harness' là cốt lõi của hệ thống thay vì chỉ là lớp vỏ bọc. Việc tự xây dựng giúp kiểm soát tốt hơn trong các lĩnh vực chuyên sâu như y tế, tài chính và tránh sự phụ thuộc vào nhà cung cấp mô hình.

13/09

Chủ Nhật · 3 tin

12/09

Thứ Bảy · 7 tin
Elvis Saravia@omarsar0
NgànhĐiểm AI 36/100

DAIR.AI công bố bộ sưu tập tài liệu kỹ thuật về 'Harness' cho AI Agent

Learn to build a harness, folks. It's not surprising to me that so many YC builders want to build d…

DịchElvis Saravia từ DAIR.AI giới thiệu bộ tài liệu về Harness, công cụ thiết yếu giúp xây dựng khung tương tác và tối ưu hóa trải nghiệm cho các AI Agent chuyên biệt trong kỷ nguyên mới.

Hongming@hongming731
NgànhĐiểm AI 44/100

Cùng sự kiệnĐiểm tin AI: Uber tối ưu chi phí mô hình, quản trị bộ nhớ Agent và ứng dụng AI tại JD.com

Bản tin tổng hợp cách Uber cắt giảm 52% chi phí hội thoại AI, kỹ thuật quản trị bộ nhớ dài hạn cho Agent của Alibaba và kinh nghiệm ứng dụng AI giúp JD.com rút ngắn 50% thời gian phát triển sản phẩm.

Cùng sự kiện, tinh chọn hiển thị «Anthropic đánh giá khả năng của AI trong tác chiến tình báo và phát triển vũ khí thông thường»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

Nghiên cứu từ LinkedIn: Bộ nhớ của AI Agent không thể tự động chuyển đổi khi nâng cấp mô hình

New Linkedin paper shows Agent memory is not automatically portable: fixed-schema memory survived …

DịchNghiên cứu chỉ ra rằng khi thay đổi mô hình, bộ nhớ dạng ghi chú tự do và chỉ mục RAG bị suy giảm hiệu suất đáng kể. Do đó, các doanh nghiệp cần thực hiện kiểm thử tính tương thích của bộ nhớ trước khi nâng cấp hệ thống AI.

Andrew Ng (DeepLearning.AI nhà sáng lập)@AndrewYNg
NgànhĐiểm AI 20/100

Andrew Ng: Kỹ năng kỹ thuật AI là chìa khóa để làm chủ quy trình phát triển sản phẩm

With AI Engineering skills, you actively shape the build: You influence what gets built, and drive t…

DịchAndrew Ng nhấn mạnh việc nắm vững kỹ thuật AI giúp bạn chủ động định hình và dẫn dắt toàn bộ vòng đời phát triển sản phẩm, thay vì chỉ là người thực thi.

Luis Velasco (OpenAI FDE)@luisvelasco
NgànhĐiểm AI 34/100

Bí quyết xây dựng đội ngũ kỹ sư triển khai tiên phong (FDE) tại OpenAI

You guys asked for this! This is what means being an FDE at OpenAI

DịchColin Jarvis từ OpenAI chia sẻ về cách vận hành đội ngũ FDE: ưu tiên tính khả thi trước khi mở rộng, tập trung vào chuyên gia lĩnh vực và mục tiêu cuối cùng là giúp khách hàng tự chủ công nghệ.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (43 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Kỹ thuật AI” | AIHOT.vn