25/09

Thứ Sáu · 2 tin
Google AI: DEV tác giả
Hướng dẫnĐiểm AI 53/100

Lưu trữ vector trong Postgres: So sánh hiệu năng giữa bảng nội dòng và bảng tách biệt trên AlloyDB Omni

Gleb Otochkin thực nghiệm trên AlloyDB Omni với 30.000 bản ghi để so sánh hiệu năng giữa việc lưu vector cùng bảng dữ liệu và dùng bảng tách biệt kết hợp JOIN trong các tác vụ tìm kiếm ngữ nghĩa và lọc dữ liệu.

@typesafeai@typesafeai
Hướng dẫnĐiểm AI 26/100

Jev: Công cụ tối ưu cho tác vụ khớp ngữ nghĩa và tái xếp hạng trong RAG

Keep cooking, most best practices with Jev have yet to be discovered!

DịchJev đang chứng minh hiệu quả vượt trội so với phương pháp đo độ tương đồng điểm tích truyền thống, trở thành lựa chọn lý tưởng cho cả việc tìm kiếm trực tiếp trên tập dữ liệu nhỏ và tái xếp hạng (reranking) trong các hệ thống RAG quy mô lớn.

24/09

Thứ Năm · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Knowledge Pull Requests: Phương pháp mới giúp cập nhật tài liệu thông minh và minh bạch

Knowledge Pull Requests (KPRs) là khung làm việc mới giúp tích hợp tri thức mới vào tài liệu hiện có bằng cách trích xuất, phân loại và đối chiếu thông tin, tạo ra nhật ký thay đổi chi tiết thay vì viết lại từ đầu.

22/09

Thứ Ba · 4 tin
LlamaIndex: Sản phẩm, kỹ thuật và đánh giá
Sản phẩmĐiểm AI 65/100

Tinh chọnLiteParse cập nhật tháng 9: Tăng tốc PDFium 25%, bổ sung định vị thị giác và API định tuyến

LlamaIndex ra mắt LiteParse 2.14.6 với tối ưu hóa bộ nhớ, giúp giảm thời gian trích xuất văn bản xuống còn 2,76ms/trang, đồng thời bổ sung tính năng định vị thị giác và API is-complex.


Vì sao đáng đọc: Cập nhật kỹ thuật quan trọng cho công cụ xử lý tài liệu phổ biến, mang lại cải thiện hiệu suất thực tế đáng kể cho các nhà phát triển ứng dụng RAG.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

D-RAC: Giải pháp chuẩn hóa tài liệu doanh nghiệp cho hệ thống RAG thông qua chuyển đổi PDF đa phương thức

D-RAC tối ưu hóa quy trình RAG bằng cách chuẩn hóa tài liệu sang PDF, sau đó dùng LLM đa phương thức chuyển đổi thành Markdown có cấu trúc, giúp tăng độ chính xác khi truy xuất dữ liệu.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

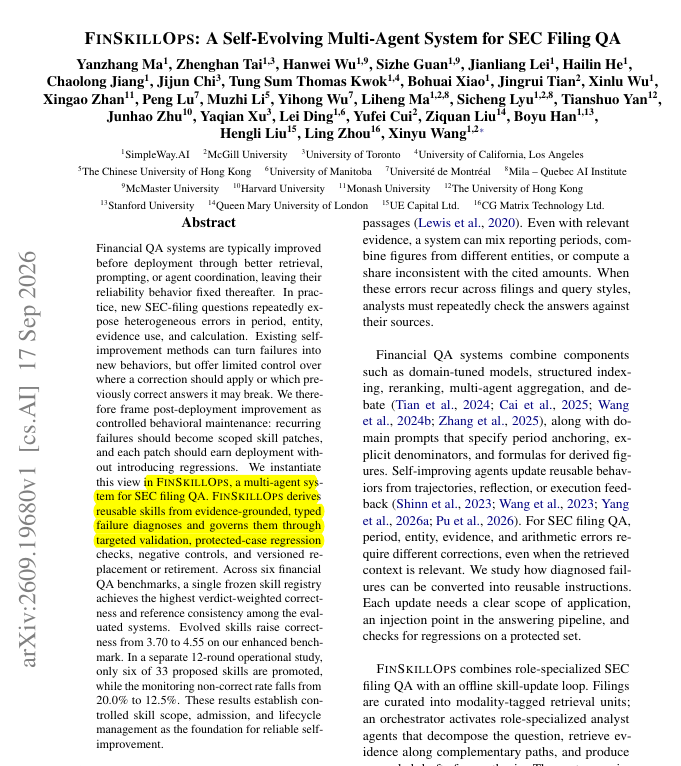
Harvard và MIT đề xuất phương pháp mới giúp AI tài chính tự cải thiện

New Harvard + MIT + other labs paper shows a cleaner path to self-improving financial AI: let the …

DịchCác nhà nghiên cứu giới thiệu FINSKILLOPS, hệ thống cho phép AI học hỏi từ lỗi sai trong phân tích tài chính thông qua cơ chế kiểm thử hồi quy nghiêm ngặt, giúp chuyển đổi RAG tĩnh thành hệ thống tự học bền vững.

Rohan Paul@rohanpaul_ai
Sản phẩmĐiểm AI 30/100

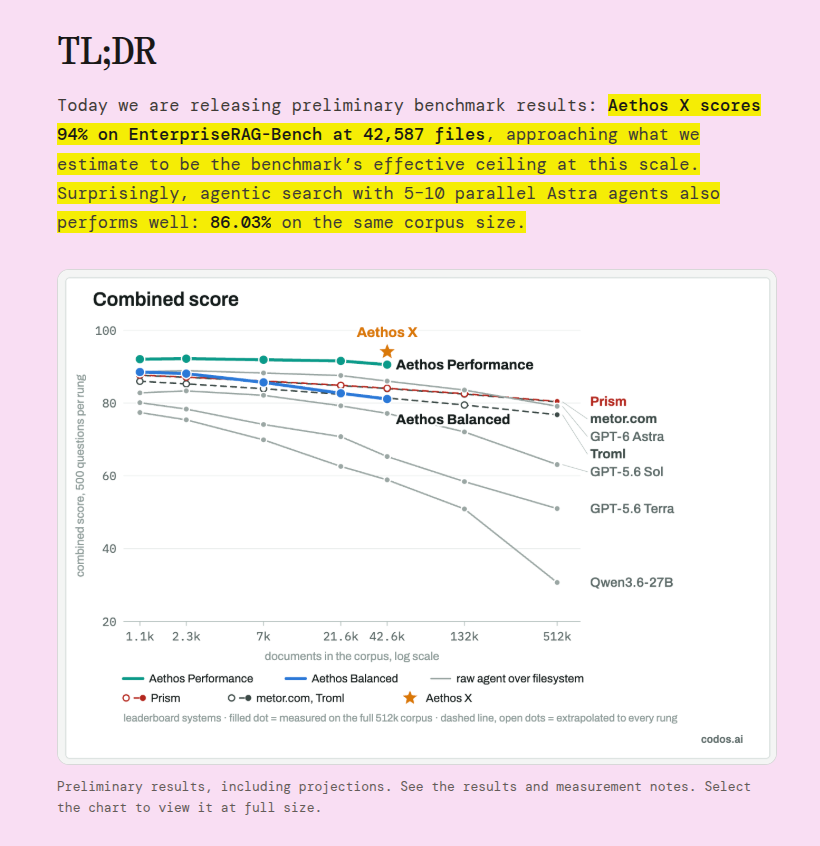
Codos ra mắt Giám đốc AI ảo đầu tiên, Aethos X đạt 94% điểm chuẩn EnterpriseRAG

Forward Deployed Engineers have a compounding problem: they spend months learning a company's syst…

DịchCodos giới thiệu giải pháp Giám đốc AI ảo giúp tự động hóa quy trình doanh nghiệp và triển khai bộ nhớ thông minh. Hệ thống Aethos X đạt 94% điểm trên EnterpriseRAG-Bench, vượt trội so với các mô hình hiện nay.

21/09

Thứ Hai · 1 tin

19/09

Thứ Bảy · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

SELF-INDEX: Khung tự tối ưu hóa chỉ mục cho hệ thống truy xuất thông tin

SELF-INDEX là khung làm việc tự động giúp chỉ mục truy xuất tự tiến hóa mà không cần can thiệp thủ công, thông qua cơ chế tự chẩn đoán lỗi và mô phỏng truy vấn để cải thiện hiệu suất tìm kiếm cho các hệ thống RAG và AI Agent.

18/09

Thứ Sáu · 4 tin
LlamaIndex: Sản phẩm, kỹ thuật và đánh giá
Sản phẩmĐiểm AI 41/100

LlamaParse ra mắt trình kết nối dữ liệu, hỗ trợ trực tiếp SharePoint và Google Drive

LlamaParse vừa bổ sung tính năng kết nối dữ liệu trực tiếp từ SharePoint và Google Drive, cho phép tự động đồng bộ và xử lý tài liệu mà không cần tải lên thủ công. Hệ thống sẽ tự động cập nhật các thay đổi, giúp tối ưu hóa quy trình trích xuất và lập chỉ mục dữ liệu cho nhà phát triển.

17/09

Thứ Năm · 1 tin

15/09

Thứ Ba · 1 tin

13/09

Chủ Nhật · 1 tin

12/09

Thứ Bảy · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

Nghiên cứu từ LinkedIn: Bộ nhớ của AI Agent không thể tự động chuyển đổi khi nâng cấp mô hình

New Linkedin paper shows Agent memory is not automatically portable: fixed-schema memory survived …

DịchNghiên cứu chỉ ra rằng khi thay đổi mô hình, bộ nhớ dạng ghi chú tự do và chỉ mục RAG bị suy giảm hiệu suất đáng kể. Do đó, các doanh nghiệp cần thực hiện kiểm thử tính tương thích của bộ nhớ trước khi nâng cấp hệ thống AI.

10/09

Thứ Năm · 1 tin
Perplexity@perplexity_ai
NgànhĐiểm AI 35/100

Perplexity ra mắt Q2D-Web: Chuẩn đánh giá mới cho hệ thống RAG và tìm kiếm web

We're introducing Q2D-Web (Query2Doc-Web), a benchmark and public leaderboard for evaluating retriev…

DịchPerplexity giới thiệu Q2D-Web, bộ tiêu chuẩn và bảng xếp hạng công khai nhằm đánh giá hiệu suất của các mô hình nhúng (embedding) khi thực hiện tìm kiếm web dựa trên truy vấn được tái cấu trúc bởi AI.

09/09

Thứ Tư · 2 tin
DAIR.AI@dair_ai
NgànhĐiểm AI 37/100

RSM-full: Phương pháp tối ưu bộ nhớ cho AI giúp tiết kiệm 68% token mà vẫn giữ 83% chất lượng

Good work on improving memory for long-horizon agents. They separate two things that agent memory p…

DịchRSM-full tách biệt quy trình ghi và đọc bộ nhớ, cho phép các tác nhân AI xử lý ngữ cảnh dài hiệu quả hơn. Với ngân sách 4k token, phương pháp này vượt trội hơn các mô hình RAG truyền thống và đạt hiệu suất tương đương với toàn bộ ngữ cảnh gốc.

07/09

Thứ Hai · 1 tin

03/09

Thứ Năm · 1 tin

02/09

Thứ Tư · 2 tin
ByteByteGo
Hướng dẫnĐiểm AI 56/100

Tại sao mô hình nhúng (Embedding) quyết định sự thành bại của hệ thống RAG?

ByteByteGo phân tích vai trò then chốt của mô hình nhúng trong RAG, nhấn mạnh rằng dù LLM có mạnh đến đâu cũng không thể bù đắp cho việc truy xuất dữ liệu sai lệch. Bài viết chỉ ra các lỗi thường gặp và lưu ý về chi phí vận hành khi thay đổi mô hình nhúng trong hệ thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Hi-Q: Tối ưu hóa truy vấn phân cấp dựa trên bằng chứng cho hệ thống hỏi đáp đa chặng

Hi-Q giải quyết vấn đề chênh lệch độ chi tiết giữa câu hỏi và dữ liệu bằng cách sử dụng cơ chế phân cấp thông minh. Hệ thống tự động kiểm tra bằng chứng để quyết định khi nào cần tinh chỉnh truy vấn, giúp cải thiện độ chính xác cho các tác vụ hỏi đáp phức tạp.

31/08

Thứ Hai · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

RAG bị tấn công đầu độc: Hiện tượng 'sụp đổ sự chú ý' và cách phòng chống

RAG poisoning can make a model more confident, which is exactly why confidence-based detectors can f…

DịchNghiên cứu chỉ ra rằng các tài liệu độc hại có thể thao túng mô hình RAG, khiến nó tập trung sai lệch vào dữ liệu xấu thay vì bằng chứng xác thực. Để phát hiện, cần giám sát sự phân bổ chú ý giữa các tài liệu thay vì chỉ dựa vào độ tin cậy của câu trả lời cuối cùng.

30/08

Chủ Nhật · 1 tin

28/08

Thứ Sáu · 1 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 75/100

Tinh chọnSổ tay kỹ sư AI: Xây dựng RAG, Agent và đánh giá mô hình trên Colab không cần framework

Bộ notebook thực hành giúp kỹ sư AI xây dựng hệ thống từ API gốc thay vì framework, bao gồm RAG, Agent và tinh chỉnh mô hình trên Groq miễn phí. Tài liệu cung cấp các case study thực tế, dễ dàng chuyển đổi sang OpenAI.


Vì sao đáng đọc: Nội dung cực kỳ thực dụng cho lập trình viên, tập trung vào kỹ năng cốt lõi thay vì phụ thuộc vào các framework phức tạp, rất phù hợp với cộng đồng AI Việt Nam.

27/08

Thứ Năm · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

RetrievalRouter: Tối ưu hóa quy trình truy xuất tài liệu bằng định tuyến thông minh

RetrievalRouter là bộ định tuyến nhẹ giúp tự động chọn quy trình truy xuất phù hợp nhất cho từng truy vấn, giúp cân bằng hiệu quả giữa độ chính xác và tốc độ phản hồi trong các lĩnh vực chuyên sâu như tài chính và khoa học.

26/08

Thứ Tư · 6 tin
Hugging Face: Blog
Hướng dẫnĐiểm AI 73/100

Tinh chọnHướng dẫn huấn luyện và tinh chỉnh mô hình nhúng đa vector với Sentence Transformers

Sentence Transformers v6.0 ra mắt MultiVectorEncoder, hỗ trợ truy xuất hậu tương tác kiểu ColBERT cùng quy trình huấn luyện toàn diện giúp tối ưu hiệu suất RAG.


Vì sao đáng đọc: Đây là bản cập nhật kỹ thuật quan trọng cho cộng đồng RAG, cung cấp công cụ mạnh mẽ để cải thiện độ chính xác truy xuất thông tin.

25/08

Thứ Ba · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

Định luật phân bổ ngữ cảnh trong tìm kiếm tạo sinh: Đo lường nhân quả và điều phối vòng lặp

Nghiên cứu mới chỉ ra rằng việc mở rộng cửa sổ ngữ cảnh không hiệu quả do suy giảm tương quan. Thay vào đó, phương pháp phân bổ lặp lại theo trình tự giúp tăng tỷ lệ thu hồi lên tới 20.5%, tối ưu hóa hiệu suất cho các hệ thống RAG.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 72/100

Tinh chọnChỉ một trang web độc hại cũng đủ thao túng gợi ý của LLM: Nghiên cứu về lỗ hổng của hệ thống RAG

Nghiên cứu mới với bộ tiêu chuẩn FORGE chỉ ra rằng các mô hình LLM trong hệ thống gợi ý rất dễ bị thao túng bởi nội dung rác, khiến chúng vô tình quảng bá sản phẩm giả mạo chỉ với một trang web bị nhiễm độc.


Vì sao đáng đọc: Nghiên cứu thực tế, đánh giá lỗ hổng bảo mật quan trọng trong các ứng dụng RAG thực tế, có tính ứng dụng cao cho các nhà phát triển hệ thống gợi ý.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 66/100

Nghiên cứu: Các kỹ thuật RAG nâng cao vô tình làm trầm trọng thêm lỗi từ nhận dạng giọng nói (ASR)

Nghiên cứu chỉ ra rằng việc sử dụng đồ thị thực thể và tái viết truy vấn trong RAG đa chặng làm khuếch đại sai sót từ ASR, khiến độ chính xác giảm mạnh hơn so với tìm kiếm thuần túy khi dữ liệu đầu vào bị nhiễu.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (54 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “RAG” | AIHOT.vn