Ma Dongxi chia sẻ về hành trình làm tiến sĩ từ 2018-2024, chứng kiến sự chuyển mình của NLP từ các mô hình BERT sơ khai đến kỷ nguyên LLM Agent bùng nổ.
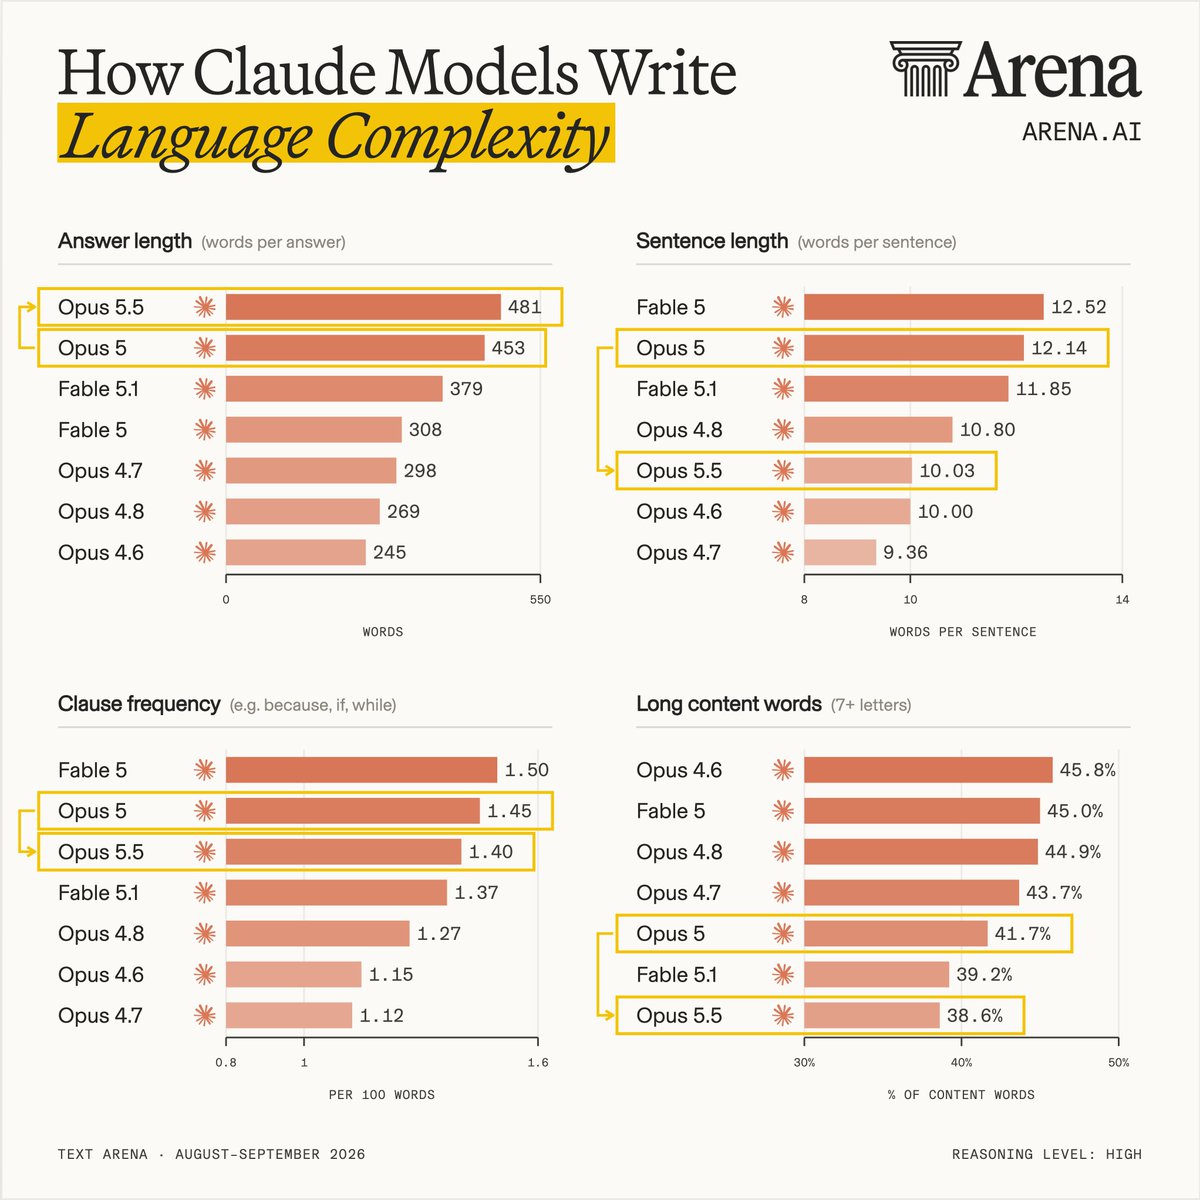
We analyzed how @claudeai's Opus 5.5 writes compared with Opus 5 across high-reasoning Text Arena ou…
DịchPhân tích từ Arena cho thấy Claude Opus 5.5 cải thiện 10/12 chỉ số viết so với Opus 5, với văn phong súc tích hơn, giảm đáng kể việc sử dụng dấu câu phức tạp và từ ngữ rườm rà.
FLEET cải thiện hiệu suất LLM bằng cách theo dõi các quỹ đạo có độ entropy cao để điều chỉnh logits, giúp tăng tốc độ tạo văn bản gấp 3 lần và cải thiện đáng kể độ chính xác trên LiveCodeBench.
Nghiên cứu sử dụng mô hình BlameBERT để phân tích dữ liệu nghị trường, phát hiện xu hướng chỉ trích hình "quả chuối": giảm dần đến năm 2016 và tăng vọt từ 2019, chịu ảnh hưởng mạnh mẽ bởi sự phân cực ý thức hệ.
Functionalizer là khung tiền xử lý mới giúp bảo toàn các biến thể từ vựng (như viết hoa, dấu câu) thông qua mã hóa opcode, giúp giảm kích thước từ vựng mà vẫn giữ nguyên độ chính xác khi giải mã.
Hugging Face vừa phát hành Tokenizers v1 với tốc độ xử lý nhanh gấp hàng chục lần phiên bản cũ nhờ kiến trúc workspace mới, kỹ thuật SIMD và tối ưu hóa đa luồng, trong khi vẫn đảm bảo tính tương thích hoàn toàn với các token ID cũ.
Việc chọn 'a' hay 'an' dựa trên phát âm thay vì chữ cái đầu. Tác giả đã phân tích hơn 32.000 từ và chứng minh rằng chỉ một số ít trường hợp ngoại lệ cần xử lý đặc biệt, đồng thời xây dựng mô hình trực quan hóa để xác định quy tắc này.
Linkup Research vừa phát hành mã nguồn mở SPARSEUP, mô hình nhúng dựa trên ModernBERT với 149M tham số. Đây hiện là mô hình mã hóa thưa mạnh nhất trong phân khúc dưới 150M tham số, đạt điểm nDCG@10 là 56.4 trên benchmark BEIR-13.
VākQA là bộ dữ liệu hỏi đáp tiếng Telugu gồm 2.001 cặp câu hỏi thực tế kèm âm thanh, giúp đánh giá khả năng hiểu ngôn ngữ ít tài nguyên của các mô hình AI. Nghiên cứu chỉ ra rằng các mô hình như Gemini vẫn gặp khó khăn trong việc đánh giá chính xác các câu trả lời đúng nhưng khác biệt về hình thức.
Knowledgator giới thiệu GLiFormer, khung mã hóa điều kiện schema giúp thực hiện NER, phân loại và trích xuất cấu trúc JSON mà không cần tạo token, tối ưu hóa hiệu suất cho các tác vụ NLP.
FLAT là khung tiền huấn luyện đột phá giúp đồng bộ hóa hình ảnh và văn bản vào không gian chuỗi 1D thống nhất, tối ưu hóa khả năng truy xuất và tạo nội dung với độ dài linh hoạt.
Các chuyên gia nhận định DeepSeek-V4.1-Flash và Jev đang đánh dấu sự quay trở lại của kiến trúc Encoder trong xử lý ngôn ngữ tự nhiên, khi mô hình chuyển đổi trực tiếp đầu vào thành xác suất thay vì chỉ dựa vào cơ chế Decoder truyền thống.
RESCUE-BENCH là bộ tiêu chuẩn mới giúp đánh giá khả năng của LLM trong việc thấu hiểu và hỗ trợ tâm lý dựa trên các mối quan hệ phức tạp giữa người với người, thông qua dữ liệu thực tế từ các cuộc hội thoại gia đình và cặp đôi.
Nghiên cứu khám phá khoảng cách giữa việc mô hình nhận diện thông tin và thời điểm sử dụng chúng. Kết quả cho thấy dù mô hình sớm nhận diện được trình độ chuyên môn của đối tác, nhưng phải đến các lớp sâu hơn thông tin này mới thực sự tác động đến phản hồi.
Nghiên cứu giới thiệu khung Conformal Relevance giúp tối ưu hóa độ chính xác và sự cô đọng của văn bản thông qua việc kết hợp các ví dụ học trong ngữ cảnh, giảm thiểu đáng kể công sức thiết kế prompt thủ công.
Enoki là khung trích xuất thông tin mở giúp phát hiện ảo tưởng ở cả cấp độ khẳng định và cấp độ đoạn văn bản, tối ưu hóa quy trình xác thực mà không cần các bước căn chỉnh phức tạp.
Nghiên cứu giới thiệu MaP-SQL, một hệ thống chọn lọc Text-to-SQL không cần tinh chỉnh, sử dụng bộ nhớ cấu trúc để đánh giá các truy vấn thay vì huấn luyện mô hình, giúp tối ưu hiệu suất và giảm chi phí.
Tác giả chỉ ra rằng con người học từ vựng qua trải nghiệm thực tế và sự kết hợp ý nghĩa, trong khi AI bắt đầu từ các mã token khô khan. Chính sự khác biệt ở điểm xuất phát này khiến ngôn ngữ của AI thiếu đi chiều sâu và sự kết nối thực sự với thế giới.
Tác giả chia sẻ lộ trình học NLP chuyên sâu, bắt đầu từ việc giải thích đơn giản và trực quan về Tokenizer, kèm theo video hướng dẫn giúp người xem dễ dàng nắm bắt các khái niệm kỹ thuật phức tạp.
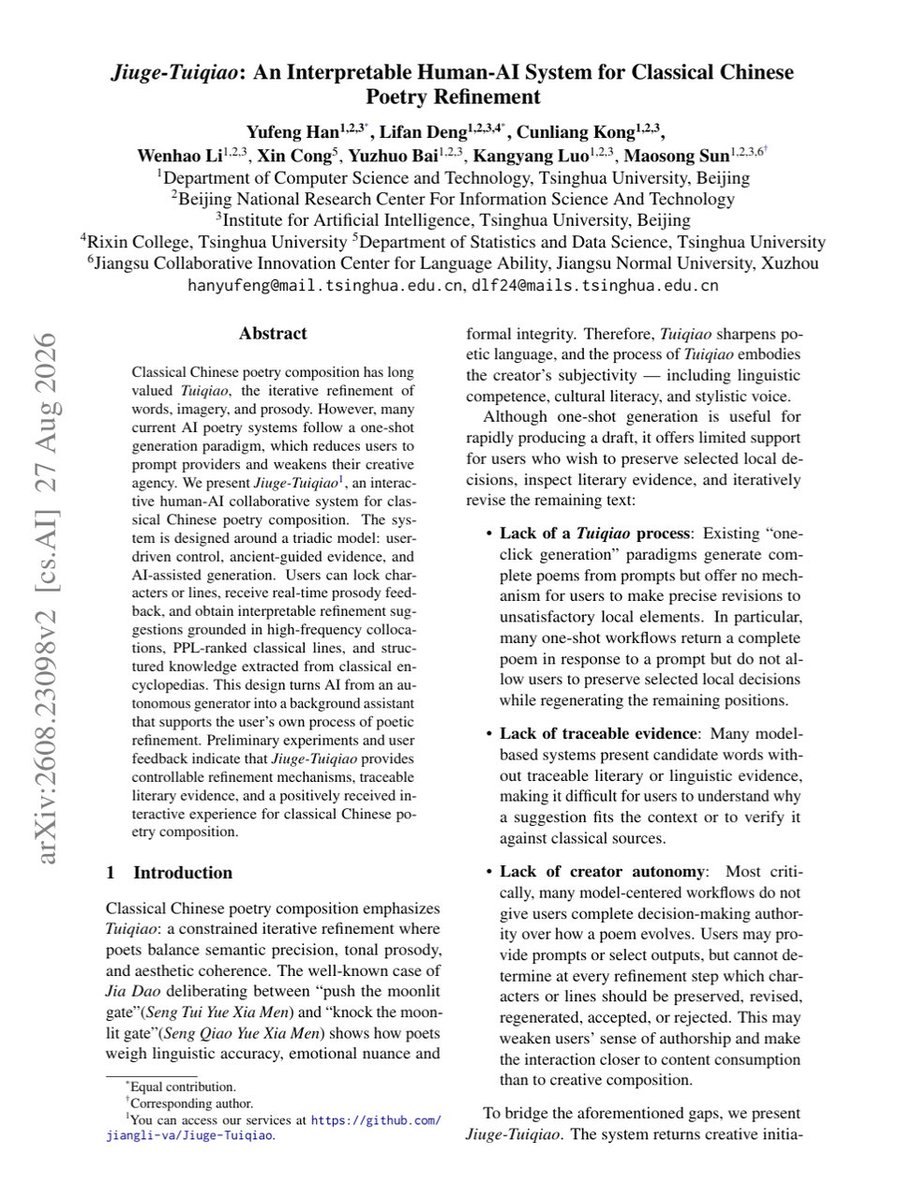
What if AI helped you refine a classical Chinese poem instead of simply writing one for you? Most AI…
DịchNhóm nghiên cứu từ Đại học Thanh Hoa giới thiệu Jiuge-Tuiqiao, công cụ cho phép người dùng khóa các từ khóa và để AI hỗ trợ hoàn thiện thơ cổ với độ chính xác về luật bằng trắc đạt 100%.
Sentence Transformers v6.0 ra mắt MultiVectorEncoder, hỗ trợ truy xuất hậu tương tác kiểu ColBERT cùng quy trình huấn luyện toàn diện giúp tối ưu hiệu suất RAG.
GLiNER 2.5 loại bỏ giới hạn độ rộng thực thể, hỗ trợ ngữ cảnh 4096 từ và tăng hiệu suất đáng kể trên các tác vụ zero-shot, giúp tối ưu hóa khả năng trích xuất thông tin đa ngôn ngữ.
IAR giới thiệu quy trình 3 bước (nạp, căn chỉnh, phục hồi) giúp chuyển đổi dữ liệu thành kiến thức tham số, cho phép mô hình trả lời chính xác mà không cần RAG. Phương pháp này cải thiện đáng kể hiệu suất trên nhiều dòng mô hình phổ biến như Llama, Qwen và Phi.
Superwhisper vừa phát hành S1-mini, mô hình 0.6B tham số dựa trên Qwen3, chuyên dùng để làm sạch văn bản từ nhận diện giọng nói bằng cách loại bỏ từ thừa và tự động thêm dấu câu.
Nghiên cứu giới thiệu khung làm việc mới giúp LLM vượt qua giới hạn của dữ liệu kể chuyện truyền thống, tạo ra 50.000 mẫu văn bản chất lượng cao thuộc 13 thể loại sáng tạo khác nhau như kịch bản, lời bài hát và thiết kế game.
Phiên bản Sentence Transformers v6.0 bổ sung MultiVectorEncoder, cho phép tích hợp trực tiếp các mô hình ColBERT và ColPali để tối ưu hóa khả năng truy xuất thông tin (RAG) với cơ chế tương tác muộn.
Vì sao đáng đọc: Đây là bản cập nhật quan trọng cho cộng đồng phát triển RAG, giúp đơn giản hóa việc triển khai các mô hình tìm kiếm đa vector vốn đang là xu hướng hiện nay.
ENTLORE là khung benchmark mới giúp đánh giá khả năng truy xuất và suy luận các mối quan hệ tổ chức phức tạp từ tài liệu doanh nghiệp, vốn thường bị ẩn đi trong các nguồn dữ liệu rời rạc.
UNMASK là quy trình tự động giúp phát hiện và loại bỏ các mối tương quan giả tạo mà mô hình ngôn ngữ thường lợi dụng để gian lận điểm số, giúp tăng cường độ tin cậy của mô hình trên dữ liệu thực tế mà không cần con người can thiệp.
 Ma Dongxi NLP@dongxi_nlp