Mô hình
Knowledgator ra mắt GLiFormer: Mô hình 575M tham số đạt 91.10 F1 trong trích xuất JSON lồng nhau
(giờ Việt Nam)
Tóm tắt AI
Knowledgator giới thiệu GLiFormer, khung mã hóa điều kiện schema giúp thực hiện NER, phân loại và trích xuất cấu trúc JSON mà không cần tạo token, tối ưu hóa hiệu suất cho các tác vụ NLP.
Bản dịch AI
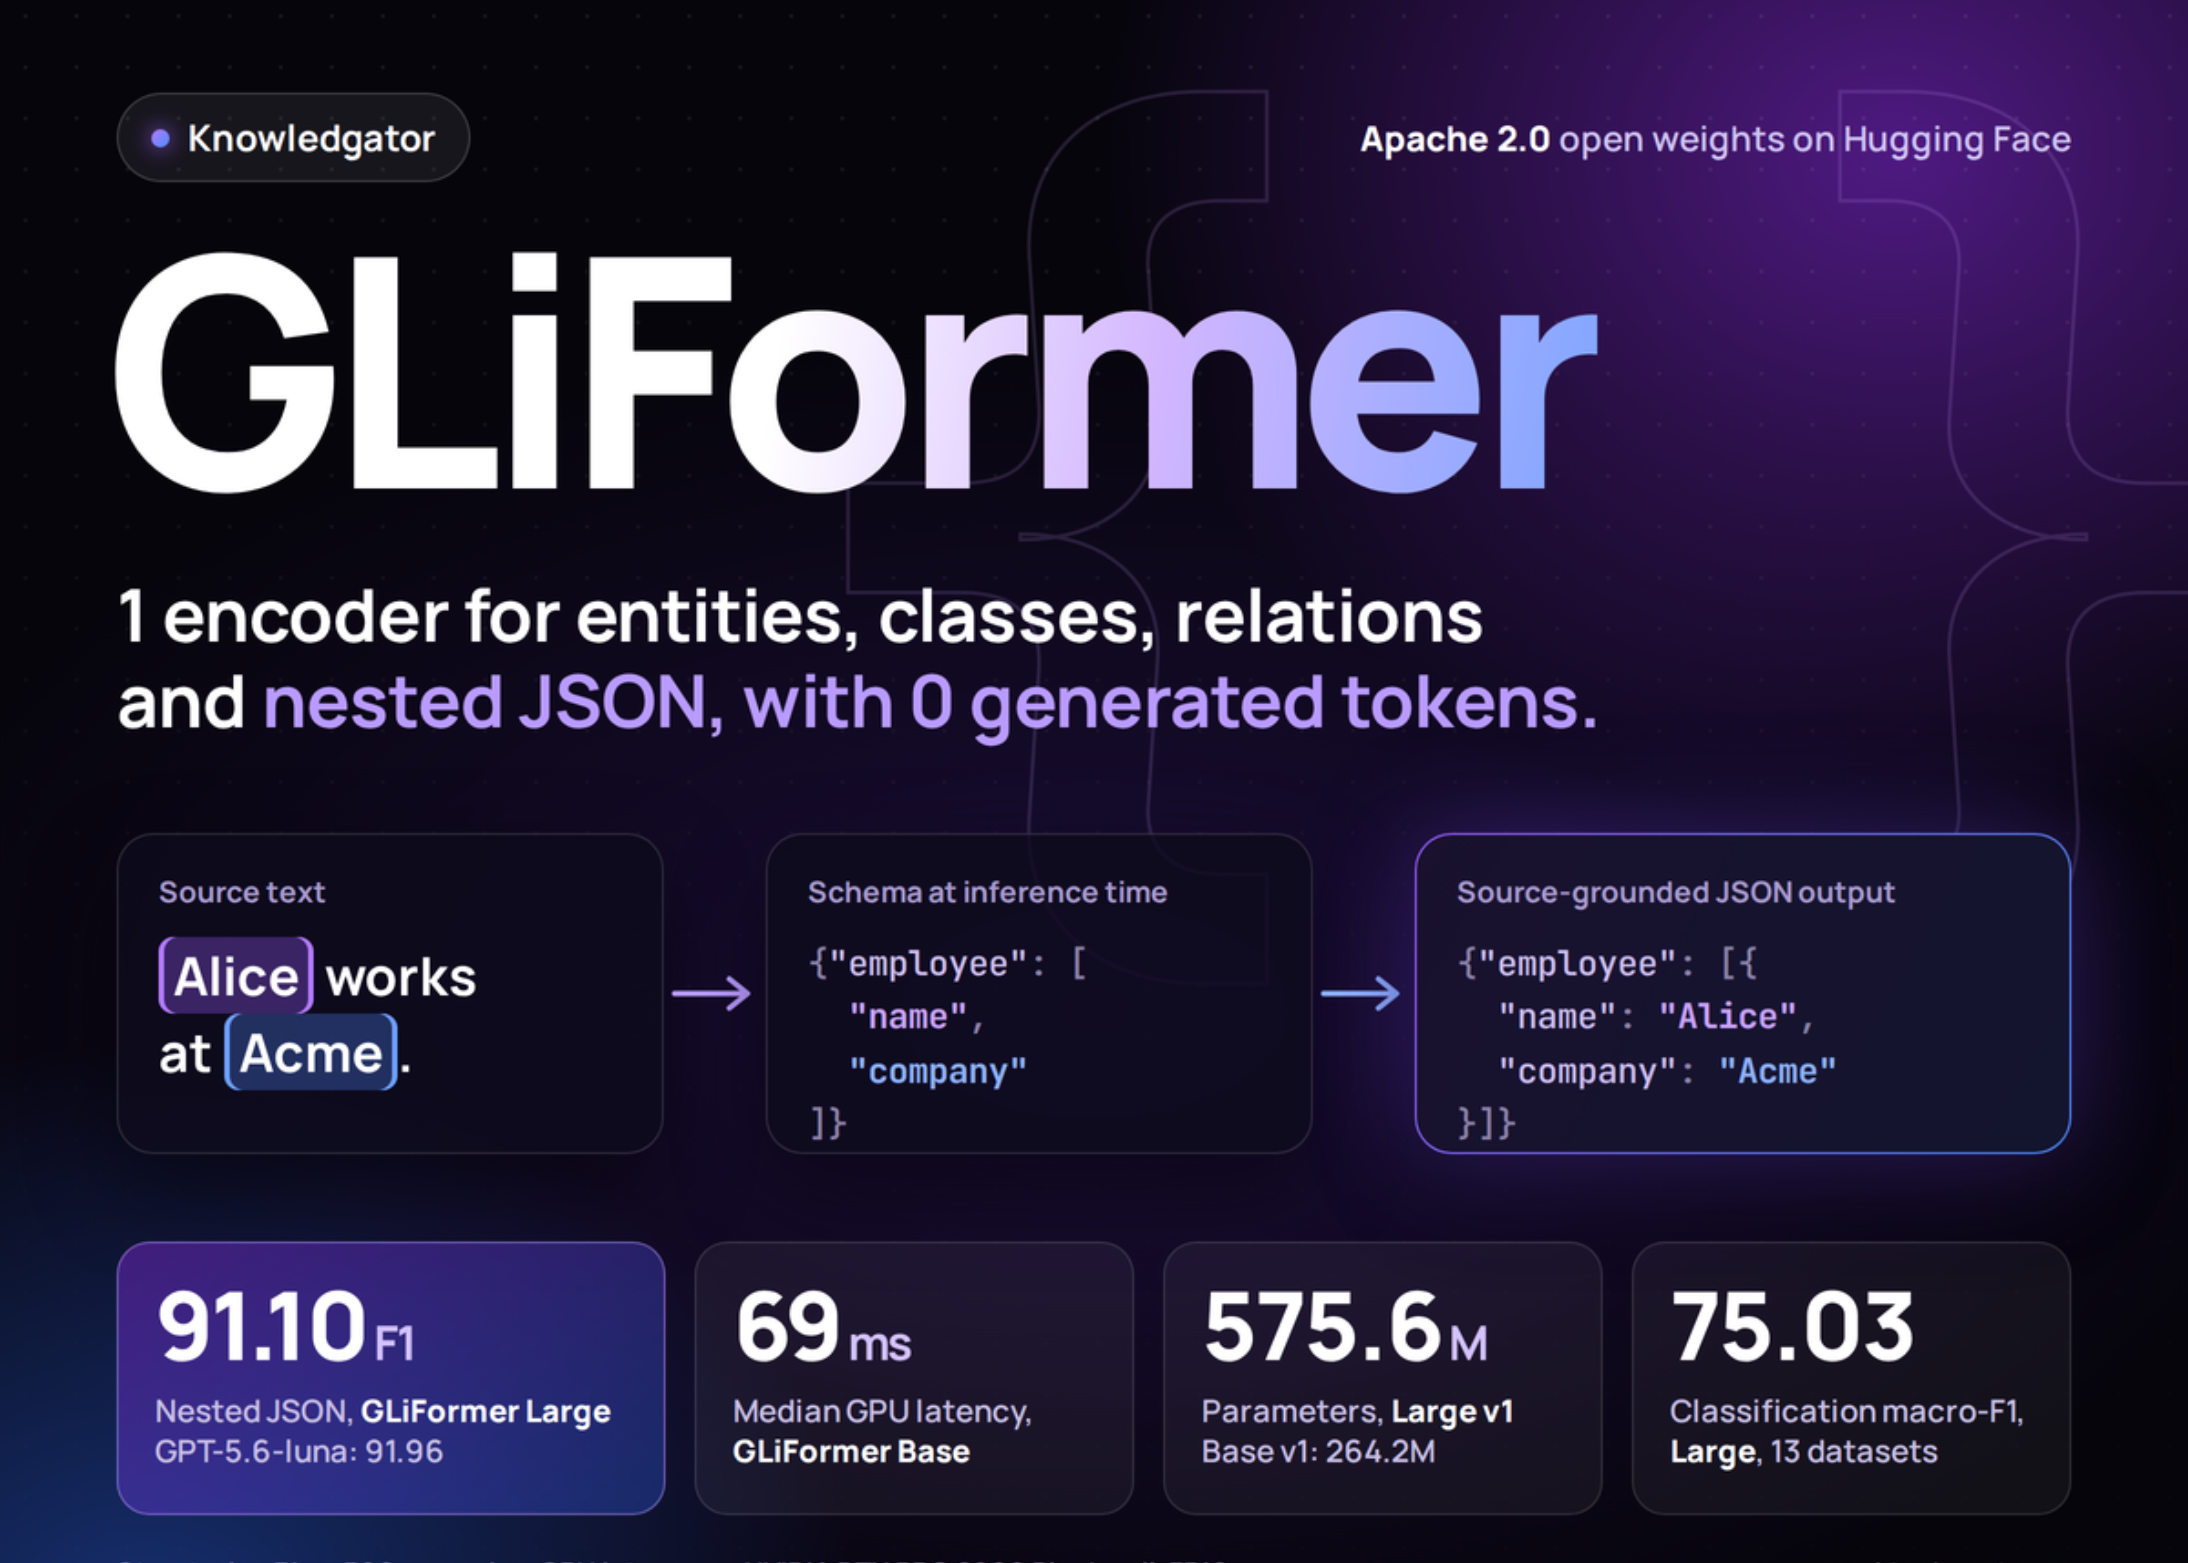
Knowledgator Engineering vừa ra mắt GLiFormer, một framework encoder có điều kiện theo lược đồ (schema-conditioned) dành cho tác vụ trích xuất thông tin. Một mô hình duy nhất có thể xử lý nhận dạng thực thể có tên (NER), phân loại văn bản, trích xuất quan hệ, cấu trúc hóa JSON lồng nhau và tạo text embeddings. Bạn chỉ cần truyền nhãn (labels) và lược đồ trích xuất (extraction schemas) tại thời điểm suy luận (inference). Hai checkpoint hiện đã có trên Hugging Face. GLiFormer Base v1 có 264,2 triệu tham số và GLiFormer Large v1 có 575,6 triệu tham số.
Có thể triển khai ngay bây giờ không? Có. Cả hai checkpoint đều sử dụng giấy phép Apache 2.0, cài đặt thông qua `pip install gliformer` và có thể chạy trên CPU hoặc GPU.
Vấn đề mà mô hình hướng tới
Các ngăn xếp (stack) trích xuất thông tin thường kết hợp nhiều mô hình riêng biệt. Một mô hình gắn nhãn thực thể, một mô hình phân loại tài liệu và một mô hình thứ ba để tái cấu trúc bản ghi. Nhóm nghiên cứu lập luận rằng các tác vụ này đều chia sẻ một thao tác cốt lõi: Mã hóa nguồn, biểu diễn các khái niệm được yêu cầu, sau đó tính điểm tương thích của chúng.
Các LLM có thể tạo ra JSON lồng nhau, nhưng chúng tạo ra tên trường, dấu câu và giá trị theo từng token một. GLiFormer loại bỏ việc tạo đầu ra khỏi quy trình đó.
Cách thức hoạt động của GLiFormer
GLiFormer được xây dựng dựa trên GLiNER và tổng quát hóa việc khớp nhãn thông qua một 'anchor' (điểm neo). Anchor là đối tượng mà mỗi nhãn thời gian chạy (runtime label) sẽ được so sánh để tính điểm. Nó có thể là một vector nhóm cho phân loại, một cặp thực thể cho quan hệ, hoặc một vị trí trong bản ghi (record slot).
Dữ liệu nguồn được mã hóa một lần. Nhiều lược đồ cho cùng một tài liệu sau đó sẽ chạy như các nhóm tác vụ cục bộ trên bản mã hóa dùng chung đó. Việc tính toán phần đầu (head compute) vẫn tăng theo số lượng nhóm, nhãn và anchor.
Đối với NER, phần đầu (head) sẽ tính điểm cho các bằng chứng bắt đầu, kết thúc và nằm trong (inside) cho mỗi cặp token và nhãn. Các đầu ra sigmoid độc lập cho phép các thực thể lồng nhau và các ranh giới dùng chung cùng tồn tại.
Quá trình cấu trúc hóa diễn ra qua 4 giai đoạn:
Các giá trị là các đoạn văn bản (spans) từ nguồn, vì vậy mô hình không thể tự tạo ra văn bản giá trị nếu nó không có trong đầu vào. Tuy nhiên, việc chọn đoạn văn bản, gán bản ghi và phân cấp vẫn có thể xảy ra sai sót.
Checkpoint và Đào tạo
Cả hai checkpoint v1 đều sử dụng loại mô hình `gliformer-layout` với 5 đầu (heads): NER, phân loại, quan hệ kết hợp, cấu trúc hóa đa cấp và embeddings. Mỗi cấu hình giới hạn độ rộng đoạn văn bản tối đa là 12 từ và 100 anchor bản ghi. Thông số kỹ thuật đầy đủ có trong tài liệu của các mô hình đã được huấn luyện trước.
GLiFormer-base bắt đầu từ backbone DeBERTa, được huấn luyện trước thêm trên 100 tỷ token. Bài báo ghi nhận 1.357.671 ví dụ cho việc đào tạo đa tác vụ trên diện rộng và 372.090 ví dụ cho việc hậu đào tạo tập trung vào tác vụ.
Điểm chuẩn (Benchmarks)
Tất cả các điểm số dưới đây đều do Knowledgator báo cáo.
Trên các tập hợp kết hợp giữa NER và phân loại, bài báo báo cáo rằng bản Large vượt trội hơn Gemma-4-E4B với số lượng tham số ít hơn khoảng 14 lần.
Tốc độ mà không cần tạo token
Knowledgator đã đo thời gian GLiFormer-base trên 40 tài liệu cấu trúc hóa với kích thước batch là 1. Độ trễ trung vị là 69 ms trên GPU NVIDIA RTX PRO 6000 Blackwell ở định dạng FP16. Trên CPU AMD EPYC 9B45 8 luồng ở định dạng FP32, con số này là 547 ms.
Tuyên bố chính về việc 'nhanh hơn tới 95,8 lần' là một ước tính phân tích, không phải là một lần chạy LLM thực tế. Nó giả định quá trình prefill ở mức 2.000 token đầu vào mỗi giây và tạo đầu ra ở mức 60 token mỗi giây. Nó không bao gồm hàng đợi, độ trễ mạng, suy luận ẩn và không giả định bất kỳ điều gì về sự tương đương về độ chính xác.
Cách sử dụng
Kho lưu trữ GitHub và model card hiển thị một lệnh gọi cấu trúc hóa ngắn gọn:
Các lược đồ Pydantic lồng nhau hoạt động cho các bản ghi đa cấp. Một lệnh gọi suy luận cũng có thể chạy đồng thời các thực thể, lớp và cấu trúc. Hãy sử dụng `joint_relations` cho các quan hệ, vì các checkpoint v1 thiếu một đầu quan hệ mở (open relation head).
Những điểm chính cần lưu ý
Hãy xem bài báo, trọng số mô hình, kho lưu trữ GitHub và tài liệu. Mọi công lao đều thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia cộng đồng 150k+ ML SubReddit của chúng tôi và đăng ký nhận bản tin. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá kho lưu trữ GitHub, trang Hugging Face, bản phát hành sản phẩm hoặc hội thảo trực tuyến của bạn? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng Truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về tin tức học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào với hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với độc giả.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.