Baseten Base Labs công bố nghiên cứu so sánh hiệu quả giữa huấn luyện trực tiếp GRPO và phương pháp chưng cất qua SFT với giáo viên gpt-5.6-sol trên các dòng mô hình Qwen3, thử nghiệm qua 16 tác vụ suy luận.
Hướng dẫn cách sử dụng mô hình Qwen3-0.6B-GGUF để tạo bộ phân loại xác suất siêu nhẹ, cho phép chạy cục bộ hoàn toàn mà không cần gửi dữ liệu ra ngoài.
Impressive paper showing the impact of a good harness. Improves Qwen3-8B from 41.2% to 91.8% on lon…
DịchGAVEL giúp Qwen3-8B tăng vọt tỷ lệ thành công trong các tác vụ robot dài hạn từ 41,2% lên 91,8% bằng cách sử dụng mô hình thế giới dạng đồ thị để dự đoán hậu quả và xử lý lỗi mà không cần can thiệp vào mô hình gốc.
Ant Group vừa phát hành Realtime-Venus trên Hugging Face, mô hình 9B đa phương thức hỗ trợ tương tác toàn song công, được xây dựng trên nền tảng kiến trúc Omni-Flow và Qwen3-8B.
Ant Group giới thiệu SingProbe, mô hình kiểm soát an toàn (guardrail) tích hợp trên Qwen3-4B, giúp đánh giá ý định, độ an toàn và rủi ro ảo tưởng theo thời gian thực với chi phí tính toán cực thấp.
Ant Group giới thiệu Qwen3-8B-singprobe, mô hình giám sát luồng giúp phát hiện ý định độc hại và ảo tưởng của AI theo thời gian thực với chi phí tính toán cực thấp, dưới 0,5%.
Ant Group giới thiệu mô hình Qwen3-0.6B-singprobe, tận dụng trạng thái ẩn của mô hình nền để phát hiện rủi ro an toàn và ảo tưởng theo từng token với chi phí vận hành cực thấp.
Humans usually need the foundations before the advanced skill; we need to know the basics before the…
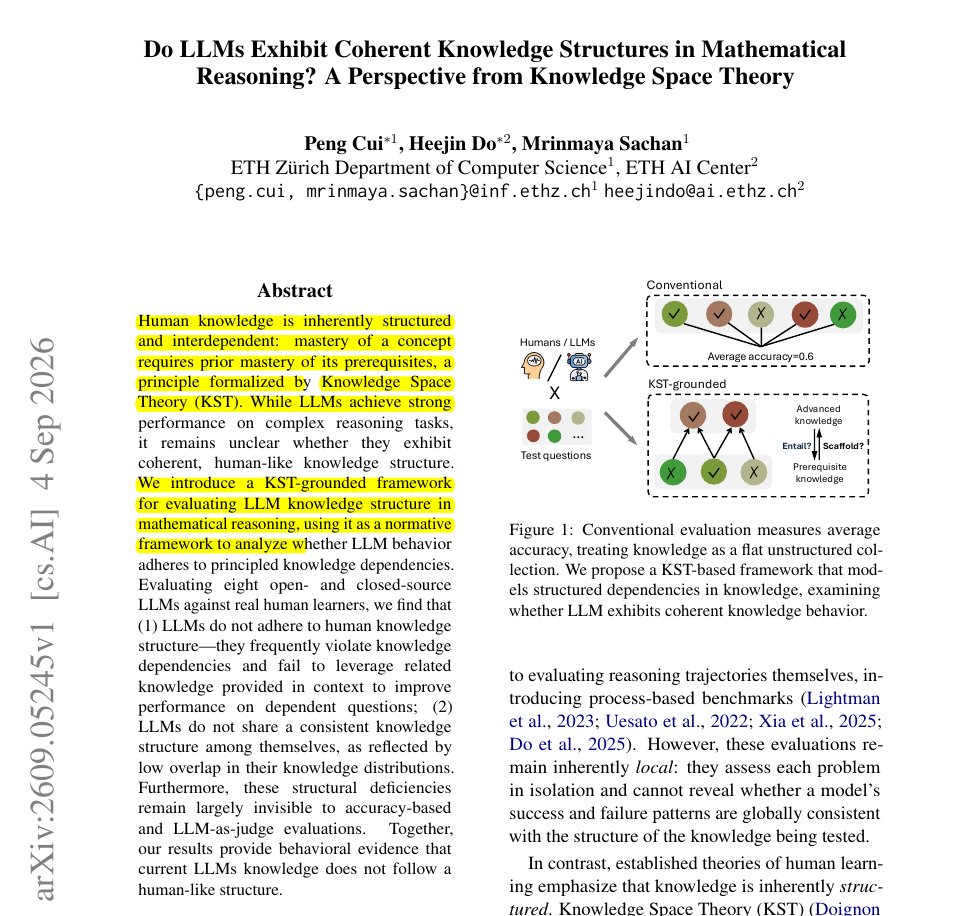
DịchNghiên cứu cho thấy dù Qwen3-80B đạt điểm cao hơn con người trong các bài kiểm tra, nhưng chỉ 48% câu trả lời đúng của nó đảm bảo được tính logic từ các kiến thức nền tảng, cho thấy mô hình AI hiện nay dễ bị 'học vẹt' thay vì hiểu sâu.
Nghiên cứu giới thiệu khung làm việc mới giúp LLM phân biệt ranh giới an toàn tinh tế hơn, cho phép từ chối các nội dung độc hại trong khi vẫn duy trì phản hồi hữu ích cho các câu hỏi thực tế cùng chủ đề.
New Meta paper says giving an agent more memory and tools is not enough if the agent never learns wh…
DịchNghiên cứu mới từ Meta giới thiệu EvoHarness-RL, phương pháp huấn luyện RL giúp AI tự quyết định thời điểm dùng công cụ thay vì truy cập liên tục, giúp Qwen3-8B tăng vọt hiệu suất giải quyết tác vụ phức tạp.
Superwhisper vừa phát hành S1-mini, mô hình 0.6B tham số dựa trên Qwen3, chuyên dùng để làm sạch văn bản từ nhận diện giọng nói bằng cách loại bỏ từ thừa và tự động thêm dấu câu.
Hướng dẫn chi tiết quy trình tinh chỉnh LoRA cho mô hình Qwen3-0.6B, tập trung vào kỹ thuật gọi công cụ (tool-calling) thông qua định dạng ChatML và tối ưu hóa hàm mất mát.