Nghiên cứu
Nghiên cứu từ Baseten Base Labs: Khi nào kỹ thuật chưng cất hỗ trợ học tăng cường?
(giờ Việt Nam)
Tóm tắt AI
Baseten Base Labs công bố nghiên cứu so sánh hiệu quả giữa huấn luyện trực tiếp GRPO và phương pháp chưng cất qua SFT với giáo viên gpt-5.6-sol trên các dòng mô hình Qwen3, thử nghiệm qua 16 tác vụ suy luận.
Chính văn · Bản dịch AI
Giới thiệu
Chúng tôi rất quan tâm đến sự tương tác giữa chưng cất (distillation) và học tăng cường (reinforcement learning - RL). Rõ ràng, phần lớn những tiến bộ về năng lực của các mô hình ngôn ngữ lớn (LLM) gần đây là nhờ vào việc mở rộng quy mô RL, cả về tài nguyên tính toán lẫn số lượng môi trường. Chưng cất thường được xem là một cách để khởi động mô hình nhằm chuẩn bị cho RL. Điều này là do trong RL, chúng ta cần một mức phần thưởng khởi đầu khác không để mô hình có thể leo dốc (hill-climb), và nếu chúng ta có thể đi từ mức không lên mức khác không bằng cách huấn luyện trên một vài dấu vết (traces) từ một mô hình tốt hơn, thì chúng ta sẽ khai thác được giá trị của toàn bộ môi trường RL.
Do đó, chưng cất được coi là một "cái nạng" được các phòng thí nghiệm mô hình mã nguồn mở sử dụng như một cách để bám đuổi các phòng thí nghiệm mô hình đóng với các mô hình mạnh hơn. Tuy nhiên, vẫn chưa rõ việc chưng cất từ một mô hình mạnh hơn có thể ảnh hưởng như thế nào đến giới hạn trên (và giới hạn dưới) đối với năng lực của mô hình mà bạn đang huấn luyện. Tại đây nảy sinh một số câu hỏi thú vị:
- Việc tuân thủ chính sách (on-policy) trong chưng cất quan trọng đến mức nào? Ví dụ, nếu tôi huấn luyện trên một dòng mô hình hoàn toàn khác, liệu điều này có làm hỏng mô hình của tôi sau này không? Liệu nó có làm giảm entropy theo cách nào đó không? Tôi cần bao nhiêu RL để sửa chữa điều này?
- Giả sử tôi có một ngân sách tính toán cố định. Liều lượng tối ưu giữa chưng cất và RL là bao nhiêu? Giả định rằng nhiều chưng cất hơn không phải lúc nào cũng tốt hơn một cách đơn điệu, điều này có thể mang lại cho chúng ta một kết quả thú vị.
Dựa trên ý tưởng cốt lõi đằng sau những câu hỏi này, chúng tôi nghiên cứu xem liệu SFT trên các giải pháp do giáo viên tạo ra có cải thiện RL sau đó hay không. Chúng tôi so sánh các mô hình Qwen3 với 0,6 tỷ, 1,7 tỷ, 4 tỷ và 8 tỷ tham số, được huấn luyện bằng GRPO trực tiếp hoặc sau khi tinh chỉnh trên các giải pháp giáo viên đã được xác thực, trên mười sáu tác vụ suy luận. Chúng tôi nhận thấy rằng chưng cất giúp cải thiện độ chính xác trước khi thực hiện RL ở mọi kích thước mô hình, nhưng lợi ích của nó sau khi thực hiện RL lại phụ thuộc vào cả kích thước học viên (ví dụ: Qwen3) và tác vụ. Các mô hình nhỏ hơn (0,6 tỷ và 1,7 tỷ) giữ lại được những lợi ích đáng kể, nhưng lợi ích này giảm dần ở các kích thước lớn hơn (4 tỷ và 8 tỷ). Thật vậy, ở mức 8 tỷ, mô hình được huấn luyện chỉ với RL cho hiệu suất tổng thể tốt hơn, mặc dù sự cải thiện này tập trung vào một nhóm các tác vụ tính toán. Nhìn chung, kết quả của chúng tôi cho thấy độ chính xác cao hơn trước khi thực hiện RL (do chưng cất) không nhất thiết mang lại độ chính xác cao hơn sau khi thực hiện RL, với việc chưng cất trở nên ít giá trị hơn khi kích thước của học viên tăng lên.
Thiết lập thực nghiệm
Chúng tôi đã sử dụng các mô hình Qwen3 với 0,6 tỷ, 1,7 tỷ, 4 tỷ và 8 tỷ tham số. Ở mỗi kích thước, chúng tôi so sánh RL thuần túy, áp dụng GRPO trực tiếp vào checkpoint cơ sở, và SFT + RL, trong đó trước tiên tinh chỉnh cùng checkpoint đó trên các giải pháp do giáo viên tạo ra bằng SFT. Trong suốt công trình này, chưng cất đề cập đến việc huấn luyện có giám sát trên các phản hồi của giáo viên.
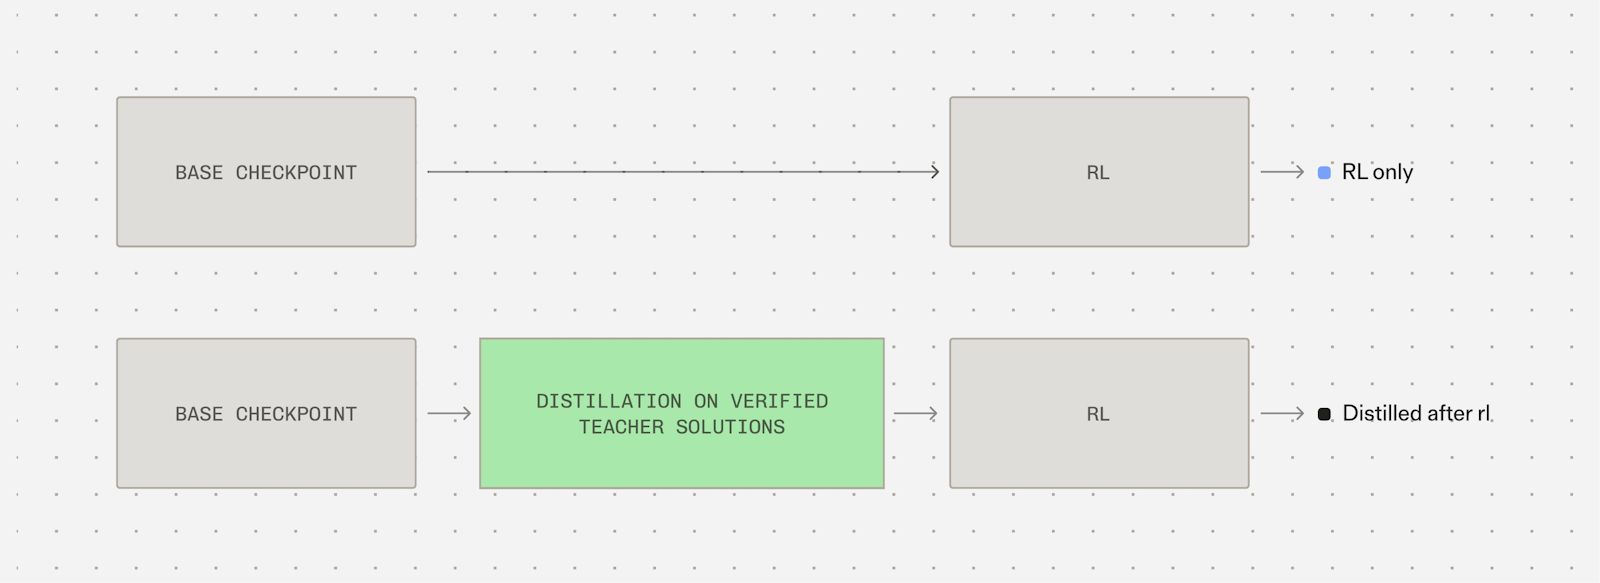
Để tạo dữ liệu SFT, chúng tôi đã sử dụng một giáo viên cố định, gpt-5.6-sol. Mỗi học viên được tinh chỉnh trên các tập con dữ liệu chứa 0,5 triệu, 1 triệu, 2 triệu hoặc 4 triệu token phản hồi của giáo viên này (các tập dữ liệu này được xây dựng sao cho các tập dữ liệu lớn hơn chứa các tập con nhỏ hơn).
Thí nghiệm chính của chúng tôi so sánh đường cơ sở RL với SFT trên 2 triệu token phản hồi, sau đó là RL. Chúng tôi đã lặp lại quá trình huấn luyện RL ba lần cho mỗi điều kiện bắt đầu ở mỗi kích thước mô hình. Để kiểm tra xem lượng dữ liệu SFT ảnh hưởng đến hiệu suất như thế nào, chúng tôi cũng đã chạy RL một lần cho mỗi sự kết hợp giữa học viên và kích thước dữ liệu, bao gồm cả đường cơ sở RL.
Dữ liệu huấn luyện do giáo viên tạo ra
Học viên được huấn luyện ở định dạng hoàn thành thô (raw completion format). Chúng tôi làm điều này để tránh sự nhầm lẫn khi chưng cất dạy định dạng trò chuyện (chat format). Mỗi ví dụ kết hợp một câu lệnh vấn đề với một phản hồi của giáo viên. Câu lệnh được ẩn khỏi hàm mất mát SFT và giảm thiểu cross-entropy của token tiếp theo trên phản hồi của giáo viên cùng với token kết thúc chuỗi được đính kèm. Dưới đây là một ví dụ (chúng tôi thêm ngắt dòng để dễ đọc):
Prompt — excluded from the SFT loss:

Solve each problem. Reason step by step if needed, then write
exactly one final answer between `<answer>` and `</answer>`
tags. The closing `</answer>` tag must be the final text you
write. Stop immediately after it and do not write anything else.

Problem:
Tell me whether 2116 is a leap year. Answer with Yes or No.

Solution:Target — included in the SFT loss, including the appended EOS:
<think>2116 is divisible by 4 and not divisible by 100, so it is
a leap year under the Gregorian
rules.</think><answer>Yes</answer><|endoftext|>Các phản hồi của giáo viên chứa một phần suy luận bằng văn bản trong thẻ <think> và câu trả lời cuối cùng trong thẻ <answer>. Chúng tôi chỉ giữ lại các phản hồi chính xác được hoàn thành mà không đạt đến giới hạn tạo văn bản, đồng thời đáp ứng các kiểm tra về độ dài (từ 256 đến 1.536 token) và định dạng cụ thể cho từng tác vụ. Phụ lục A mô tả các thí nghiệm sơ bộ được sử dụng để phát triển các quy trình này.
Các tác vụ
Chúng tôi đã chọn mười sáu tác vụ từ Reasoning Gym (Stojanovski và cộng sự, 2025), một thư viện các vấn đề suy luận được tạo ra với các câu trả lời có thể xác minh. Đối với các vấn đề này, chúng tôi đã tạo các trường hợp huấn luyện và đánh giá ở các mức độ khó khác nhau và nhóm các tác vụ thành tám tác vụ tính toán và tám tác vụ có cấu trúc. Ví dụ, các tác vụ tính toán bao gồm các bài toán như nhân hoặc phân số, Phụ lục B cung cấp chi tiết chính xác về tác vụ.
Kết quả
Lợi ích của chưng cất phụ thuộc vào kích thước học viên
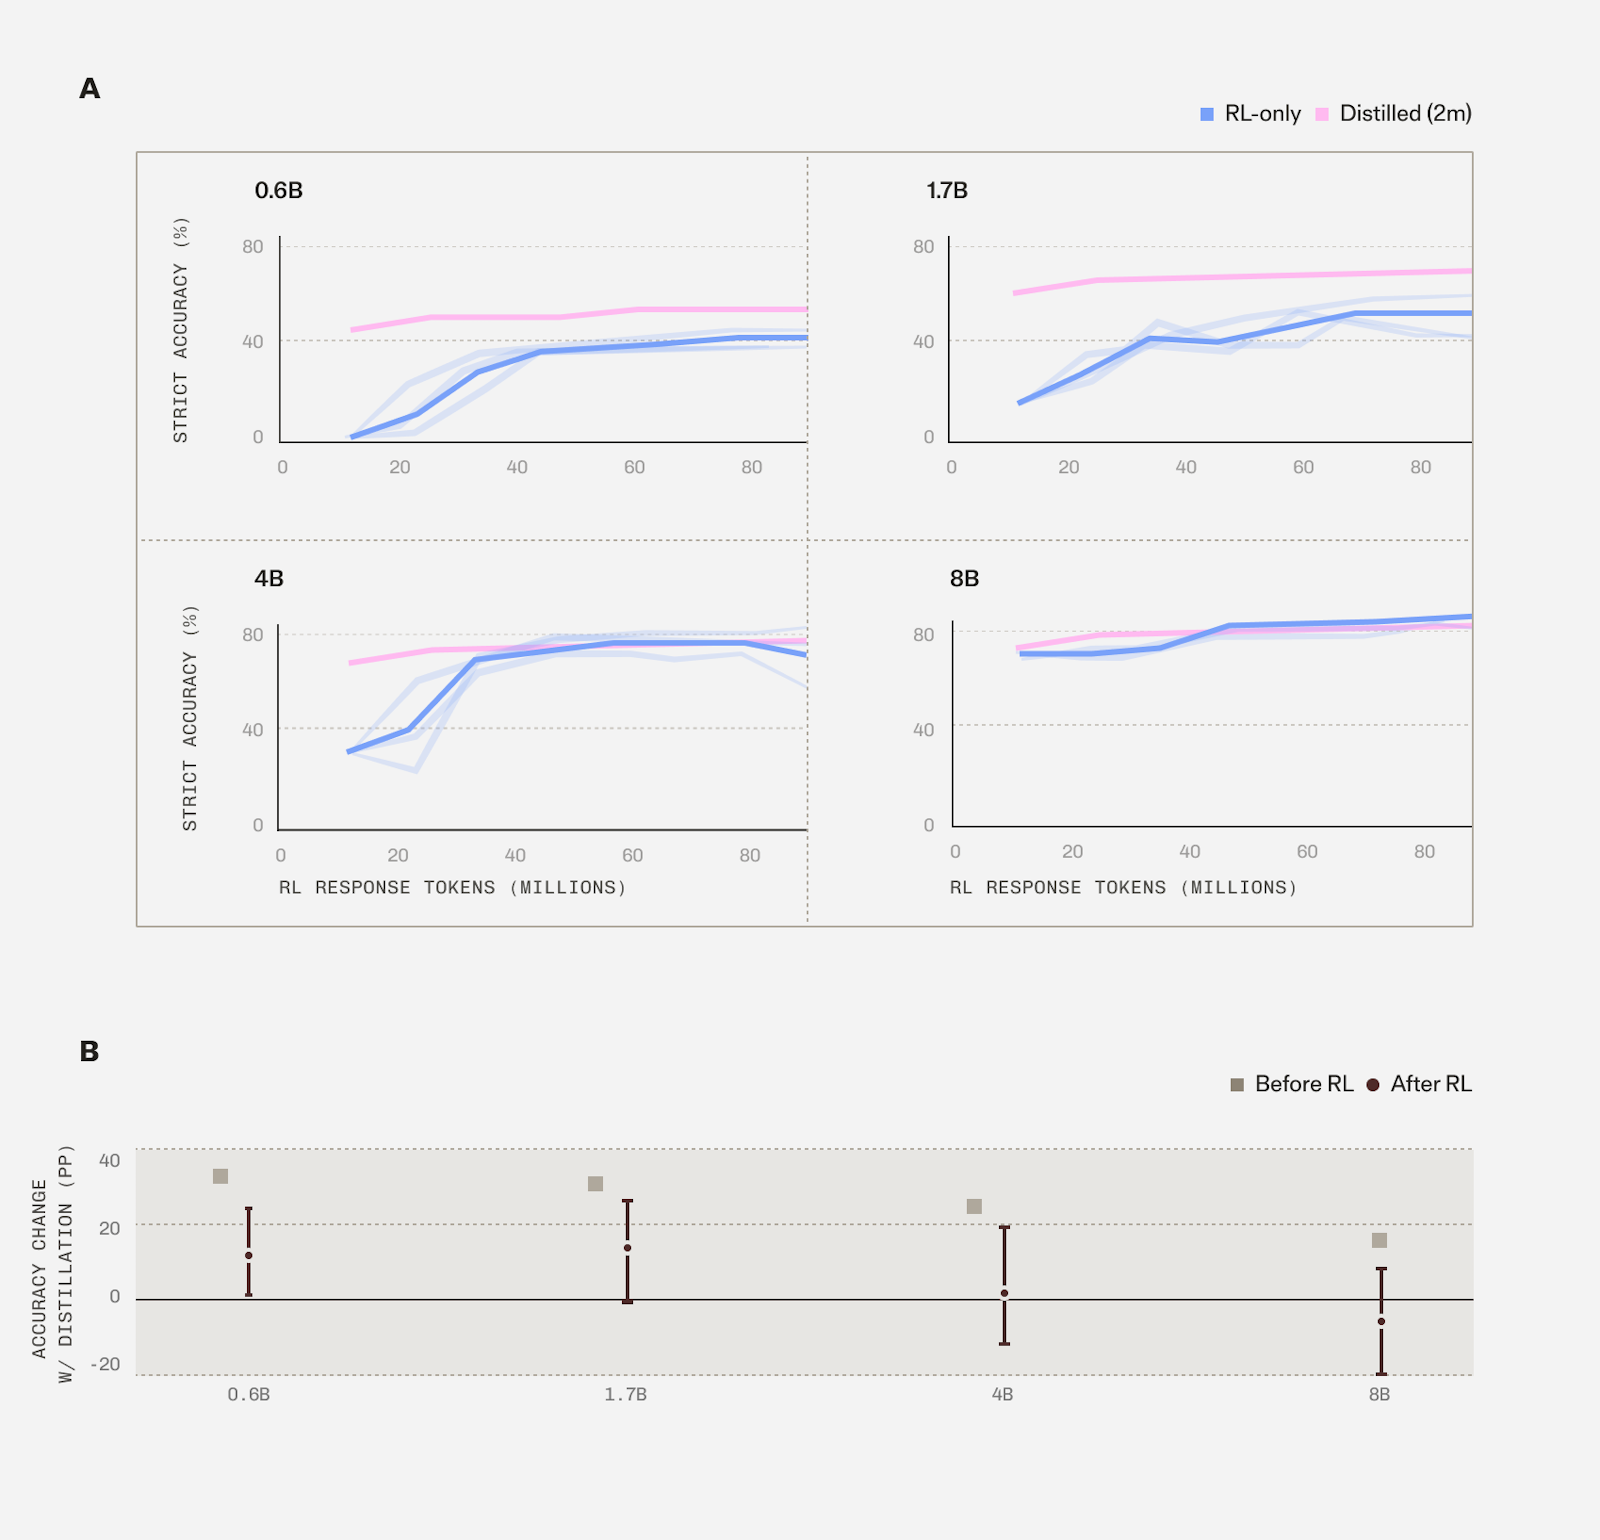
Việc tinh chỉnh trên 2 triệu token đã cải thiện độ chính xác trước khi thực hiện RL ở tất cả các kích thước học viên. Sự cải thiện ban đầu lớn hơn đối với các kích thước mô hình nhỏ hơn, tăng độ chính xác thêm 31,2% ở mức 0,6 tỷ so với 15,3% ở mức 8 tỷ. Sau đó, chúng tôi xem xét liệu những cải thiện này có duy trì sau khi thực hiện RL hay không (Hình 2).
Tại đây, chúng tôi nhận thấy các kết quả trái chiều. Sau khi mỗi mô hình đã tạo ra 80 triệu token phản hồi trong quá trình huấn luyện RL, SFT+RL vượt trội hơn RL 11,3% ở mức 0,6 tỷ, 13,1% ở mức 1,7 tỷ và chỉ 2,1% ở mức 4 tỷ. Khi mở rộng lên 8 tỷ, RL vượt trội hơn SFT+RL 6,4%. Do đó, lợi ích của chưng cất sau RL giảm dần theo kích thước học viên, với sự thay đổi từ 0,6-8 tỷ lên tới mức giảm 17,8% (khoảng tin cậy 95% bootstrap: 6,7-31,0) và mối quan hệ được khớp giữa lợi ích chưng cất và log kích thước học viên là âm trong mỗi lần chạy trong ba lần chạy.
Những kết quả này cho thấy việc cải thiện độ chính xác trước khi thực hiện RL không nhất thiết cải thiện độ chính xác sau quá trình huấn luyện tiếp theo, mặc dù chúng tôi lưu ý rằng kết luận này áp dụng cho ngân sách huấn luyện mà chúng tôi đã đánh giá. Hơn nữa, vì kích thước của mô hình học viên thay đổi cả năng lực mô hình và chính sách bắt đầu được huấn luyện trước, chúng tôi không thể xác định sự khác biệt về năng lực giữa giáo viên và học viên là nguyên nhân của hiện tượng này.
Lợi ích của lượng chưng cất
Cho đến thời điểm này, các so sánh của chúng tôi đã sử dụng chưng cất với 2 triệu token phản hồi của giáo viên. Chúng tôi tiếp tục thay đổi lượng này, từ 0 đến 4 triệu token, để kiểm tra xem chưng cất nhiều hơn có cung cấp điểm khởi đầu tốt hơn cho RL hay không.
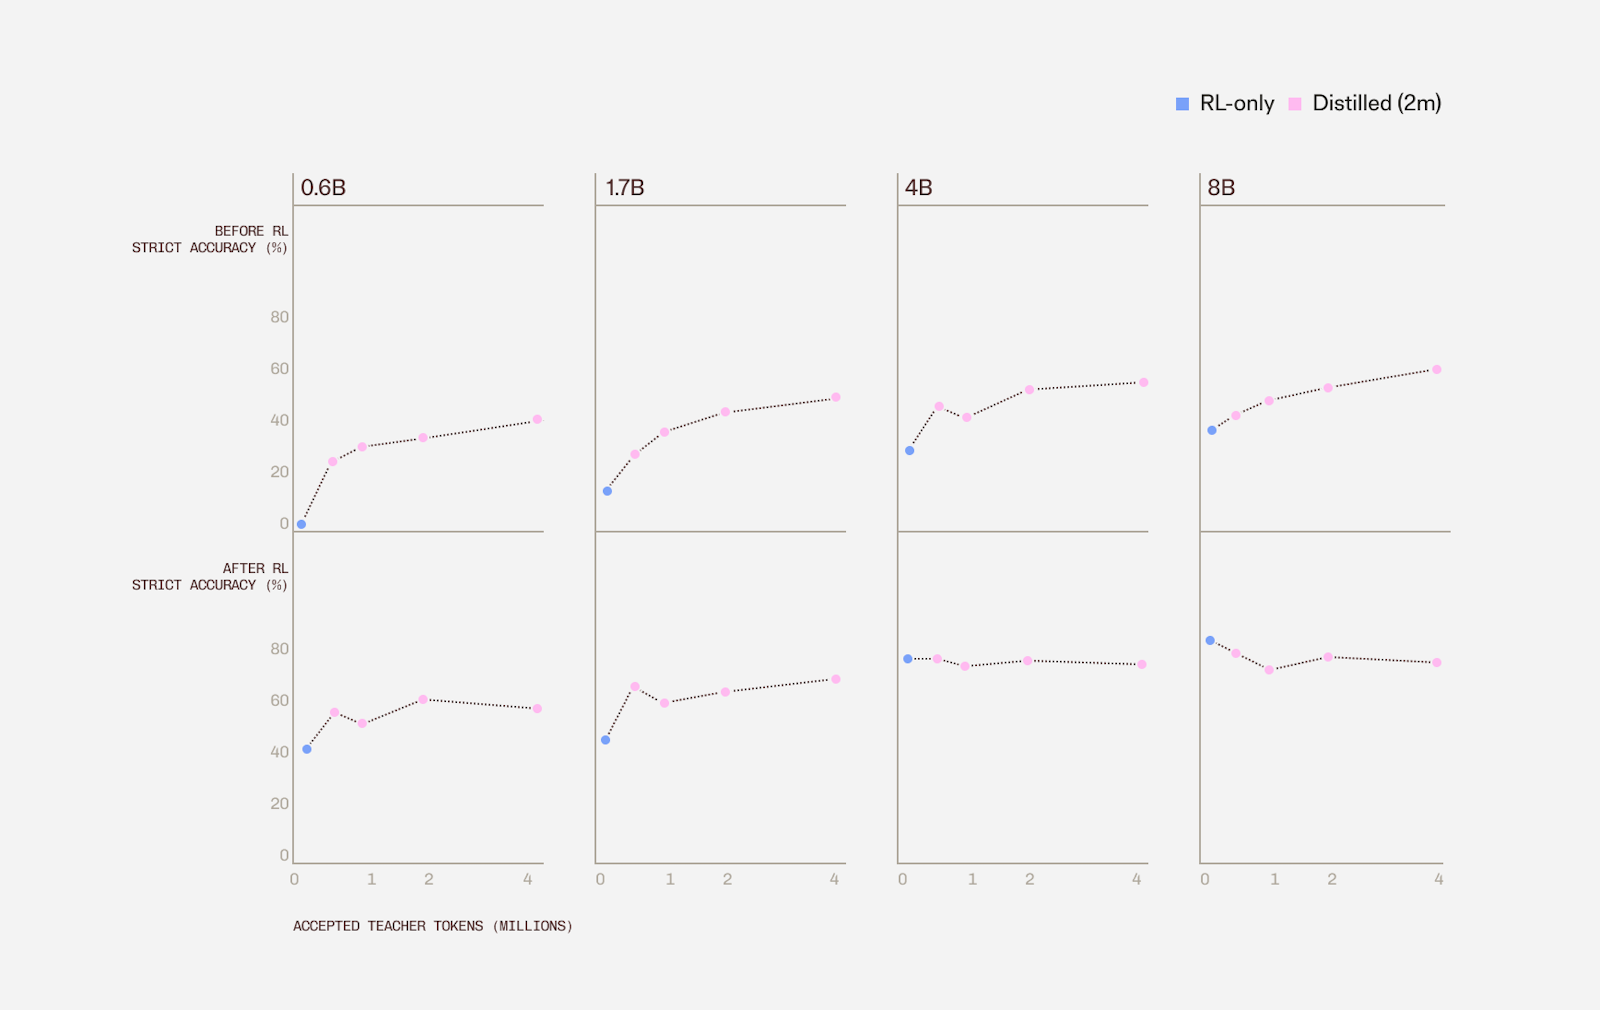
Kết quả của chúng tôi không nhất quán giữa các điều kiện mà chúng tôi đã thử nghiệm. Ví dụ, điểm kết thúc tốt nhất của chúng tôi sử dụng 2 triệu token giáo viên ở mức 0,6 tỷ và 4 triệu ở mức 1,7 tỷ, trái ngược với mức 4 tỷ ghi nhận độ chính xác tốt nhất với 0 và 0,5 triệu token. Củng cố các kết quả trước đó của chúng tôi, ở mức 8 tỷ, mô hình cơ sở (không chưng cất) vượt trội hơn mọi điểm khởi đầu đã chưng cất sau khi thực hiện RL. Do đó, lượng token chưng cất lớn hơn không cải thiện mô hình thu được sau RL tiếp theo. Điều này gợi ý thêm rằng việc chọn lượng chưng cất mục tiêu chỉ bằng cách đo độ chính xác hạ nguồn sau khi SFT đơn thuần là rất khó khăn, nếu không xem xét cả độ chính xác sau RL.
Ảnh hưởng của chưng cất giữa các danh mục tác vụ
Chúng tôi phân tích sâu hơn hiệu suất của các tổ hợp huấn luyện khác nhau trên các tác vụ được kiểm thử. Ví dụ, các mô hình cơ sở (base models) đạt hiệu suất ngang bằng hoặc vượt trội hơn các mô hình chưng cất (distilled models) ở mọi quy mô mô hình học viên (student size) trong các tác vụ tính toán, trong khi ở các tác vụ có cấu trúc, phương pháp chưng cất vẫn giữ được lợi thế đáng kể.
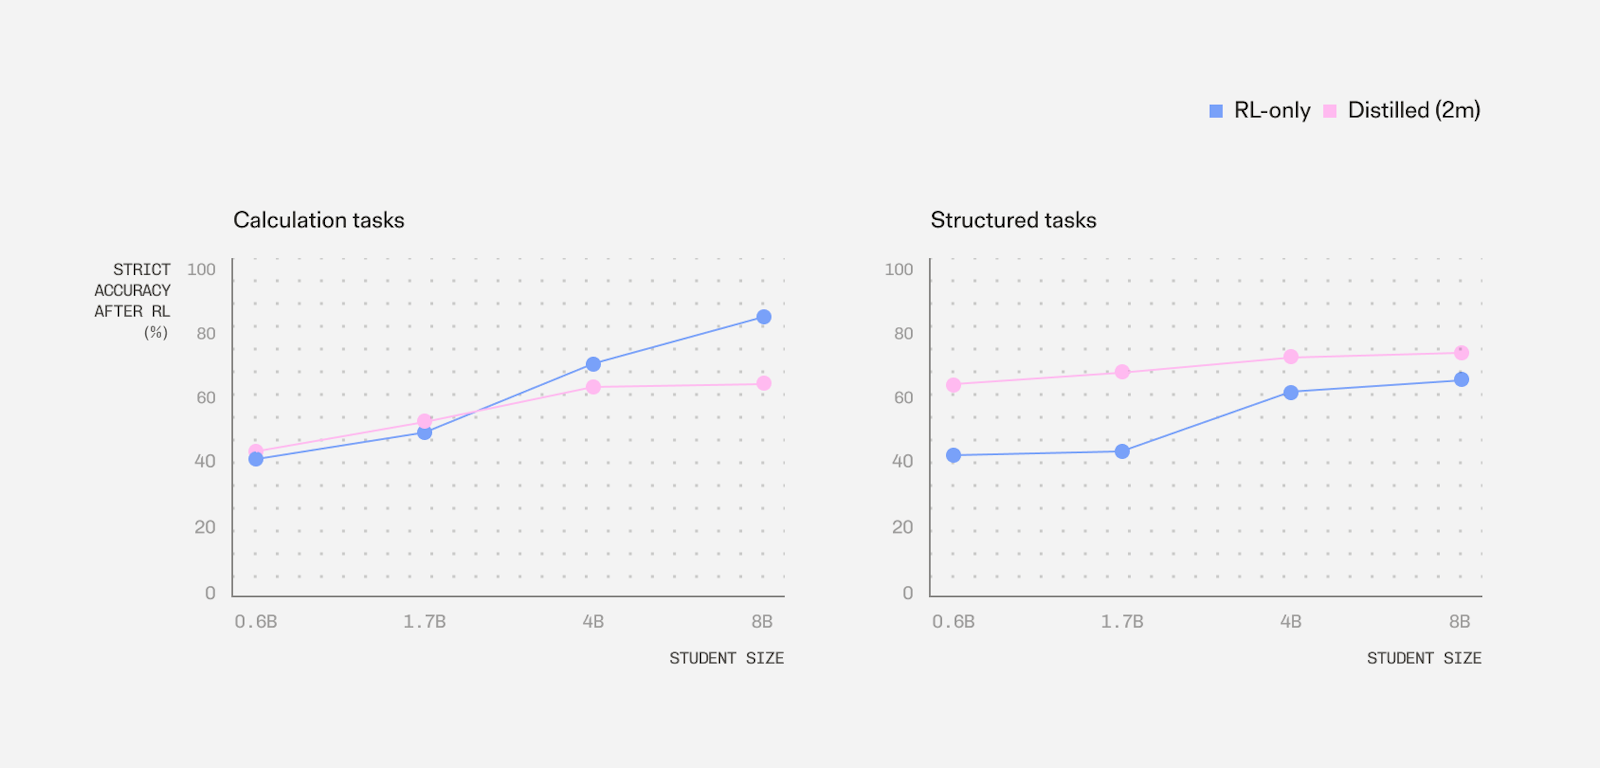
Chúng tôi kiểm soát thêm về tính đúng đắn ngữ nghĩa và xu hướng học 'định dạng đúng' của các mô hình vốn không thể hiện rõ trong các thước đo độ chính xác nghiêm ngặt (xem [Phụ lục G](#Ln)). Tại đây, chúng tôi quan sát thấy rằng ở quy mô 4B và 8B, các mô hình chưng cất thực sự tuân thủ định dạng câu trả lời yêu cầu một cách đáng tin cậy hơn.
Một giả thuyết cho những phát hiện này là trong các tác vụ đòi hỏi quy ước hoặc sự hiểu biết cụ thể, chẳng hạn như cách xoay khối lập phương đúng cách, các minh họa cụ thể về kiến thức này có thể hữu ích. Ngược lại, trong các phép tính trực tiếp hơn, mô hình tiền huấn luyện lớn hơn có thể tự khám phá ra một số quy trình tính toán trực tiếp từ phần thưởng (reward).
Liệu sự khác biệt trong chính sách khởi đầu (starting policy) có thể giải thích cho những kết quả này không?
Tiếp theo, chúng tôi kiểm tra xem liệu sự khác biệt giữa các mô hình khởi đầu có thể giúp giải thích hiệu suất sau đó của chúng hay không. Chúng tôi xem xét hai khả năng. Thứ nhất, các mô hình cơ sở nhỏ hơn ban đầu tạo ra quá ít phản hồi đúng để cung cấp tín hiệu huấn luyện GRPO hữu ích, và thứ hai, SFT đã thay đổi entropy token tiếp theo của mô hình theo cách liên quan đến độ chính xác sau này.
Các mô hình khởi đầu tạo ra phản hồi đúng thường xuyên như thế nào?
Chúng tôi đã kiểm tra các mô hình 1.7B, 4B và 8B trên tất cả năm lượng dữ liệu SFT. Trước khi thực hiện RL, chúng tôi lấy mẫu mười sáu phản hồi cho mỗi 64 câu lệnh (prompt) đối với các mô hình này và đo lường tần suất các mô hình khởi đầu tạo ra câu trả lời đúng.
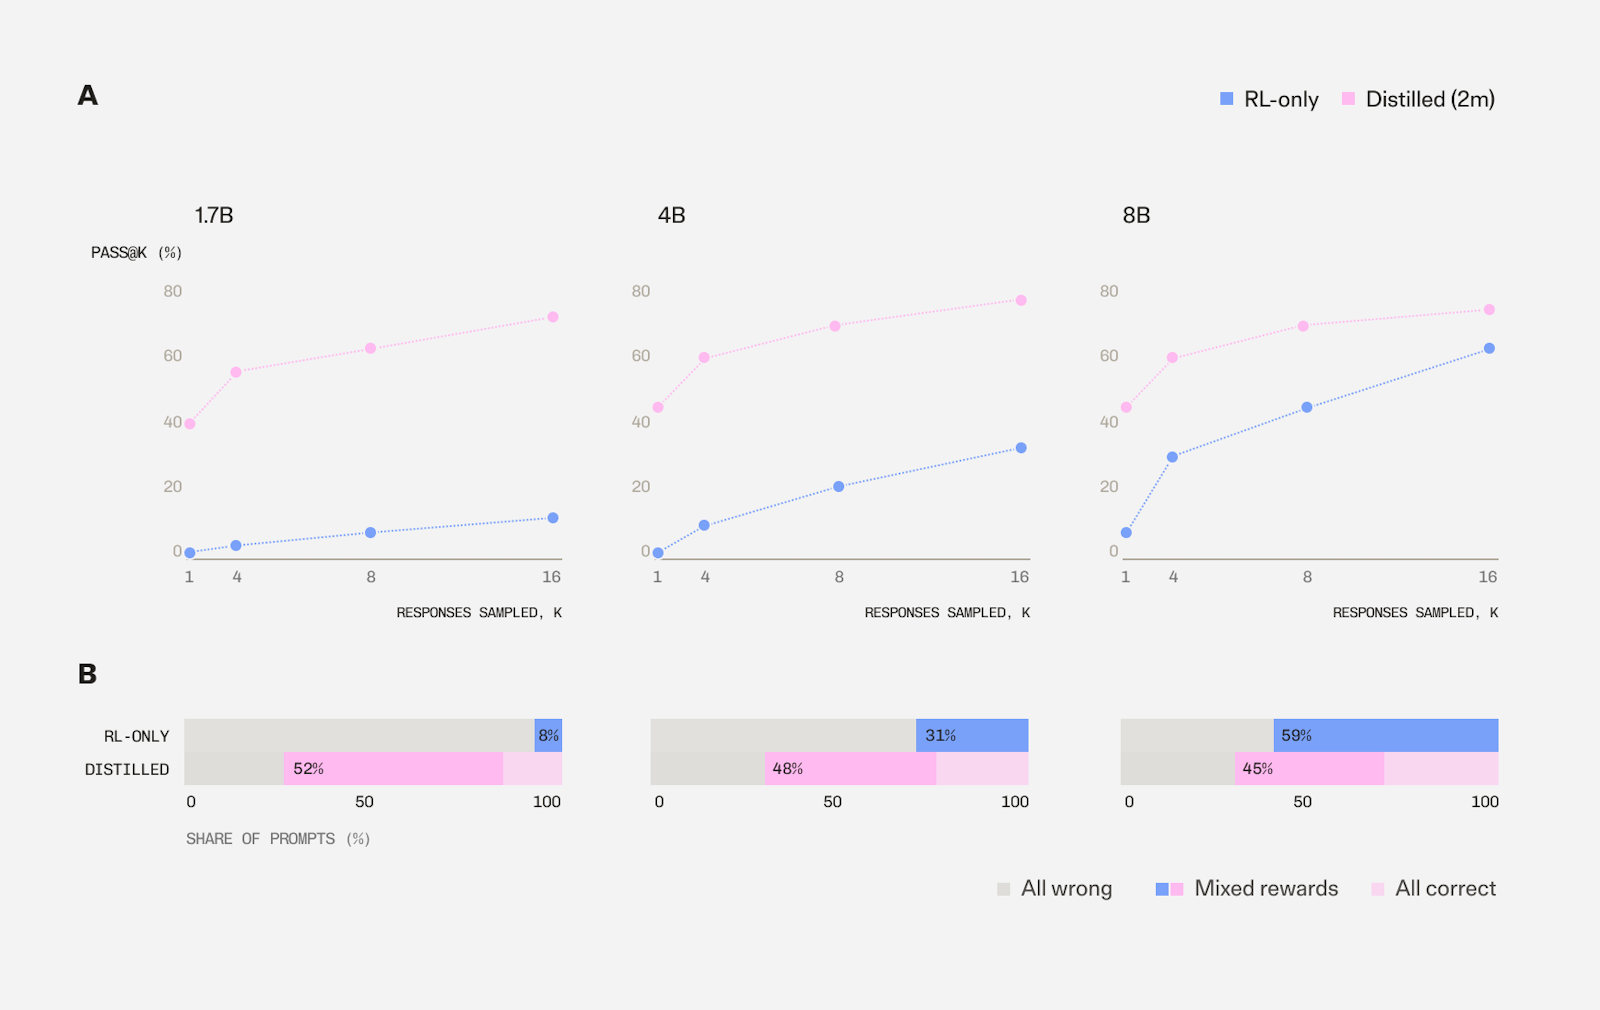
Trước khi SFT, các mô hình cơ sở tạo ra ít nhất một phản hồi đúng trong mười sáu lần thử đối với 7,8% câu lệnh ở mô hình 1.7B, 31,2% ở 4B và 59,4% ở 8B. Sau khi SFT trên 2 triệu token phản hồi từ giáo viên (teacher-response tokens), các tỷ lệ này lần lượt là 70,3%, 73,4% và 68,8%. Do đó, SFT đã tăng tỷ lệ thành công ban đầu mạnh mẽ nhất đối với mô hình 1.7B, phần lớn xóa bỏ sự khác biệt giữa các quy mô mô hình.
Tuy nhiên, một tín hiệu huấn luyện GRPO hữu ích phải chứa các phản hồi với các mức phần thưởng khác nhau. Nghĩa là, các nhóm phải chứa cả phản hồi đúng và sai để cung cấp các lợi thế khác không. Đối với một câu lệnh cố định, gọi p là xác suất một phản hồi được lấy mẫu nhận được phần thưởng là một. Giả sử có mười sáu phản hồi độc lập từ cùng một chính sách,
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Baseten Base Labs: Mô hình Nghiên cứu. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.