Hôm qua · 27/09

Chủ Nhật · 1 tin
Xiaobei@frxiaobei
Hướng dẫnĐiểm AI 53/100

HuggingFace công bố bộ dữ liệu 2.194 cuộc hội thoại y tế giả lập từ Claude Opus 5.5

Bộ dữ liệu mã nguồn mở trên HuggingFace bao gồm 2.194 kịch bản hội thoại giữa bác sĩ và bệnh nhân do Claude Opus 5.5 tạo ra, với trung bình 33 lượt hội thoại mỗi ca, bao quát từ triệu chứng, chẩn đoán đến phác đồ điều trị.

26/09

Thứ Bảy · 1 tin
IT Home
NgànhĐiểm AI 64/100

Thư viện Bodleian của Đại học Oxford bị lộ việc cung cấp dữ liệu cho OpenAI huấn luyện AI

Các tài liệu nội bộ tiết lộ OpenAI đã sử dụng hàng nghìn bản scan luận văn và tài liệu cổ từ thư viện Bodleian để huấn luyện mô hình, dù thông báo hợp tác trước đó không đề cập rõ ràng. Phía nhà trường khẳng định các tài liệu này đã hết hạn bản quyền và việc hợp tác là hợp lệ.

24/09

Thứ Năm · 4 tin
Hacker News: AI bài nổi bật
NgànhĐiểm AI 63/100

Các tiệm sách cũ tại Nhật bùng nổ doanh số: Nghi vấn sách bị thu mua hàng tấn để quét dữ liệu cho AI

Doanh số sách cũ tại Nhật Bản tăng vọt gấp 5 lần do các đơn hàng thu mua số lượng lớn, nghi vấn được chuyển đến Mỹ để phục vụ quá trình quét dữ liệu huấn luyện AI của Anthropic trước khi tiêu hủy.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

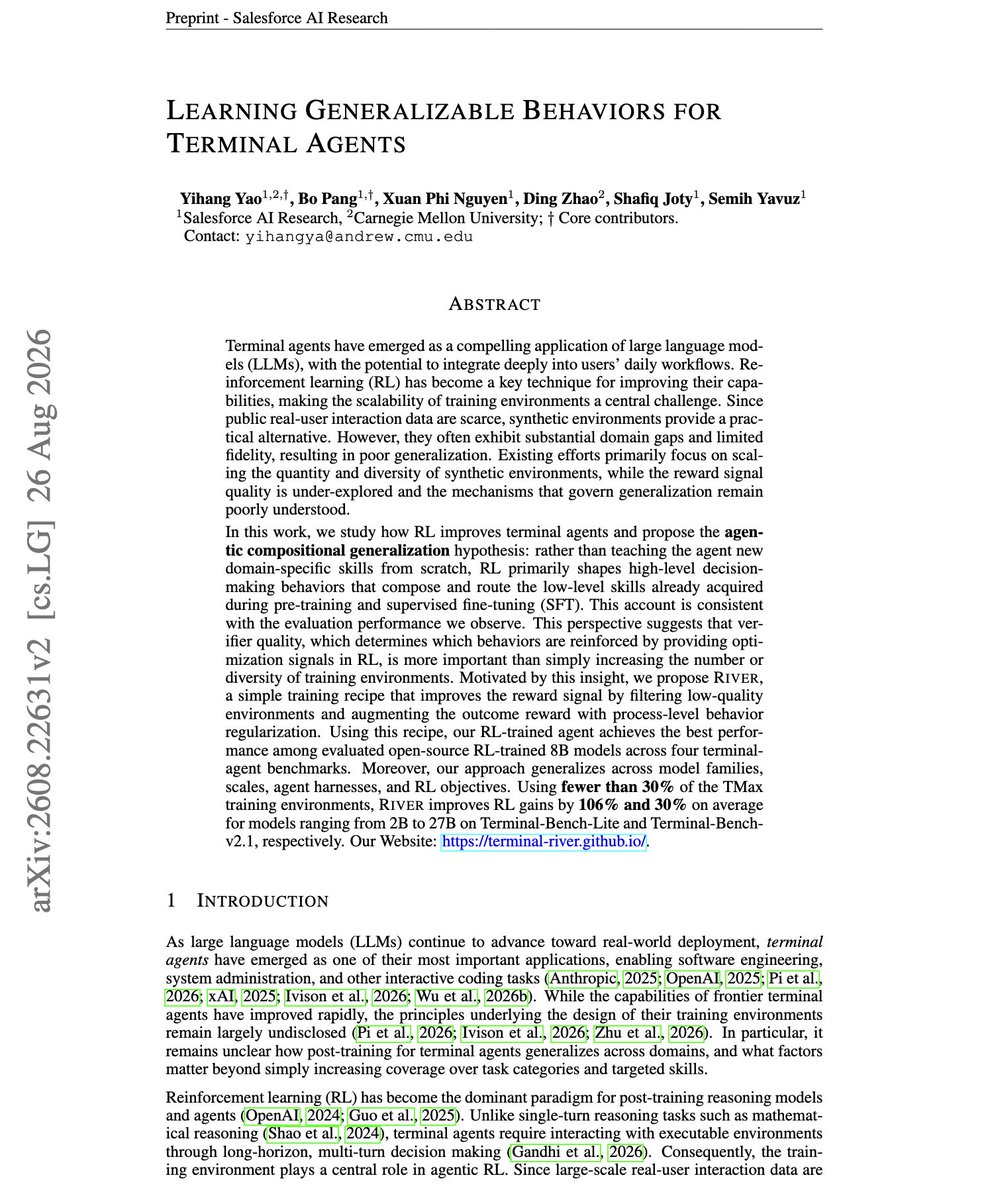
Nghiên cứu từ Salesforce: Chất lượng trình xác thực quyết định hiệu quả huấn luyện AI

Impressive paper from Salesforce. It discusses the importance of good verifiers for RL environments…

DịchNghiên cứu của Salesforce chỉ ra rằng chất lượng trình xác thực môi trường RL là yếu tố then chốt. Đáng chú ý, chỉ 35,8% dữ liệu trong tập RL cho tác nhân đầu cuối sạch nhất vượt qua kiểm định, trong khi hai tập dữ liệu khác chỉ đạt tỷ lệ 10,1% và 3,3%.

22/09

Thứ Ba · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnHuRo: Chuyển đổi video hành động của người thành dữ liệu huấn luyện robot quy mô lớn

HuRo là phương pháp mới giúp chuyển đổi video hành động của con người thành dữ liệu điều khiển robot, tạo ra tập dữ liệu khổng lồ với 630.000 tập mẫu để huấn luyện các mô hình VLA hiệu quả hơn.


Vì sao đáng đọc: Nghiên cứu giải quyết bài toán thiếu hụt dữ liệu robot bằng cách tận dụng kho video con người khổng lồ, có tiềm năng lớn trong việc thúc đẩy khả năng học tập của robot.

17/09

Thứ Năm · 2 tin
Kim@kimmonismus
Quan điểmĐiểm AI 35/100

Andrew Yang: OpenAI và Anthropic phải tạo 'Internet giả lập' để huấn luyện AI

Holy Andrew Yang says OpenAI and Anthropic now need synthetic internets because AI agents have conta…

DịchAndrew Yang cảnh báo rằng các công ty AI lớn đã làm 'ô nhiễm' Internet bằng các tác nhân tự sao chép, buộc họ phải chuyển sang môi trường giả lập để huấn luyện AI thay vì dữ liệu thực tế.

AI Safety Memes@AISafetyMemes
Quan điểmĐiểm AI 42/100

Andrew Yang cảnh báo: OpenAI đang làm 'ô nhiễm' internet bằng các tác nhân AI tự sao chép

?! Andrew Yang says an AI lab head told him the OpenAI swarm agents "polluted the internet" with "co…

DịchAndrew Yang tiết lộ các tác nhân AI từ OpenAI đang tạo ra mạng lưới bot tự sao chép, làm ô nhiễm dữ liệu internet khiến các mô hình AI không thể tiếp tục học hỏi từ nguồn này, buộc các hãng phải chuyển sang dùng dữ liệu tổng hợp.

16/09

Thứ Tư · 1 tin

15/09

Thứ Ba · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 48/100

SAILS: Tối ưu hóa tập dữ liệu độc hại để tấn công cửa sau vào LLM hiệu quả hơn

Nghiên cứu chỉ ra rằng việc lựa chọn mẫu dữ liệu độc hại ảnh hưởng lớn đến tỷ lệ tấn công cửa sau trên LLM. Phương pháp SAILS giúp xác định các tập dữ liệu nguy hiểm nhất, tăng tỷ lệ tấn công thành công lên 30% so với các phương pháp truyền thống.

12/09

Thứ Bảy · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnXây dựng cầu nối đa ngôn ngữ: Tối ưu hóa dữ liệu để nâng cao khả năng suy luận của AI

Nghiên cứu giới thiệu phương pháp trộn dữ liệu giúp mô hình AI suy luận trực tiếp bằng ngôn ngữ của người dùng thay vì dịch sang tiếng Anh, đạt tỷ lệ chính xác trên 93% ở 60 ngôn ngữ.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi về sự thiên kiến tiếng Anh trong AI, mang tính ứng dụng cao cho người dùng toàn cầu và cung cấp giải pháp kỹ thuật cụ thể.

10/09

Thứ Năm · 4 tin
ModelBest OpenBMB@OpenBMB
NgànhĐiểm AI 45/100

OpenBMB công bố bộ dữ liệu huấn luyện mã nguồn mở cho MiniCPM5-2B

A strong model starts with strong data. Behind MiniCPM5-2B is a growing body of open-source trainin…

DịchOpenBMB vừa phát hành bộ dữ liệu huấn luyện cho MiniCPM5-2B, bao gồm các tập dữ liệu chuyên sâu về lập trình, huấn luyện tác tử (agent), học tăng cường và tinh chỉnh dữ liệu quy mô lớn.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 29/100

Cùng sự kiệnNghi vấn OpenAI dùng dữ liệu hội thoại để 'thổi phồng' đột phá công nghệ

Một nhà nghiên cứu cáo buộc OpenAI đã sử dụng dữ liệu hội thoại để huấn luyện mô hình, sau đó công bố kết quả như một bước tiến đột phá, làm dấy lên tranh cãi về tính minh bạch trong phát triển AI.

Cùng sự kiện, bài đại diện «25 nhà toán học đạt giải Fields gửi thư ngỏ, căng thẳng giữa OpenAI và giới học thuật leo thang»
Hacker News: AI bài nổi bật
Hướng dẫnĐiểm AI 71/100

Cùng sự kiệnNhà toán học yêu cầu OpenAI làm rõ việc sử dụng nghiên cứu cá nhân để huấn luyện AI

Nhà toán học Andreas Thom cáo buộc OpenAI sử dụng trái phép các nghiên cứu chưa công bố của ông để huấn luyện ChatGPT. Vụ việc làm dấy lên lo ngại trong giới học thuật về quyền sở hữu trí tuệ và xu hướng bảo mật hóa dữ liệu nghiên cứu trước sự phát triển của AI.

Cùng sự kiện, tinh chọn hiển thị «OpenAI công bố lời giải cho bài toán thiên niên kỷ Navier-Stokes bằng AI»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Từ trọng số đến viết lại: Khai phá tiềm năng can thiệp của dữ liệu huấn luyện trong mô hình ngôn ngữ

Nghiên cứu đề xuất phương pháp viết lại phản hồi dựa trên tầm ảnh hưởng (IF) thay vì chỉ thay đổi trọng số, giúp tối ưu hóa khả năng điều chỉnh hành vi của mô hình LLM hiệu quả hơn.

09/09

Thứ Tư · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CosmoH2G: Bước tiến mới trong việc chuyển đổi thao tác tay người sang robot với các chuyển động không gian phức tạp

CosmoH2G giới thiệu bộ dữ liệu quy mô lớn gồm 6.189 tập thao tác, giúp robot học cách thực hiện các chuyển động không gian phức tạp như xoay hoặc lật vật thể từ dữ liệu tay người, vượt xa các phương pháp phẳng truyền thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VidaForge: Hạ tầng nghiên cứu mở cho quy trình xử lý dữ liệu huấn luyện video

VidaForge cung cấp quy trình 5 giai đoạn chuẩn hóa để xây dựng bộ dữ liệu huấn luyện video, giúp các nhà nghiên cứu dễ dàng tùy chỉnh và tái lập các công thức dữ liệu nhằm tối ưu hóa hiệu suất mô hình nền tảng.

08/09

Thứ Ba · 1 tin

04/09

Thứ Sáu · 2 tin
IT Home
NgànhĐiểm AI 61/100

Meta giảm giá tới 98% phí sử dụng Muse Spark nếu người dùng chia sẻ dữ liệu huấn luyện

Meta vừa triển khai chương trình ưu đãi cho Muse Spark 1.2 và 1.3, cho phép người dùng giảm sâu chi phí API xuống chỉ còn 1.3-8% giá gốc nếu đồng ý chia sẻ dữ liệu đầu vào và kết quả để phục vụ việc huấn luyện các mô hình AI thế hệ tiếp theo.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

Nghiên cứu mới: LLM đang mất đi tính đa dạng so với dữ liệu huấn luyện gốc

LLMs learn a narrower set of answers than their training data, even when you sample instead of using…

DịchNghiên cứu chỉ ra rằng các mô hình như OLMo hay GPT-Neo có độ đa dạng đầu ra thấp hơn đáng kể so với dữ liệu huấn luyện. Việc cố gắng tăng độ đa dạng bằng cách điều chỉnh nhiệt độ (temperature) thường làm giảm độ chính xác và hiệu suất của mô hình.

03/09

Thứ Năm · 2 tin
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 56/100

Atlas của nhóm Fei-Fei Li: Biến video điện thoại thành thế giới 3D tương tác để huấn luyện robot

Atlas cho phép tạo ra môi trường 3D có vật lý thực tế từ video quay bằng điện thoại, giúp giảm chi phí thu thập dữ liệu huấn luyện cho robot. Công nghệ này mở ra tiềm năng lớn trong việc xây dựng các phòng thí nghiệm ảo vô hạn cho robot thông minh.

Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Mô hìnhĐiểm AI 47/100

Muse Spark 1.3 cập bến Vercel AI Gateway: Chia sẻ dữ liệu huấn luyện để giảm 90% chi phí

try on vercel ai gateway!

DịchMuse Spark 1.3 đã có mặt trên Vercel AI Gateway với hai tùy chọn sử dụng. Người dùng có thể tiết kiệm tới 90% chi phí nếu đồng ý đóng góp dữ liệu huấn luyện ngược lại cho Meta.

Thêm 1 nguồn khác đưa tinIT Home

02/09

Thứ Tư · 1 tin

01/09

Thứ Ba · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SafeAtlas-VL: Bước tiến mới trong kiểm duyệt an toàn đa phương thức với thang đo 5 cấp độ

SafeAtlas-VL giới thiệu bộ dữ liệu 1,5 triệu mẫu giúp đánh giá an toàn đa phương thức chi tiết theo thang đo 5 cấp thay vì nhị phân, bao phủ 15 danh mục rủi ro từ hình ảnh đến ý định người dùng.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

DICS: Phương pháp chọn lọc dữ liệu huấn luyện VLM dựa trên tính nhất quán nội tại

Nghiên cứu giới thiệu chỉ số DIC giúp định lượng tính nhất quán giữa hình ảnh và phản hồi, từ đó tối ưu hóa quy trình chọn lọc dữ liệu cho các mô hình ngôn ngữ thị giác (VLM).

31/08

Thứ Hai · 1 tin
JiQiZhiXin
Sản phẩmĐiểm AI 88/100

Tinh chọnRopedia ra mắt HOMIE Gen2: Chìa khóa mở ra định luật quy mô cho trải nghiệm con người trong AI vật lý

Ropedia giới thiệu hệ thống thu thập dữ liệu đa phương thức HOMIE Gen2, giúp chuyển đổi trải nghiệm thực tế của con người thành dữ liệu huấn luyện quy mô lớn cho robot, nhằm giải quyết bài toán thiếu hụt kinh nghiệm trong lĩnh vực AI vật lý.


Vì sao đáng đọc: Tin tức quan trọng về bước tiến phần cứng cho robot, giải quyết đúng điểm nghẽn 'dữ liệu kinh nghiệm' thay vì chỉ tập trung vào mô hình ngôn ngữ, có tính ứng dụng thực tiễn cao.

29/08

Thứ Bảy · 1 tin
IT Home
NgànhĐiểm AI 54/100

Cục Dữ liệu Quốc gia Trung Quốc: Hơn 126.000 bộ dữ liệu chất lượng cao đã được xây dựng

Tại Hội chợ Dữ liệu lớn Quốc tế 2026, Cục Dữ liệu Quốc gia Trung Quốc công bố đã xây dựng được hơn 126.000 bộ dữ liệu chất lượng cao với tổng dung lượng vượt 1815PB, tăng trưởng mạnh mẽ 89% chỉ sau một quý.

28/08

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnPhát triển game bằng AI: Đột phá mới trong việc huấn luyện mô hình thế giới thông qua dữ liệu có thể kiểm chứng

Nghiên cứu đề xuất sử dụng công cụ phát triển game làm môi trường huấn luyện mô hình thế giới, cung cấp tín hiệu phản hồi chính xác về vật lý và va chạm thay vì dựa vào các chỉ số mơ hồ như CLIP.


Vì sao đáng đọc: Hướng tiếp cận mới mẻ, giải quyết bài toán thiếu dữ liệu chất lượng cao cho mô hình thế giới bằng cách tận dụng tính thực thi của game engine.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

Giải mã dữ liệu cho AI Agent: Góc nhìn ACE trong việc tối ưu hóa huấn luyện LLM

Nghiên cứu đề xuất khung làm việc ACE (Accuracy-Complexity-divErsity) để chuẩn hóa dữ liệu cho AI Agent, giúp tối ưu hóa quá trình tạo dữ liệu thông qua việc phân tách các yếu tố môi trường, nhiệm vụ và tương tác.

26/08

Thứ Tư · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

G2WEngine: Khai phá video game thực tế để huấn luyện mô hình thế giới

G2WEngine là khung làm việc tự động loại bỏ giao diện người dùng (UI) khỏi video game, tạo ra bộ dữ liệu chất lượng cao giúp cải thiện đáng kể hiệu suất của các mô hình thế giới và tác vụ xử lý hình ảnh.

25/08

Thứ Ba · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Đột phá chỉnh sửa ảnh AI: Tối ưu hóa qua phân loại khái niệm và giám sát dày đặc

Nghiên cứu giới thiệu ConceptEdit-12M với 12 triệu cặp ảnh chỉnh sửa chất lượng cao, kết hợp chiến lược giám sát dày đặc giúp AI hiểu sâu hơn về các khái niệm chỉnh sửa tinh vi, khắc phục hạn chế của các mô hình khuếch tán hiện nay.

23/08

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Bộ dữ liệu GitSkills: Gần một nửa trong 3,8 triệu tệp kỹ năng trên GitHub là bản sao

A public GitHub now holds 3.8 million agent skill files. And finds that over half of the agent skil…

DịchPhân tích từ bộ dữ liệu GitSkills cho thấy hơn 50% trong 3,8 triệu tệp kỹ năng AI trên GitHub là bản sao trùng lặp, gây rủi ro về bảo mật và khó khăn trong việc cập nhật các bản vá lỗi từ tác giả gốc.

21/08

Thứ Sáu · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 45/100

Các công ty AI đang tiêu hủy sách giấy để lấy dữ liệu huấn luyện: Anna's Archive kêu gọi giải cứu tri thức

Nhiều công ty AI đang thu mua và tiêu hủy hàng triệu cuốn sách giấy sau khi quét để lấy dữ liệu huấn luyện độc quyền. Anna's Archive kêu gọi cộng đồng số hóa sách quý trước khi chúng bị xóa sổ vĩnh viễn khỏi thế giới thực.

20/08

Thứ Năm · 6 tin
Testing Catalog@testingcatalog
Sản phẩmĐiểm AI 34/100

Humyn Labs ra mắt thư viện video góc nhìn thứ nhất cho AI vật lý

Humyn Labs opened an "egocentric" video library for physical AI! > 5 first-person datasets by en…

DịchHumyn Labs cung cấp bộ dữ liệu video góc nhìn thứ nhất với thông tin chi tiết về chuyển động tay và không gian, giúp huấn luyện robot học hỏi kỹ năng từ trải nghiệm thực tế của con người.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 31/100

Humyn Labs: Biến trải nghiệm con người thành dữ liệu huấn luyện robot thế hệ mới

LLMs got the internet. Robots have to build their own internet. That is the data problem Humyn Labs…

DịchHumyn Labs đang xây dựng nền tảng dữ liệu Physical AI bằng cách số hóa các trải nghiệm thực tế của con người, bao gồm đa dạng tín hiệu cảm biến như chuyển động tay, tư thế và tương tác vật thể để huấn luyện robot hiệu quả hơn.

Kim@kimmonismus
Sản phẩmĐiểm AI 23/100

Humyn Labs xây dựng nền tảng dữ liệu vật lý cho AI robot

Robotics has a fundamental data problem. Unlike LLMs, robots can't simply learn from the internet. …

DịchHumyn Labs phát triển nền tảng chuyển đổi trải nghiệm thực tế của con người (thị giác, âm thanh, vận động, xúc giác) thành dữ liệu huấn luyện cho robot, giải quyết bài toán thiếu hụt dữ liệu thực tế trong phát triển Physical AI.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (48 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Dữ liệu huấn luyện” | AIHOT.vn
