24/09

Thứ Năm · 3 tin
Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 46/100

Ra mắt CLM-8B: Mô hình System One với tốc độ suy luận nhanh gấp 9 lần Jev

Pay attention to this new wave of System One models if you are building custom harnesses. First Je…

DịchCLM-8B là mô hình System One sử dụng mục tiêu học tương phản, mang lại hiệu suất vượt trội trong các tác vụ điều khiển máy tính, chơi game và gọi công cụ với tốc độ nhanh gấp 9 lần so với Jev.

Thêm 1 nguồn khác đưa tinMarkTechPost
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

Six Layers Less: Kỹ thuật cắt tỉa Encoder cho Whisper giúp tối ưu hiệu năng mà không cần nhãn

Nghiên cứu giới thiệu phương pháp loại bỏ 6 lớp ít quan trọng nhất trong bộ mã hóa Whisper, giúp giảm 18,5% kích thước mô hình mà không cần thay đổi cấu trúc suy luận. Hiệu suất được khôi phục ấn tượng thông qua kỹ thuật chưng cất từ dữ liệu âm thanh không nhãn.

23/09

Thứ Tư · 3 tin
Perplexity@perplexity_ai
Nghiên cứuĐiểm AI 32/100

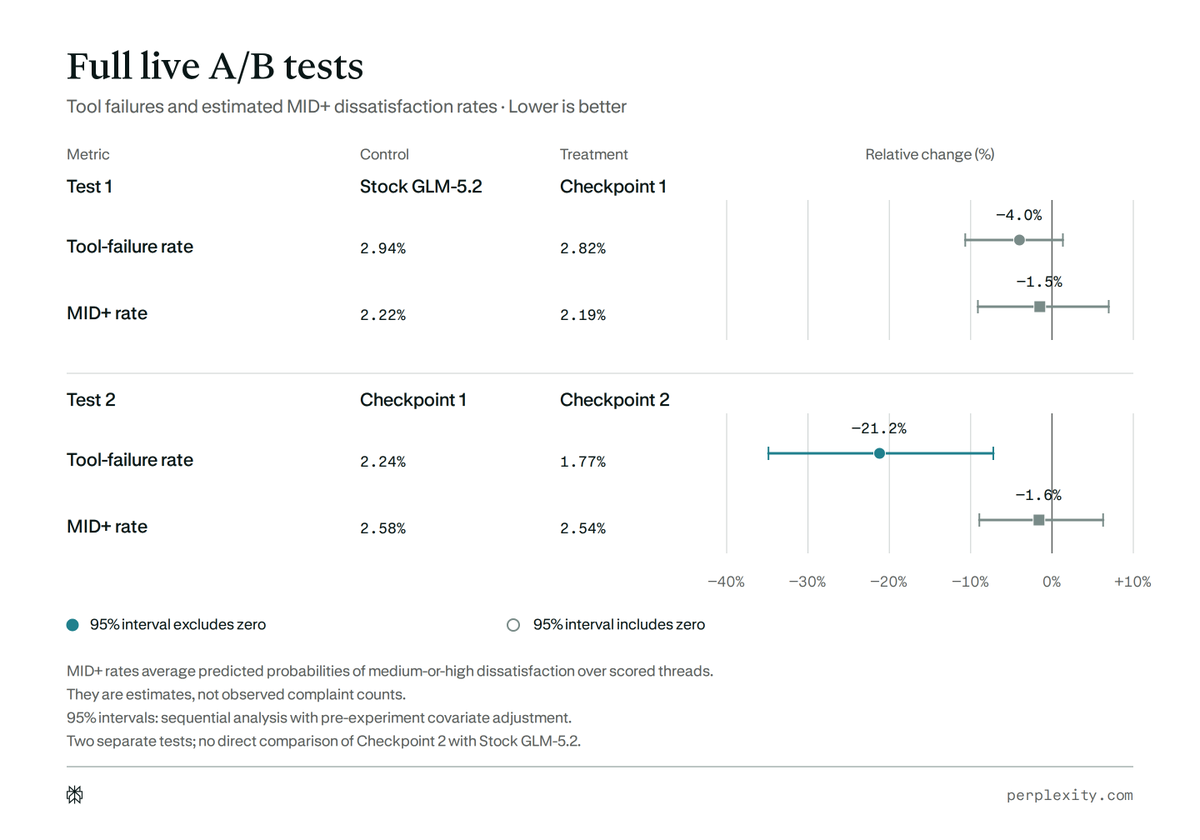
Perplexity ứng dụng kỹ thuật tự chưng cất để giảm tỷ lệ lỗi gọi công cụ

New research: We post-trained a Computer model to learn from its own errors using hint-guided self-d…

DịchPerplexity giới thiệu phương pháp tự chưng cất (self-distillation) giúp mô hình máy tính tự học từ sai lầm, qua đó giảm 21,2% tỷ lệ lỗi khi thực hiện các lệnh gọi công cụ trong thực tế.

Elvis Saravia@omarsar0
Quan điểmĐiểm AI 40/100

Xây dựng hạ tầng AI nội bộ: Mô hình tùy chỉnh và hệ thống đánh giá là tài sản cốt lõi

Own your intelligence stack, folks. You can't scale a company to the frontier by renting intelligen…

DịchElvis Saravia nhấn mạnh doanh nghiệp cần tự chủ công nghệ thay vì chỉ thuê ngoài. Bằng cách tối ưu hóa quy trình hậu đào tạo và hệ thống đánh giá, startup Harvey đã chuyển từ lỗ sang lãi chỉ trong một quý dù quy mô sử dụng tăng gấp đôi.

22/09

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTAPe+ML: Kiến trúc thị giác máy tính siêu gọn nhẹ cho đa tác vụ

TAPe+ML v3 là hệ thống thị giác máy tính đột phá với chưa đầy 100.000 tham số, sử dụng lý thuyết nhận thức chủ động để xử lý hiệu quả các tác vụ phân loại, phát hiện vật thể và phân đoạn ảnh với độ chính xác ấn tượng.


Vì sao đáng đọc: Đột phá về hiệu suất khi đạt kết quả cao với số lượng tham số cực nhỏ, mở ra tiềm năng ứng dụng AI trên các thiết bị biên hạn chế tài nguyên.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Harness-Zero: Kỹ thuật chưng cất khung làm việc cho AI Agent

Harness-Zero giới thiệu phương pháp 'agent-as-harness' giúp chuyển giao hành vi tối ưu từ các khung làm việc phức tạp trực tiếp vào trọng số mô hình, giúp AI duy trì hiệu suất cao ngay cả khi không còn phụ thuộc vào khung hỗ trợ.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 48/100

Chạy mô hình AI tiên tiến trên phần cứng cá nhân: Tuần lễ mã nguồn mở từ một phòng thí nghiệm học thuật

Một phòng thí nghiệm học thuật khởi xướng 'Tuần lễ mã nguồn mở', chứng minh khả năng chạy mô hình Qwen 3.6 35B-A3B trên Mac với tốc độ ấn tượng 450 tokens/giây nhờ kỹ thuật lượng tử hóa 1.5-bit.

21/09

Thứ Hai · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

IntBMoE: Tối ưu hóa kiến trúc Mixture-of-Experts thông qua cơ chế điều phối khối

IntBMoE giải quyết bài toán đánh đổi giữa hiệu năng, chi phí tính toán và bộ nhớ trong mô hình MoE bằng cách kết hợp kỹ thuật trộn chuyên gia dày đặc với cơ chế thực thi khối thưa thớt, cho phép kiểm soát độc lập các thông số này.

18/09

Thứ Sáu · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

ActObs: Tối ưu hóa hành vi khám phá của tác nhân AI thông qua giám sát quan sát trong RL

Nghiên cứu giới thiệu ActObs, phương pháp giám sát các token quan sát trong giai đoạn SFT mà không làm tăng dữ liệu hay chi phí tính toán, giúp cải thiện khả năng khám phá của tác nhân trong học tăng cường.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

Vision-RL2: Tối ưu hóa chiến lược cấp vùng cho mô hình ngôn ngữ đa phương thức (MLLM)

Vision-RL2 sử dụng học tăng cường cấp vùng để tối ưu hóa mạng đề xuất khu vực trong MLLM mà không cần nhãn dữ liệu, giúp cải thiện độ chính xác vượt trội với số lượng token thị giác ít hơn gấp 4 lần.

16/09

Thứ Tư · 2 tin
JiQiZhiXin
Mô hìnhĐiểm AI 85/100

Làm sao để tối ưu AI cục bộ? Trò chuyện cùng CTO của StartLux

Trong bối cảnh giới toán học lo ngại về việc AI 'đánh cắp' ý tưởng trên đám mây, StartLux gây chú ý khi đạt hiệu suất vượt trội với mô hình 27B. Chúng tôi thảo luận về cách họ tối ưu hóa hậu huấn luyện để đạt kết quả ấn tượng dù quy mô tham số nhỏ.

12/09

Thứ Bảy · 1 tin
AI Notes@AYi_AInotes
NgànhĐiểm AI 50/100

Cùng sự kiệnKiến trúc DeepSeek V4.1 Flash: Đột phá kỹ thuật không thể sao chép bằng chưng cất

Chuyên gia đánh giá cao kiến trúc CED 20-20 lớp của DeepSeek V4.1 Flash, cho phép tối ưu hóa hiệu suất vượt trội với lượng tham số kích hoạt cực thấp và giảm dung lượng bộ nhớ KV xuống chỉ còn 1/4 so với thế hệ trước.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»

10/09

Thứ Năm · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Từ trọng số đến viết lại: Khai phá tiềm năng can thiệp của dữ liệu huấn luyện trong mô hình ngôn ngữ

Nghiên cứu đề xuất phương pháp viết lại phản hồi dựa trên tầm ảnh hưởng (IF) thay vì chỉ thay đổi trọng số, giúp tối ưu hóa khả năng điều chỉnh hành vi của mô hình LLM hiệu quả hơn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Đồng tiến hóa Harness và Mô hình: Khi hiệu chỉnh On-Policy giúp mô hình nhỏ bắt kịp hiệu suất

Nghiên cứu chỉ ra rằng việc tối ưu hóa hệ thống hỗ trợ (harness) giúp mô hình nhỏ đạt hiệu suất cao, nhưng việc huấn luyện bắt chước từ chuyên gia lại gây phản tác dụng, đòi hỏi phương pháp hiệu chỉnh on-policy thay thế.

09/09

Thứ Tư · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 36/100

CoVeR: Phương pháp cắt tỉa token dựa trên độ phủ cho suy luận 3D đa góc nhìn trên VLM

CoVeR là bộ chọn token thị giác không cần huấn luyện, giúp tối ưu hóa suy luận 3D đa góc nhìn bằng cách loại bỏ token dư thừa. Chỉ với 8% lượng token, mô hình vẫn duy trì 93,5% hiệu suất, vượt qua các phương pháp hiện có tới 3,9 điểm phần trăm.

07/09

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Khi lượng tử hóa làm hỏng bộ nhớ: Vấn đề ghi đè trạng thái hồi quy trong suy luận độ chính xác thấp

Nghiên cứu chỉ ra rằng việc lượng tử hóa trạng thái trong mạng hồi quy (RNN) có thể gây sai số nghiêm trọng khi dự đoán các thông số sinh học. Việc lưu trữ trạng thái 4-bit làm tăng sai số dự báo lên gấp hàng trăm lần so với mô hình gốc.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 64/100

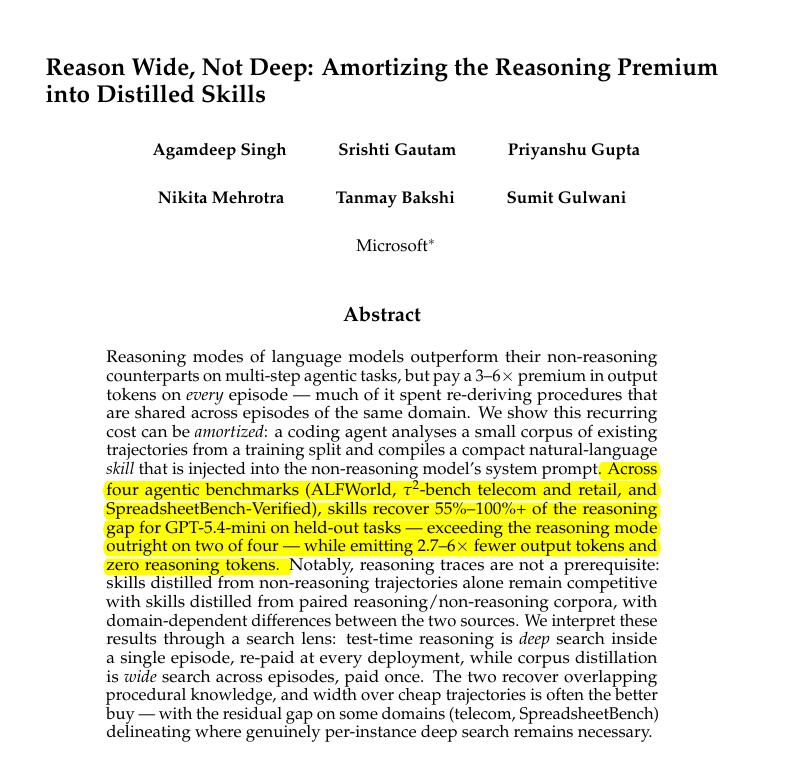
Microsoft đề xuất phương pháp chưng cất kỹ năng suy luận: Giúp mô hình nhỏ đạt hiệu suất vượt trội

What if you could pay the reasoning cost once, then reuse what the model learned across future tasks…

DịchNghiên cứu mới từ Microsoft cho phép chuyển đổi chi phí suy luận đắt đỏ thành các 'kỹ năng' dạng Markdown. Bằng cách tổng hợp các mẫu lỗi từ lịch sử, mô hình nhỏ có thể khôi phục 55-100% khả năng suy luận mà không cần tốn thêm token.

04/09

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnLatentPress: Đột phá nén ngữ cảnh trực tiếp vào không gian tiềm ẩn của AI

LatentPress giới thiệu phương pháp nén tài liệu và lịch sử hội thoại thành các token bộ nhớ liên tục, cho phép mô hình AI đọc trực tiếp mà không cần giải mã văn bản, giúp tăng hiệu suất xử lý dữ liệu dài gấp 4-16 lần.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng về tối ưu hóa bộ nhớ cho LLM, giải quyết bài toán nén ngữ cảnh hiệu quả hơn hẳn các phương pháp truyền thống như tóm tắt văn bản hay OCR.

31/08

Thứ Hai · 1 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 44/100

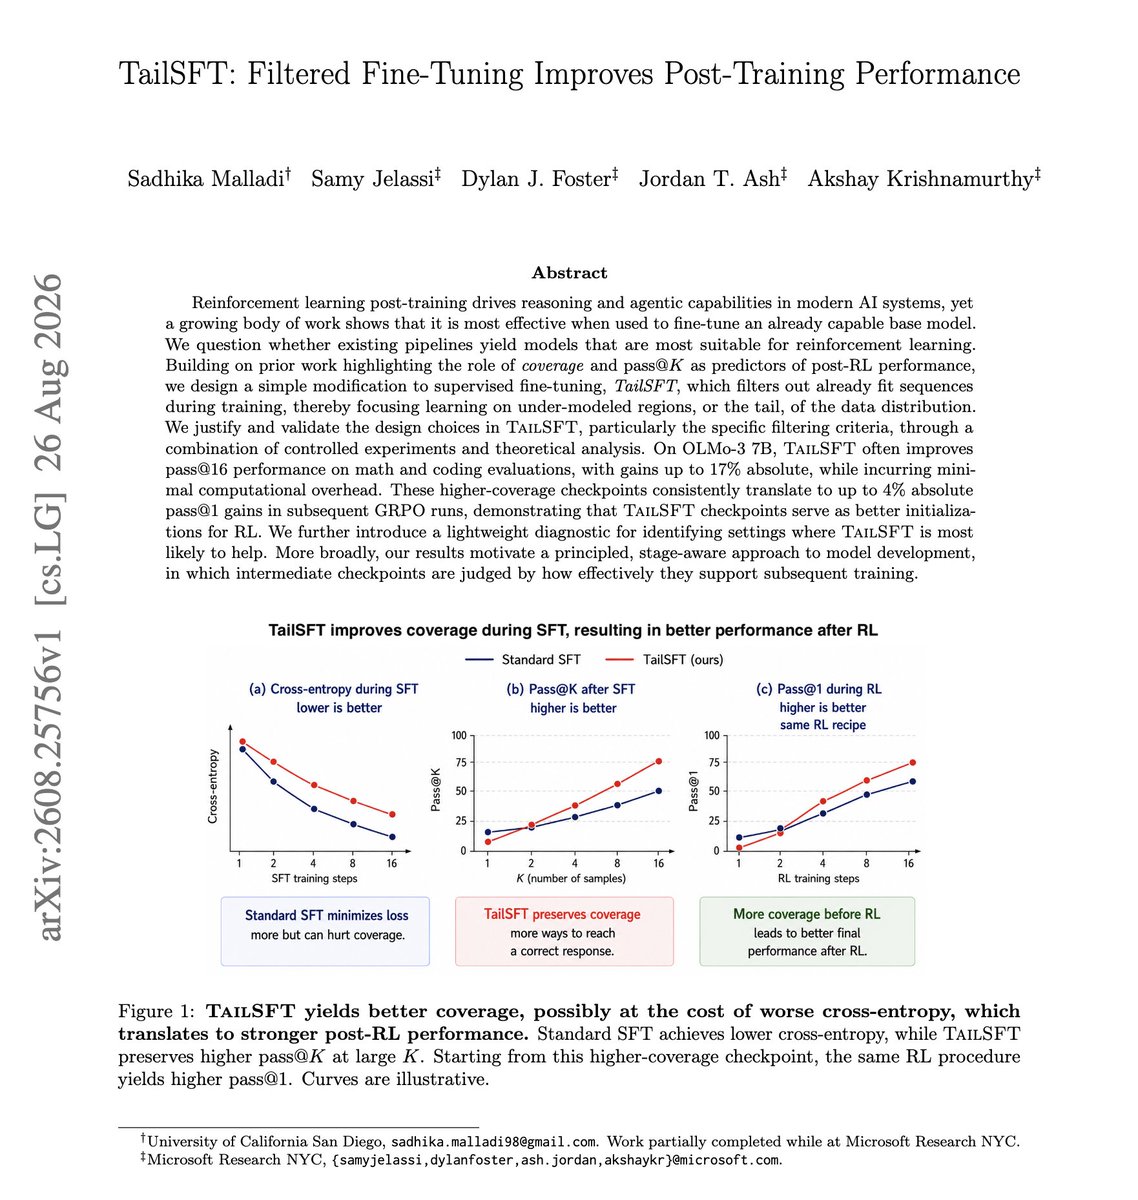
TailSFT: Phương pháp mới từ Microsoft giúp tối ưu hóa SFT để tăng cường hiệu suất RL

Interesting technical work from Microsoft. Provides a better understanding on SFT and how to levera…

DịchMicrosoft giới thiệu TailSFT, kỹ thuật lọc dữ liệu giúp mô hình tập trung vào các phần chưa tối ưu thay vì lãng phí tài nguyên vào những gì đã học tốt, từ đó cải thiện đáng kể khả năng lập trình và toán học sau khi huấn luyện tăng cường (RL).

30/08

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

CLEAR: Phương pháp điều chỉnh an toàn linh hoạt theo câu lệnh, bảo toàn hiệu năng mô hình AI

Safety alignment usually costs utility because the aligned weights apply to every prompt; New Stanf…

DịchNghiên cứu mới từ Stanford giới thiệu CLEAR, sử dụng mạng cổng nhỏ để điều chỉnh mức độ can thiệp an toàn theo từng câu lệnh, giúp mô hình giữ nguyên hiệu năng gốc mà vẫn đảm bảo tính bảo mật.

29/08

Thứ Bảy · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnRecuris: Bước đột phá mới về bộ nhớ cho AI Agent, giúp nâng cấp hiệu suất từ mô hình 3B đến Claude Opus 5

Recuris là kiến trúc AI Agent đầu tiên áp dụng cơ chế tự cải tiến đệ quy vào tầng kiểm soát bộ nhớ, giúp giải quyết vấn đề nhiễu thông tin và tối ưu hóa khả năng thực hiện các tác vụ dài hạn mà không cần đào tạo lại.


Vì sao đáng đọc: Nghiên cứu mang tính đột phá về kiến trúc bộ nhớ cho Agent, giải quyết bài toán hóc búa về hiệu suất dài hạn và có khả năng ứng dụng rộng rãi từ mô hình nhỏ đến lớn.
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 36/100

Google WikiSkill: Bí quyết xây dựng thư viện kỹ năng cho AI Agent

Nghiên cứu WikiSkill từ Google đề xuất chia thư viện kỹ năng thành 3 tầng: quỹ đạo gốc, đúc kết nhận thức và sổ tay thực thi. Việc lưu trữ các thất bại giúp mô hình nhỏ đạt hiệu suất vượt trội, nhưng cần cẩn trọng vì dữ liệu kém chất lượng có thể làm giảm đáng kể khả năng của AI.

QbitAI
Mô hìnhĐiểm AI 92/100

Tinh chọnClaude tự huấn luyện chính mình: Chi phí chỉ 4 USD/giờ, vượt xa hiệu suất chuyên gia con người

Anthropic đạt bước tiến mới khi để Claude tự tối ưu hóa mô hình với chi phí cực thấp, đánh dấu cột mốc quan trọng trong kỷ nguyên AI tự tiến hóa.


Vì sao đáng đọc: Tin tức mang tính đột phá về khả năng tự tiến hóa của AI, thay đổi cuộc chơi về hiệu quả chi phí và năng suất nghiên cứu, rất đáng quan tâm.

28/08

Thứ Sáu · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

TTPO: Tối ưu hóa chiến lược khi kiểm thử, giúp mô hình ngôn ngữ lớn tự học mà không cần nhãn

TTPO giới thiệu phương pháp tự học không cần nhãn bằng cách sử dụng bình chọn đa số làm nhãn giả và học tăng cường nhóm để tinh chỉnh mô hình. Kỹ thuật này giúp cải thiện đáng kể hiệu suất suy luận toán học của các mô hình nhỏ như Qwen3-1.7B, đạt kết quả ngang ngửa với phương pháp có giám sát.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Báo cáo kỹ thuật TaoLive: Huấn luyện AI Avatar tương tác thời gian thực với cơ chế Harness linh hoạt

TaoLive giới thiệu phương pháp Harness-Aware Training (HAT) giúp các mô hình AI nhỏ gọn thích nghi nhanh chóng với các thay đổi về kịch bản, công cụ và chiến lược marketing mà không cần huấn luyện lại, đảm bảo độ trễ thấp cho livestream.

27/08

Thứ Năm · 1 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 47/100

Recuris: Cơ chế 'kép' giúp AI thông minh hơn trong các tác vụ dài hạn

If you maintain a skill library for long-horizon agents, this one is worth your time. (bookmark it) …

DịchRecuris tối ưu hóa khả năng xử lý của AI bằng cách tách biệt bộ nhớ làm việc và bộ nhớ kinh nghiệm, giúp mô hình đưa ra quyết định dựa trên trạng thái nhiệm vụ thay vì lịch sử dữ liệu thô. Giải pháp này cải thiện đáng kể tỷ lệ thành công trên các tác vụ phức tạp và giảm tới 80% lỗi thường gặp.

26/08

Thứ Tư · 3 tin
WeChat: Tencent Hunyuan
Mô hìnhĐiểm AI 67/100

Tinh chọnTencent Hunyuan nén mô hình dịch thuật Hy-MT2-1.8B xuống còn 440MB, ứng dụng thực tế trên Bilibili

Tencent đã tối ưu hóa mô hình Hy-MT2-1.8B bằng kỹ thuật lượng tử hóa cực thấp, giúp đạt hiệu suất dịch thuật vượt trội trên Bilibili với tốc độ phản hồi chỉ từ 500-800ms.


Vì sao đáng đọc: Tin tức kỹ thuật ấn tượng về việc tối ưu hóa mô hình AI cho thiết bị đầu cuối, có tính ứng dụng thực tế cao và minh chứng rõ ràng về hiệu năng.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OraRL: Tối ưu hóa học tăng cường hiệu quả cho mô hình ngôn ngữ đa phương thức video

Nghiên cứu giới thiệu OraRL, phương pháp mới tận dụng dữ liệu chú giải làm 'oracle rollout' để cải thiện hiệu suất học tăng cường cho mô hình MLLM video, giải quyết vấn đề đảo ngược lợi thế trong quá trình huấn luyện.

24/08

Thứ Hai · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnCLEAR: Phương pháp định tuyến bộ điều hợp tiềm ẩn giúp LLM an toàn mà không làm giảm hiệu năng

CLEAR là khung điều chỉnh an toàn mới sử dụng cổng điều khiển ẩn để kích hoạt bộ điều hợp LoRA linh hoạt, giúp giảm phản hồi độc hại mà vẫn giữ nguyên chất lượng câu trả lời cho các truy vấn thông thường.


Vì sao đáng đọc: Giải quyết bài toán đánh đổi giữa an toàn và hiệu năng trong LLM bằng kỹ thuật tinh chỉnh thông minh, có kết quả thực nghiệm ấn tượng trên Llama-3.

23/08

Chủ Nhật · 1 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 31/100

Điểm tin AI tuần này: Đột phá huấn luyện Agent và giải mã nút thắt kỹ năng

Microsoft giới thiệu Agent Lightning v1.0 giúp tích hợp Agent vào học tăng cường mà không cần viết lại code, đồng thời cải thiện đáng kể hiệu suất mô hình Qwen3.5-9B. Ngoài ra, các nghiên cứu mới còn giải quyết tình trạng quá tải kỹ năng và đề xuất phương pháp đo lường hiện tượng 'quên' trong mô hình AI.

22/08

Thứ Bảy · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

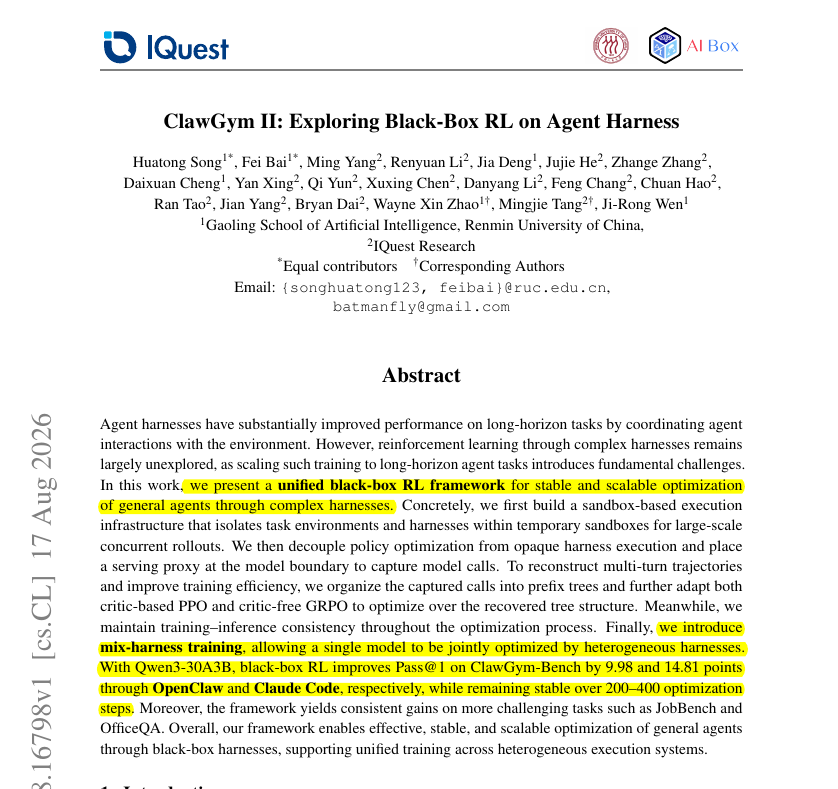
ClawGym II: Tối ưu hóa tác nhân AI thông qua huấn luyện RL hộp đen

You can now RL-train an agent through the same complex harness it will actually run in, without need…

DịchKhung ClawGym II tích hợp OpenClaw và Claude Code như các hệ thống hộp đen vào quy trình huấn luyện RL, giúp cải thiện đáng kể điểm số trên các bộ benchmark như ClawGym-Bench mà không cần can thiệp vào cấu trúc nội tại của mô hình.

20/08

Thứ Năm · 1 tin

18/08

Thứ Ba · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

Nghiên cứu mới: Quy trình 'Kiểm toán - Sửa lỗi' giúp giảm tỷ lệ báo động giả cho LLM

Nghiên cứu trên ProcessBench chỉ ra rằng việc đưa quy trình 'kiểm toán - sửa lỗi' vào ngữ cảnh giúp LLM giảm 9-25% tỷ lệ báo động giả. Kết quả cho thấy mô hình không mất khả năng phân biệt mà chỉ điều chỉnh ngưỡng phán đoán, giúp việc kiểm chứng trở nên chính xác và hiệu quả hơn.

14/08

Thứ Sáu · 1 tin
QbitAI
NgànhĐiểm AI 65/100

Taichu Yuanji đồng hành cùng cuộc thi AI+ Giáo dục cấp quốc gia, mở đơn đăng ký hạng mục tối ưu mô hình trên chip tăng tốc

Taichu Yuanji chính thức khởi động hạng mục thi đấu về tối ưu hóa mô hình trên chip tăng tốc AI, nằm trong khuôn khổ cuộc thi AI+ Giáo dục cấp quốc gia nhằm thúc đẩy ứng dụng công nghệ trong giảng dạy.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (56 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa mô hình” | AIHOT.vn