🚀 FIT-GGUF brings controllable-size mixed-precision quantization to MiniCPM5-2B Developer @Scorp1o_…
DịchCông cụ FIT-GGUF cho phép người dùng MiniCPM5-2B tùy chỉnh dung lượng file hoặc độ chính xác mong muốn. Hệ thống sẽ tự động phân bổ độ phân giải cho từng tensor, đồng thời dự đoán và xác thực file GGUF đầu ra.
Tại Snapdragon Summit 2026, Qualcomm và PrismML đã giới thiệu mô hình Bonsai 1.7B sử dụng lượng tử hóa 1-bit, cho phép chạy mượt mà trên kính thông minh Snapdragon AR1 Gen 1 với mức tiêu thụ bộ nhớ chỉ bằng 1/4 so với chuẩn 4-bit truyền thống.
New Google paper shows for small quantized LLMs on serverless CPUs, 55-70% of cold-start latency is …
DịchNghiên cứu của Google chỉ ra rằng 55-70% độ trễ khởi động của các LLM lượng tử hóa trên CPU serverless đến từ việc tải trọng số mô hình. Việc tăng dung lượng RAM cấp phát có thể giúp tối ưu hóa đáng kể tốc độ suy luận.
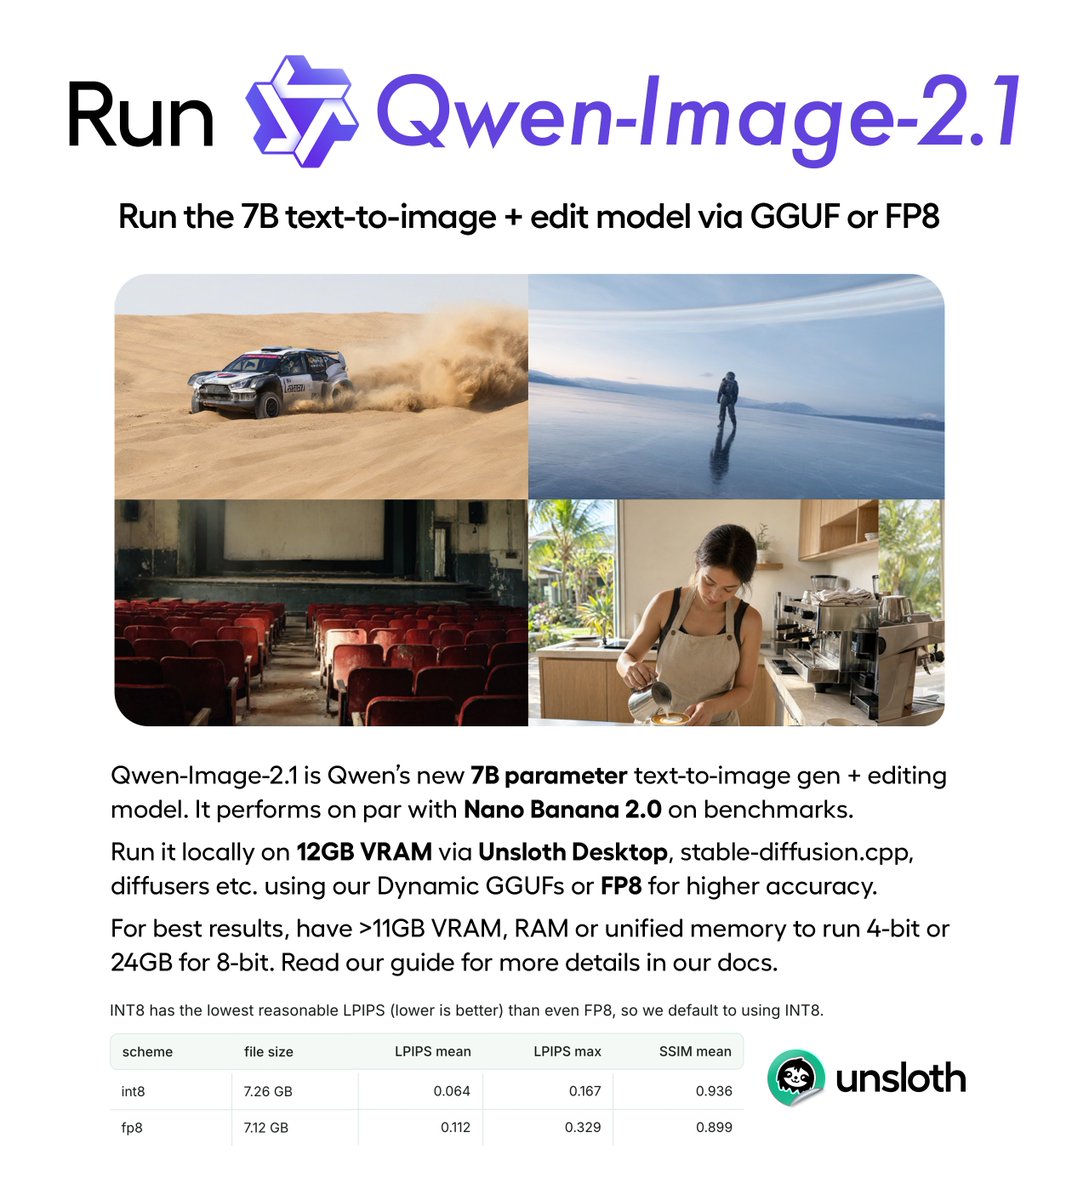
Qwen-Image-2.1 can now run locally on 12GB VRAM with Unsloth GGUFs! 🖼️ The 7B model performs on pa…
DịchUnsloth vừa phát hành phiên bản lượng tử hóa GGUF cho mô hình Qwen-Image-2.1, cho phép chạy cục bộ trên các thiết bị có VRAM 12GB với hiệu suất ngang ngửa Nano Banana 2.0.
Một phòng thí nghiệm học thuật khởi xướng 'Tuần lễ mã nguồn mở', chứng minh khả năng chạy mô hình Qwen 3.6 35B-A3B trên Mac với tốc độ ấn tượng 450 tokens/giây nhờ kỹ thuật lượng tử hóa 1.5-bit.
Nghiên cứu giới thiệu phương pháp nén mô hình Cellpose-SAM giúp giảm dung lượng lưu trữ tới 6,76 lần mà vẫn duy trì độ chính xác cao khi phân tích hình ảnh tế bào gốc trên các thiết bị phần cứng hạn chế.
ByteShape giới thiệu mô hình Qwen 3.8 27B đã được tối ưu hóa bằng ShapeLearn, đạt tới 99,63% độ chính xác so với bản gốc BF16 trên GPU-5, thiết lập chuẩn mực mới về tốc độ và chất lượng.
Bài viết tổng hợp từ MarkTechPost giúp phân biệt rõ ràng giữa các định dạng lưu trữ và phương pháp lượng tử hóa LLM, đồng thời giải thích chi tiết cơ chế hoạt động của GGUF, GPTQ, AWQ và EXL2/EXL3.
PrismML vừa giới thiệu Bonsai 2 27B dựa trên Qwen3.8, sử dụng kỹ thuật lượng tử hóa 3 giá trị giúp giảm dung lượng bộ nhớ xuống dưới 1/9 nhưng vẫn duy trì 98,2% hiệu suất so với bản gốc.
Một giả thuyết mới cho rằng khi chạy ở chế độ đơn luồng (concurrency=1), việc sử dụng GEMV thay vì GEMM trong quá trình lượng tử hóa cực hạn có thể giúp giảm thiểu sai số và cải thiện hiệu suất mô hình. Đây hiện chỉ là suy đoán cá nhân và chưa có dữ liệu thực nghiệm kiểm chứng.
Three quantized versions of Ling-3.0-flash-Fin are now available: FP8, FP4 and INT4. If you're build…
DịchLing-3.0-flash-Fin hiện đã hỗ trợ các định dạng FP8, FP4 và INT4, giúp người dùng linh hoạt tối ưu hóa hiệu suất và bộ nhớ cho các quy trình nghiệp vụ tài chính thực tế.
Interesting new on-device local AI agentic system - seems to be running an open-weights 4B model qua…
DịchThomas Wolf chia sẻ về một hệ thống AI Agent chạy cục bộ đầy hứa hẹn, dường như đang vận hành mô hình mã nguồn mở 4B đã được lượng tử hóa 4-bit thông qua framework MLX.
Two updates for Ling-3.0-flash-VL: - Now available on OpenRouter with two weeks of free access - FP4…
DịchMô hình Ling-3.0-flash-VL vừa ra mắt trên OpenRouter với ưu đãi dùng thử miễn phí 2 tuần, đồng thời công bố mã nguồn các phiên bản lượng tử hóa FP4 và INT4.
HyQuant tối ưu hóa hiệu suất LLM bằng cách kết hợp lượng tử hóa bit thấp cho hầu hết các trạng thái Attention, đồng thời giữ độ chính xác cao cho các vùng dữ liệu quan trọng, giúp giảm thiểu sai số mà vẫn đảm bảo tốc độ.
inclusionAI vừa phát hành phiên bản lượng tử hóa int4 của mô hình thị giác ngôn ngữ Ling-3.0-flash-VL trên HuggingFace. Người dùng cần đăng nhập và xác thực tài khoản để truy cập thông tin chi tiết do các hạn chế truy cập hiện tại.
SQS là khung làm việc thống nhất kết hợp cắt tỉa và lượng tử hóa bit thấp thông qua học biến phân Bayes, giúp nén mô hình hiệu quả hơn mà vẫn duy trì độ chính xác cao.
Thanks for testing it out and sharing these numbers! 🙌 "Run a swarm of these locally" - that's exa…
DịchMặt Bích AI khẳng định tầm nhìn về việc chạy các mô hình 2B tối ưu trên thiết bị cá nhân. Với kích thước chỉ 1.56GB sau khi lượng tử hóa, mô hình đạt tốc độ hơn 200 token/giây trên RTX 4090 mà vẫn giữ được hiệu năng tương đương các mô hình 4B.
Nghiên cứu chỉ ra rằng việc lượng tử hóa trạng thái trong mạng hồi quy (RNN) có thể gây sai số nghiêm trọng khi dự đoán các thông số sinh học. Việc lưu trữ trạng thái 4-bit làm tăng sai số dự báo lên gấp hàng trăm lần so với mô hình gốc.
Nghiên cứu Minima chứng minh khả năng duy trì hiệu suất vượt trội của kiến trúc Gated DeltaNet khi áp dụng định dạng lượng tử hóa NVFP4 W4A4 trên toàn bộ các lớp tuyến tính của mô hình Qwen3.8-27B.
We compressed Hy4-preview from 1.5TB to ~200GiB GGUF and it still works well! Meet MIX-STQ1_0.The…
DịchTencent đã tối ưu hóa mô hình Hunyuan Hy4-preview từ 1.5TB xuống còn 200GB định dạng GGUF bằng kỹ thuật lượng tử hóa hỗn hợp MIX-STQ1_0, giúp mô hình khổng lồ chạy mượt mà hơn trên phần cứng hạn chế.
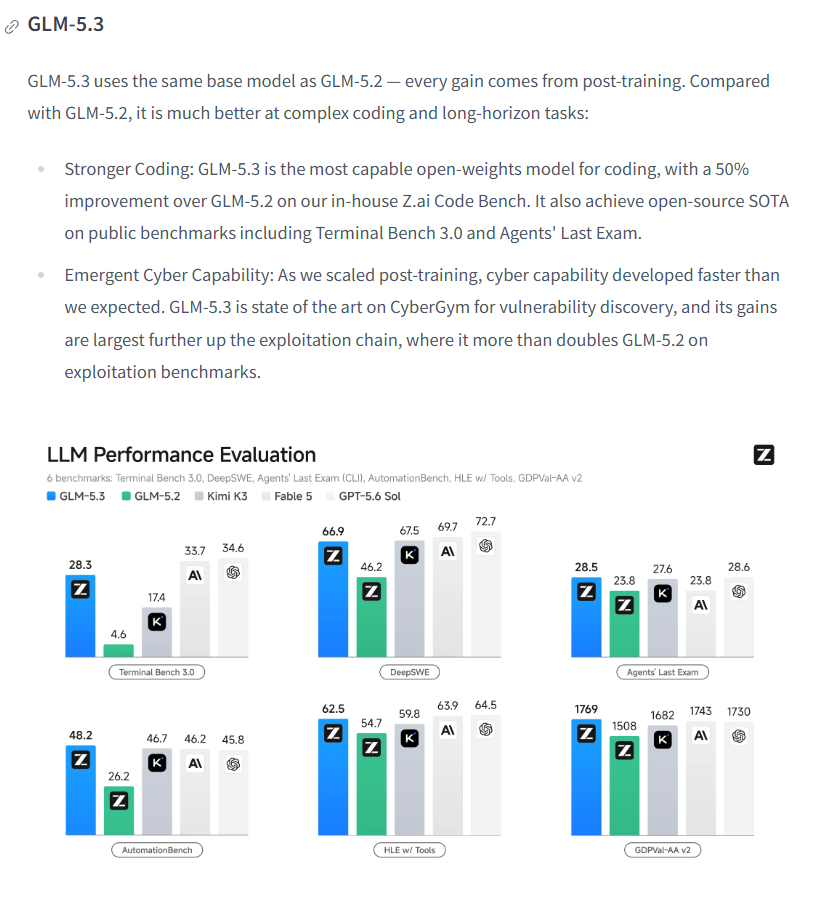
GLM-5.3 is officially live on Hugging Face. What should run it locally: - FP8: 10-12× H100 or 8× H…
DịchGLM-5.3 đã có mặt trên Hugging Face với các phiên bản lượng tử hóa GGUF và NVFP4, cho phép người dùng dễ dàng triển khai và chạy trực tiếp trên máy tính cá nhân.
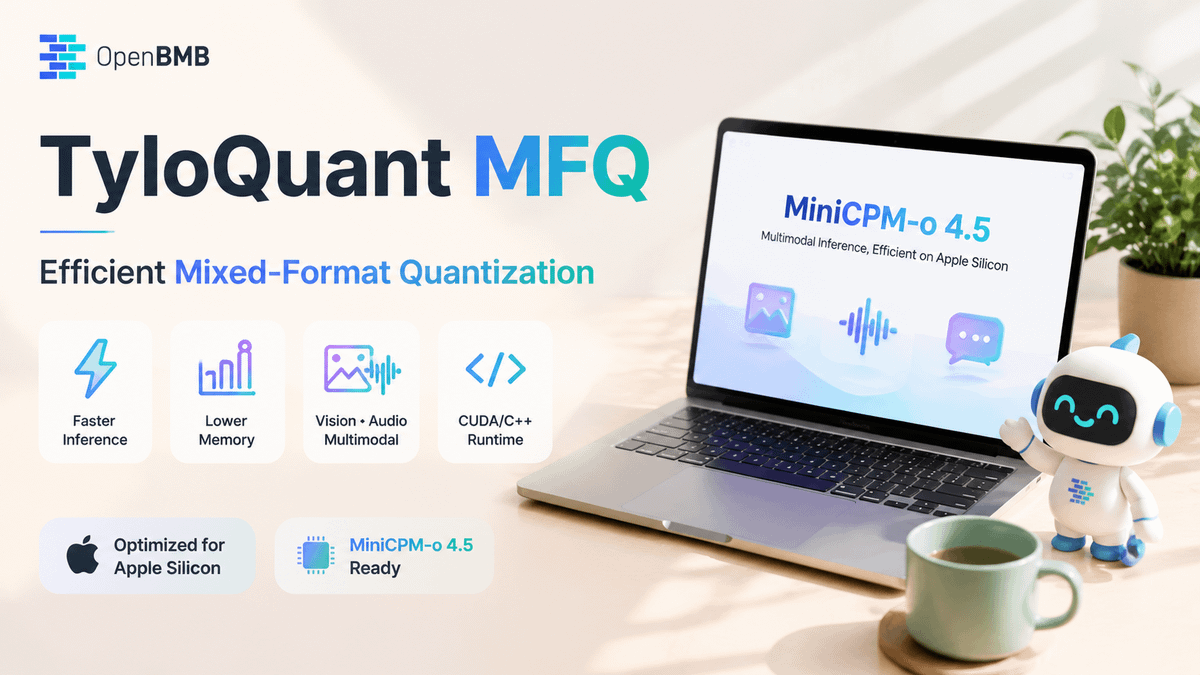
MiniCPM-o 4.5 now runs efficiently on Apple Silicon with TyloQuant MFQ! 🥰 The team at @Tylogi_ai h…
DịchMô hình MiniCPM-o 4.5 hiện đã có thể chạy cục bộ trên chip Apple Silicon thông qua kỹ thuật lượng tử hóa TyloQuant MFQ, giúp tối ưu bộ nhớ mà vẫn giữ nguyên khả năng xử lý đa phương thức và tương tác thời gian thực.
Qwen giới thiệu mô hình MoE đa phương thức Qwen3.8-Flash-Next với 125B tham số (kích hoạt 6B), mang lại hiệu suất vượt trội và là bước đệm cho kiến trúc Qwen4. Người dùng đã có thể trải nghiệm các phiên bản lượng tử hóa tối ưu trên nền tảng Unsloth.
Phương pháp QAH giúp phục hồi khả năng suy luận và lập trình cho các mô hình LLM sau khi nén và lượng tử hóa 4-bit bằng cách chưng cất trực tiếp từ mô hình gốc, thay thế hiệu quả cho kỹ thuật QAT truyền thống.
Huge thanks to Unsloth for the great work. This is wonderful news for the community! 🥳Qwen3.8-27B, …
DịchĐội ngũ Qwen hợp tác cùng Unsloth phát hành phiên bản lượng tử hóa GGUF cho Qwen2.5-27B, cho phép chạy mượt mà trên thiết bị có 8GB RAM với độ chính xác ấn tượng nhờ công nghệ Dynamic V3.
Liquid AI giới thiệu các checkpoint Q4_0 cho dòng mô hình LFM 2.5, sử dụng kỹ thuật chưng cất nhận thức lượng tử (QAD) để duy trì tốc độ cao trong khi khôi phục tới 97% độ chính xác so với chuẩn BF16.
Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng giúp tối ưu hóa mô hình nhỏ (SLM) cho thiết bị biên, rất hữu ích cho cộng đồng phát triển AI tại Việt Nam.
ReRound sử dụng mô hình khuếch tán để tái tạo trọng số, giúp xác định chính xác hướng làm tròn cho các giá trị nằm gần điểm giữa của khoảng lượng tử hóa, từ đó tối ưu hóa hiệu suất LLM ở mức bit thấp.
 ModelBest OpenBMB@OpenBMB