Mô hình
PrismML ra mắt Ternary Bonsai 2 27B: Nén mô hình gấp 9 lần nhưng vẫn giữ 98,2% hiệu năng
(giờ Việt Nam)
Tóm tắt AI
Dựa trên Qwen 27B, Ternary Bonsai 2 sử dụng kỹ thuật trọng số tam phân để giảm dung lượng xuống chỉ còn 5,9GB, giúp tối ưu hóa đáng kể khả năng chạy mô hình lớn trên phần cứng hạn chế.
Bản dịch AI

Hai tháng trước, chúng tôi đã ra mắt các mô hình Bonsai 27B đầu tiên và chứng minh rằng một mô hình đa phương thức (multimodal) lớp 27B có thể được nén đủ để chạy hiệu quả trên thiết bị cục bộ. Hôm nay, chúng tôi phát hành Ternary Bonsai 2 27B, mô hình mạnh mẽ nhất của chúng tôi từ trước đến nay.
Dựa trên Qwen3.8 27B, Ternary Bonsai 2 27B mang đến khả năng lập luận, viết mã, thị giác và tác vụ đại lý (agentic) mạnh mẽ hơn cho dòng Bonsai, đồng thời vẫn duy trì cấu hình triển khai đặc trưng của nó: dung lượng bộ nhớ nhỏ hơn đáng kể, thông lượng cục bộ cao và hiệu suất năng lượng tốt hơn.
Ternary Bonsai 2 27B sử dụng các trọng số tam phân {−1, 0, +1} với kỹ thuật chia tỷ lệ theo nhóm FP16, đạt hiệu quả 1,76 bit trên mỗi trọng số và tổng dung lượng mô hình là 5,9GB. Cách biểu diễn bit thấp này được áp dụng xuyên suốt từ đầu đến cuối mô hình ngôn ngữ. Mô hình hỗ trợ cửa sổ ngữ cảnh 262K token, đầu vào đa phương thức văn bản và hình ảnh, đồng thời được phát hành theo giấy phép Apache 2.0.
So với phiên bản có độ chính xác đầy đủ (full-precision), Ternary Bonsai 2 27B nhỏ hơn gấp 9 lần trong khi vẫn giữ lại 98,2% hiệu suất chuẩn (benchmark) tổng hợp. Ở mức độ duy trì này, việc nén trở thành chìa khóa cho triển khai: khả năng gần như tương đương, trong một dung lượng có thể chạy trên nhiều thiết bị hơn rất nhiều.
Những thay đổi so với bản phát hành Bonsai 27B đầu tiên
Bản phát hành Bonsai 27B đầu tiên của chúng tôi là một cột mốc quan trọng, cung cấp một cách thực tế để chạy trí tuệ lớp 27B trên các thiết bị cục bộ. Bonsai 2 27B tập trung vào bước tiếp theo: cải thiện chất lượng mô hình và hiệu suất thời gian chạy cần thiết cho các ứng dụng cục bộ trong thế giới thực. So với thế hệ Bonsai 27B trước đó, Bonsai 2 27B mang lại:
Khả năng cao hơn tại cùng một điểm triển khai
Trên một bộ tiêu chuẩn đánh giá bao gồm lập luận, toán học, viết mã, tuân thủ hướng dẫn, thị giác và sử dụng công cụ đại lý, Ternary Bonsai 2 27B đạt 83,9 điểm, giữ lại 98,2% hiệu suất tổng hợp của Qwen3.8 27B.
Kết quả quan trọng không chỉ nằm ở điểm số tổng hợp, mà là ở việc khả năng được duy trì ở đâu. Các đại lý viết mã, hệ thống sử dụng công cụ, quy trình làm việc đa phương thức và các tác vụ dài hạn đặc biệt nhạy cảm với sự suy giảm mô hình vì những lỗi nhỏ có thể tích tụ qua nhiều bước. Bonsai 2 27B bảo toàn phần lớn hiệu suất của mô hình độ chính xác đầy đủ trong chính những lĩnh vực này trong khi vận hành với dung lượng bộ nhớ chỉ bằng một phần nhỏ.
So với mô hình độ chính xác đầy đủ và các lựa chọn thay thế bit thấp khác, Bonsai 2 27B nổi bật như một ngoại lệ về mật độ trí tuệ. Nhiều lựa chọn thay thế bit thấp chỉ có thể triển khai được bằng cách từ bỏ khả năng đáng kể trong việc viết mã, thị giác hoặc sử dụng công cụ đại lý. Bonsai 2 27B đẩy giới hạn tiến tới cả khả năng cao hơn và mức sử dụng bộ nhớ thấp hơn.
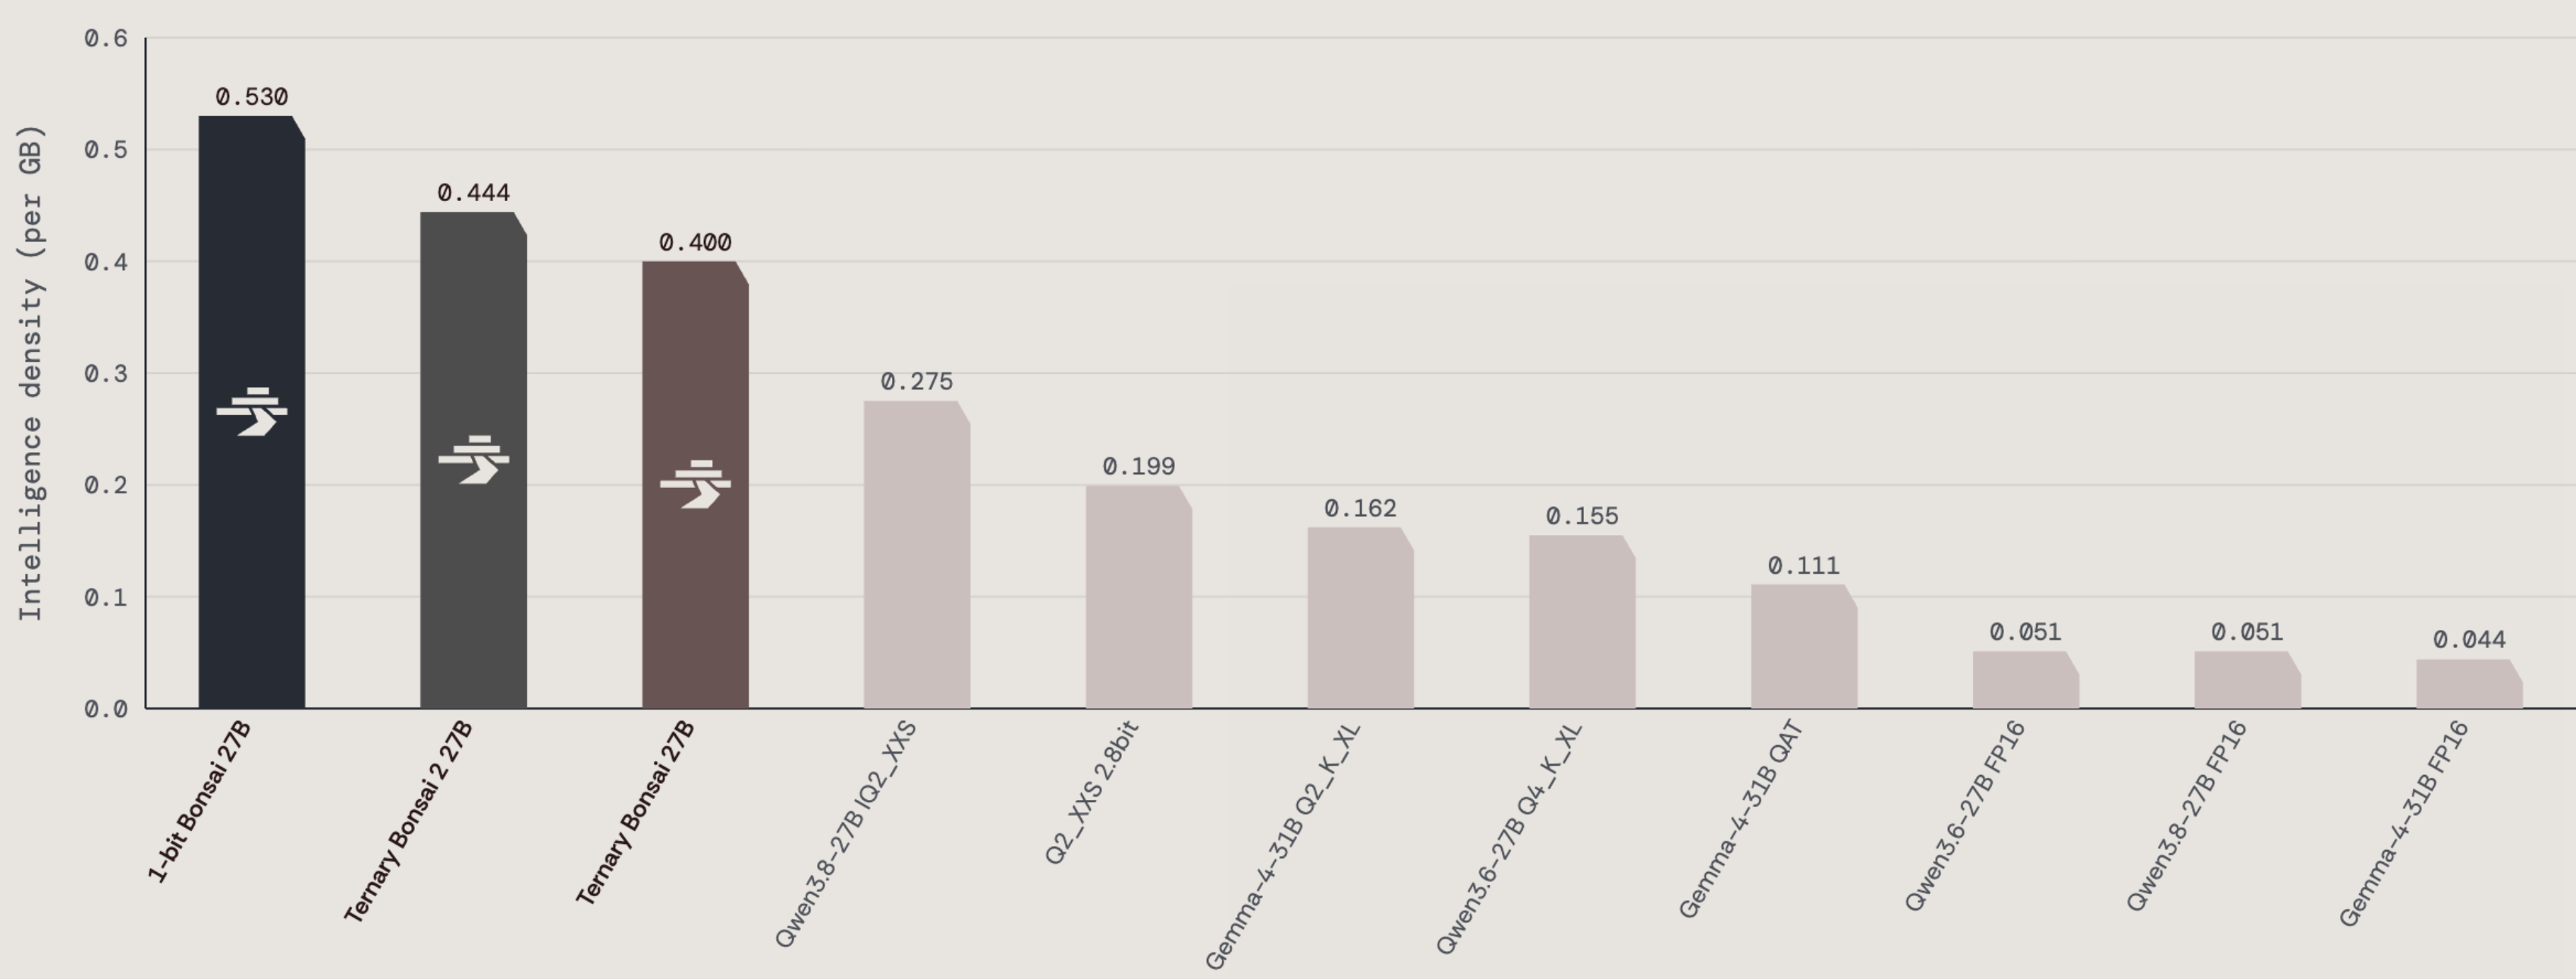
Với Bonsai 2 27B, các mô hình cục bộ có thể bắt đầu đảm nhận các công việc tri thức thực tế: vòng lặp đại lý viết mã, quy trình làm việc sử dụng máy tính, phân tích tài liệu riêng tư, gỡ lỗi đa phương thức và điều phối kết hợp, nơi các mô hình cục bộ xử lý các tác vụ nhạy cảm hoặc tần suất cao trong khi chuyển tiếp có chọn lọc lên đám mây.
Thông lượng và hiệu suất năng lượng
Ternary Bonsai 2 27B đạt tới 143 token/giây trên NVIDIA GeForce RTX 5090 và 46,8 token/giây trên M5 Max. Trên RTX 4090, Ternary Bonsai 2 27B chỉ tiêu thụ 0,714 mWh/token, giúp nó tiết kiệm năng lượng hơn 40% so với một mô hình 8B chạy ở độ chính xác đầy đủ.
Đối với các trợ lý viết mã, thông lượng cao hơn đồng nghĩa với các vòng lặp chỉnh sửa-gỡ lỗi nhanh hơn. Đối với các đại lý đa phương thức, điều đó có nghĩa là các lần lặp lại nhanh hơn trên ảnh chụp màn hình, tài liệu và các lệnh gọi công cụ. Đối với các quy trình làm việc cục bộ riêng tư, hiệu suất năng lượng tốt hơn đồng nghĩa với việc suy luận hữu ích hơn trên cùng một thiết bị, thời lượng pin dài hơn và lộ trình thực tế hơn cho các trợ lý có thể duy trì ở chế độ nền mà không cần liên tục gọi lên đám mây.
Tại sao bản phát hành này quan trọng
So với Ternary Bonsai 27B, Ternary Bonsai 2 27B mới đã thu hẹp khoảng cách duy trì so với mô hình độ chính xác đầy đủ từ 95% lên hơn 98%. Đây là một cải tiến đáng kể giúp bản phát hành hiện tại gần như "không mất mát" (lossless). Nó củng cố thêm quan điểm rằng các mô hình bit thấp có thể là cách tốt nhất để triển khai AI.
Điều đó có ý nghĩa vượt xa việc suy luận cục bộ. Các mô hình bit thấp có thể thay đổi kinh tế và kiến trúc của các hệ thống AI trên các thiết bị, máy trạm và trung tâm dữ liệu: đưa các mô hình lớn hơn vào cùng một giới hạn bộ nhớ, phục vụ nhiều người dùng hơn trên cùng một phần cứng, giảm năng lượng trên mỗi lần suy luận và cho phép các hệ thống kết hợp quyết định linh hoạt những gì nên chạy cục bộ và những gì nên chạy trên đám mây.
Câu hỏi sẽ ngày càng không chỉ là mô hình có khả năng đến mức nào, mà là bao nhiêu trí tuệ hữu ích có thể được cung cấp trong một ngân sách bộ nhớ, tính toán và năng lượng nhất định. Nếu khả năng có thể tiếp tục mở rộng trong khi các yêu cầu đó giảm đáng kể, phạm vi triển khai cho các mô hình tương lai sẽ mở rộng trên toàn bộ hệ thống: từ thiết bị cá nhân đến các trung tâm dữ liệu quy mô lớn.
Phạm vi nền tảng
Bonsai 2 27B chạy trên GPU NVIDIA thông qua CUDA và trên các thiết bị Apple (Mac, iPhone, iPad) thông qua MLX, nhờ các nhân (kernel) bit thấp tùy chỉnh. Trọng số mô hình hiện đã có sẵn theo Giấy phép Apache 2.0.
Thông tin kỹ thuật đầy đủ về quy trình nén, đánh giá và đo lường hiệu năng của chúng tôi có sẵn trong sách trắng (whitepaper).
Hợp tác với chúng tôi
Chúng tôi làm việc với các nhóm để tùy chỉnh các mô hình Bonsai cho ứng dụng của họ, từ hậu đào tạo trên dữ liệu chuyên biệt đến tối ưu hóa suy luận cho phần cứng mục tiêu. Nếu bạn đang xây dựng các sản phẩm AI với các yêu cầu khắt khe về bộ nhớ, độ trễ hoặc năng lượng, chúng tôi rất muốn khám phá cách Bonsai có thể hỗ trợ. Hãy liên hệ tại [email protected].
Gia nhập cùng chúng tôi
PrismML xuất thân từ một nhóm các nhà nghiên cứu tại Caltech và được thành lập với sự hỗ trợ từ Khosla Ventures, Cerberus và Google, cùng sự hỗ trợ liên tục từ Samsung. Chúng tôi đã dành nhiều năm để giải quyết một trong những vấn đề khó khăn nhất của lĩnh vực này: nén các mạng thần kinh mà không làm mất đi khả năng lập luận của chúng.
Nếu bạn muốn giúp xây dựng thế hệ AI tiên tiến tiếp theo, chúng tôi rất mong nhận được phản hồi từ bạn. Hãy xem trang tuyển dụng của chúng tôi.
Bài viết được AI dịch và tổng hợp tự động từ Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.