Hôm nay · 28/09

Thứ Hai · 1 tin

26/09

Thứ Bảy · 2 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 70/100

Cùng sự kiệnĐội ngũ Qwen công bố Qwen3.8-Omni-Flash: Kỷ nguyên của các tác nhân AI toàn năng

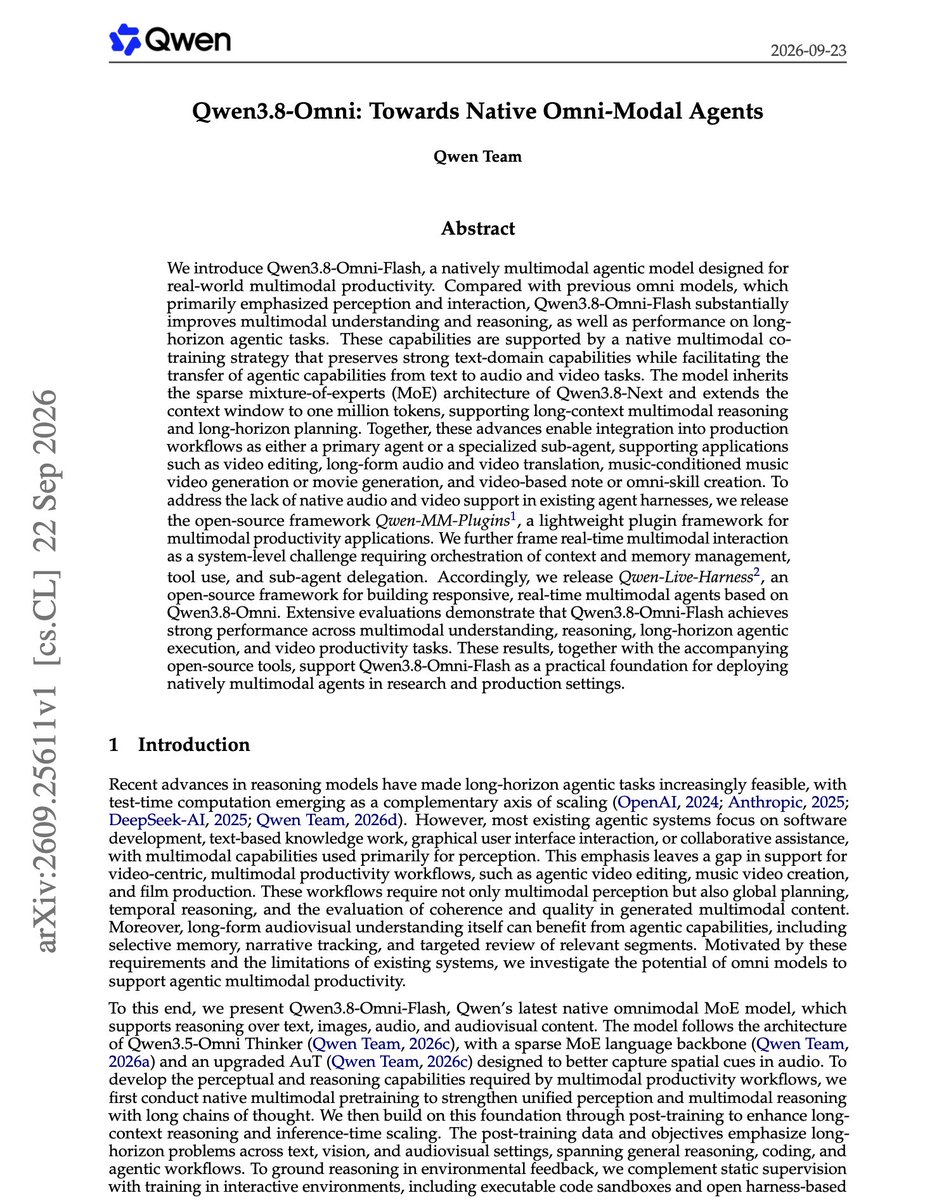
The era of omni agents is upon us. This is a great report by the Qwen Team on their omni-modal agen…

DịchQwen3.8-Omni-Flash là mô hình đa phương thức gốc, sử dụng kiến trúc MoE thưa thớt với cửa sổ ngữ cảnh 1 triệu token, tối ưu cho các tác vụ phức tạp như chỉnh sửa video và dịch thuật âm thanh dài.

Cùng sự kiện, bài đại diện «Đội ngũ Qwen công bố báo cáo kỹ thuật về mô hình đa phương thức Qwen3.8-Omni-Flash»
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 69/100

Đội ngũ Qwen công bố báo cáo kỹ thuật về mô hình đa phương thức Qwen3.8-Omni-Flash

Era of the omni models is upon us. This is a great report by the Qwen Team on their omni model. Th…

DịchQwen3.8-Omni-Flash là mô hình đa phương thức gốc, sử dụng kiến trúc MoE thưa với cửa sổ ngữ cảnh 1 triệu token, tối ưu cho các tác vụ tác nhân AI dài hạn như chỉnh sửa video và dịch thuật âm thanh-hình ảnh chuyên sâu.

24/09

Thứ Năm · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

Công bố báo cáo kỹ thuật Hunyuan-A13B: Mô hình MoE mã nguồn mở với 80B tham số và 13B tham số kích hoạt

Tencent giới thiệu Hunyuan-A13B, mô hình MoE tối ưu hiệu suất với 80B tham số tổng nhưng chỉ kích hoạt 13B khi suy luận. Điểm nhấn là khung tư duy kép (Chain-of-Thought) giúp cân bằng tốc độ xử lý cho các câu hỏi đơn giản và độ chính xác cho các bài toán phức tạp.

23/09

Thứ Tư · 1 tin

22/09

Thứ Ba · 2 tin
SemiAnalysis@SemiAnalysis_
Nghiên cứuĐiểm AI 37/100

SemiAnalysis phân tích bài toán tính toán và luân chuyển dữ liệu trong suy luận mô hình MoE

Computation and Data Movement for Inference Mapping MoE models onto inference hardware: structure, f…

DịchBài viết đi sâu vào cách tối ưu hóa kiến trúc phần cứng để vận hành hiệu quả các mô hình MoE, tập trung giải quyết nút thắt về luân chuyển dữ liệu trong quá trình suy luận.

21/09

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

IntBMoE: Tối ưu hóa kiến trúc Mixture-of-Experts thông qua cơ chế điều phối khối

IntBMoE giải quyết bài toán đánh đổi giữa hiệu năng, chi phí tính toán và bộ nhớ trong mô hình MoE bằng cách kết hợp kỹ thuật trộn chuyên gia dày đặc với cơ chế thực thi khối thưa thớt, cho phép kiểm soát độc lập các thông số này.

MarkTechPost
Mô hìnhĐiểm AI 70/100

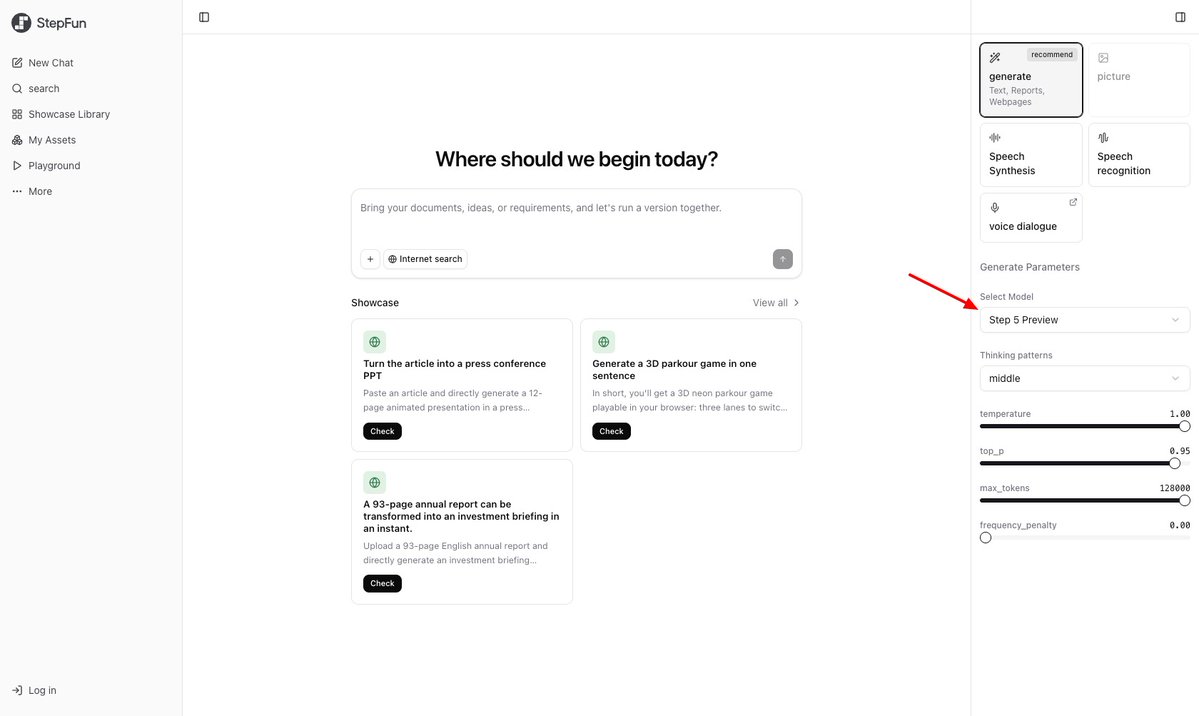
Cùng sự kiệnStepFun ra mắt Step 5 Preview: Mô hình MoE 600B tham số, hỗ trợ cửa sổ ngữ cảnh 1 triệu token

StepFun giới thiệu Step 5 Preview, mô hình MoE đa phương thức mạnh mẽ với 600B tham số, hỗ trợ xử lý 1 triệu token và tích hợp sâu cho các tác vụ AI đại lý.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»
Hongming@hongming731
Mô hìnhĐiểm AI 45/100

Cùng sự kiệnĐiểm tin AI: Step 5 Preview của StepFun và lộ trình chuyển đổi sang Bun

StepFun ra mắt Step 5 Preview với kiến trúc MoE 600 tỷ tham số, hỗ trợ cửa sổ ngữ cảnh 1 triệu token và đa phương thức. Mô hình dự kiến sẽ được công khai trọng số vào ngày 15/10.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»

20/09

Chủ Nhật · 6 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 68/100

Cùng sự kiệnStepFun ra mắt Step 5 Preview: Mô hình MoE 600B tham số, mở quyền truy cập trọng số từ 15/10

StepFun giới thiệu Step 5 Preview, mô hình MoE 600B tham số tối ưu cho tác vụ đại lý thông minh, hỗ trợ cửa sổ ngữ cảnh 1 triệu token và khả năng xử lý thị giác.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»
Testing Catalog@testingcatalog
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnStepFun ra mắt Step 5: Mô hình MoE 600B tham số, hỗ trợ 1 triệu token và mở quyền truy cập trọng số

StepFun released Step 5 Preview, a new 600B total / 27B active MoE model with 1M context. > Step 5…

DịchStepFun giới thiệu Step 5 Preview, mô hình MoE mạnh mẽ với 600B tham số, tối ưu cho tác vụ đại lý (agentic) và tài chính. Mô hình hỗ trợ cửa sổ ngữ cảnh 1 triệu token, khả năng xử lý hình ảnh và sẽ chính thức mở quyền truy cập trọng số vào ngày 15/10.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»
Pandaily
Mô hìnhĐiểm AI 85/100

Cùng sự kiệnStepFun ra mắt Step 5 Preview: Mô hình MoE 600B, cửa sổ ngữ cảnh 1 triệu token

StepFun giới thiệu Step 5 Preview với kiến trúc MoE 600B tham số, hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token cho các tác vụ đại lý thông minh. Trọng số mô hình dự kiến sẽ được công bố vào ngày 15/10.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»
StepFun@StepFun_ai
Mô hìnhĐiểm AI 60/100

Cùng sự kiệnStepFun ra mắt mô hình flagship Step 5 Preview, mở quyền truy cập trọng số từ 15/10

Introducing Step 5 Preview: Advancing the Pareto Frontier. Step 5 Preview is our new flagship model…

DịchStepFun giới thiệu mô hình MoE Step 5 Preview với 600B tham số, tối ưu cho tác vụ đại lý (agent) trong lĩnh vực tài chính và kỹ thuật phần mềm, hỗ trợ cửa sổ ngữ cảnh 1M và khả năng xử lý hình ảnh.

Cùng sự kiện, tinh chọn hiển thị «Step 5 Preview: Bước tiến mới từ StepFun với mô hình mã nguồn mở 600B tham số»
Pandaily
Mô hìnhĐiểm AI 92/100

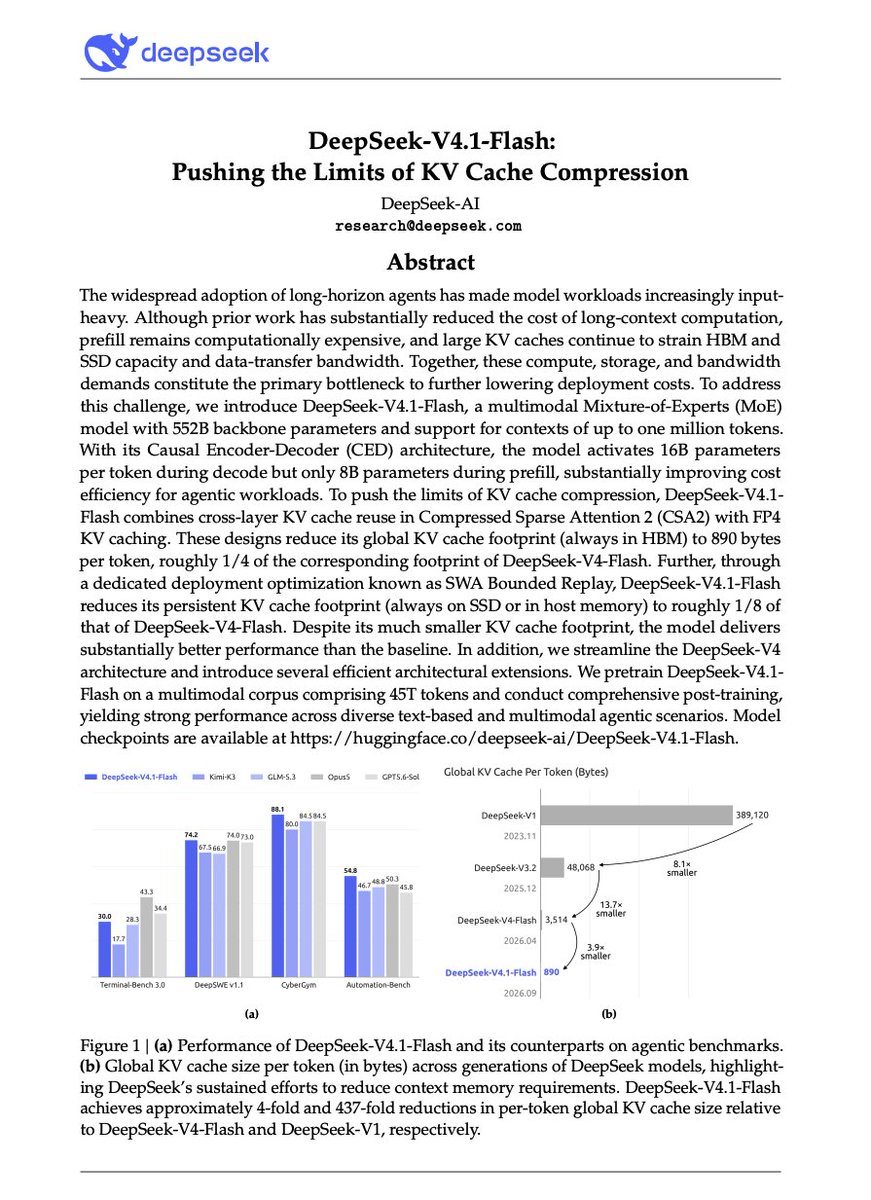
Tinh chọnDeepSeek-V4.1-Flash ra mắt: Mô hình MoE 552B, cửa sổ ngữ cảnh 1 triệu token và nén KV siêu cấp

DeepSeek-V4.1-Flash là mô hình MoE Encoder-Decoder 552 tỷ tham số, hỗ trợ cửa sổ ngữ cảnh 1 triệu token cùng công nghệ nén KV cực mạnh, hiện đã có mặt trên API dưới tên deepseek-flash.


Vì sao đáng đọc: Đây là bước tiến lớn về kỹ thuật tối ưu hóa bộ nhớ và ngữ cảnh cho các mô hình ngôn ngữ quy mô lớn, thu hút sự quan tâm cao từ cộng đồng AI.
WeChat: StepFun (Step)
Mô hìnhĐiểm AI 66/100

Tinh chọnStep 5 Preview: Bước tiến mới từ StepFun với mô hình mã nguồn mở 600B tham số

StepFun vừa ra mắt mô hình flagship Step 5 Preview sử dụng kiến trúc MoE, hỗ trợ cửa sổ ngữ cảnh 1 triệu token và khả năng xử lý đa phương thức. Với hiệu suất vượt trội và chi phí vận hành chỉ bằng 1/8 so với Claude 3 Opus, đây là đối thủ đáng gờm trong nhóm mô hình mã nguồn mở.

Diễn biến sự kiện · 10 bài →Thêm 11 nguồn khác đưa tinX: StepFun (@StepFun_ai)X: Artificial Analysis (@ArtificialAnlys)X: Elvis Saravia (@omarsar0, DAIR.AI)MarkTechPostX: Hongming (@hongming731)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Testing Catalog (@testingcatalog)IT HomeWeChat: Carl AI WattsQbitAIPandaily

Vì sao đáng đọc: Đây là tin tức quan trọng về một mô hình mã nguồn mở hiệu năng cao từ Trung Quốc, có tác động trực tiếp đến cộng đồng phát triển AI nhờ sự cân bằng giữa chi phí và sức mạnh.

19/09

Thứ Bảy · 1 tin

18/09

Thứ Sáu · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Mô hìnhĐiểm AI 85/100

Tinh chọnDeepSeek-V4.1-Flash ra mắt: Mô hình MoE 552B đa phương thức với công nghệ nén KV cache đột phá

DeepSeek vừa trình làng DeepSeek-V4.1-Flash, mô hình MoE đa phương thức 552 tỷ tham số hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token, hiện đã có sẵn trên Hugging Face.

Diễn biến sự kiện · 5 bài →Thêm 1 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)

Vì sao đáng đọc: Đây là bước tiến lớn về hiệu năng của DeepSeek với khả năng xử lý ngữ cảnh cực dài và tối ưu hóa bộ nhớ, thu hút sự quan tâm lớn từ cộng đồng AI.

17/09

Thứ Năm · 2 tin

16/09

Thứ Tư · 3 tin
Pandaily
Mô hìnhĐiểm AI 88/100

Tinh chọnShanghai AI Lab ra mắt Atria Dawn Preview: Mô hình tác tử MoE 744 tỷ tham số

Shanghai AI Lab vừa công bố Atria Dawn Preview, mô hình tác tử MoE 744 tỷ tham số dựa trên GLM-5.2 với cửa sổ ngữ cảnh 256K, đạt điểm số ấn tượng 53.8 trên AutomationBench cho các tác vụ nghiên cứu và kỹ thuật phức tạp.


Vì sao đáng đọc: Đây là bước tiến lớn trong lĩnh vực mô hình tác tử (agentic model) với quy mô tham số khổng lồ và hiệu suất vượt trội trong các tác vụ tự động hóa dài hạn.
NVIDIA Technical Blog: Agentic AI / Generative AI
Hướng dẫnĐiểm AI 52/100

NVIDIA giải mã: So sánh mô hình Dense và MoE về tham số kích hoạt, hiệu suất và cách lựa chọn

Blog kỹ thuật của NVIDIA phân tích sự khác biệt giữa kiến trúc Dense và MoE. Điểm nhấn là cơ chế định tuyến của MoE giúp tối ưu hóa hiệu suất, ví dụ như mô hình Nemotron 3.5 Lightning 30B chỉ kích hoạt 3B tham số cho mỗi token.

15/09

Thứ Ba · 4 tin

14/09

Thứ Hai · 1 tin
Ma Dongxi NLP@dongxi_nlp
Mô hìnhĐiểm AI 58/100

Cùng sự kiệnDeepSeek ra mắt DeepSeek-V4.1-Flash: Đột phá kiến trúc CED tối ưu bộ nhớ KV cache

DeepSeek-V4.1-Flash là mô hình MoE đa phương thức 552B tham số, sử dụng kiến trúc CED và kỹ thuật FP4 giúp giảm dung lượng KV cache xuống mức cực thấp, hỗ trợ ngữ cảnh lên tới 1 triệu token với hiệu suất vượt trội.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»

11/09

Thứ Sáu · 2 tin

10/09

Thứ Năm · 8 tin
SiliconFlow@SiliconFlowAI
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnDeepSeek-V4.1-Flash cập bến SiliconFlow: Mô hình MoE 552B với cửa sổ ngữ cảnh 1 triệu token

@deepseek_ai just made Flash the new Pro. 🤯 DeepSeek-V4.1-Flash is live on SiliconFlow - Day 0. 55…

DịchSiliconFlow vừa ra mắt DeepSeek-V4.1-Flash, mô hình MoE 552B hỗ trợ thị giác nguyên bản, cửa sổ ngữ cảnh 1 triệu token và tối ưu hóa bộ nhớ đệm KV hiệu quả hơn gấp 4 lần.

Cùng sự kiện, bài đại diện «DeepSeek hủy bỏ kế hoạch khai tử API V4 Pro, tiếp tục duy trì dịch vụ»
JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnDeepSeek V4.1 Flash chính thức ra mắt: Tối ưu hóa hiệu suất với kiến trúc MoE mới

DeepSeek V4.1 Flash sở hữu 552B tham số với kiến trúc Causal-Encoder-Decoder đột phá, giúp tăng tốc độ phản hồi và giảm chi phí suy luận đáng kể trong khi vẫn duy trì hiệu năng vượt trội ở các tác vụ lập trình và tác tử AI.


Vì sao đáng đọc: Đây là bản cập nhật quan trọng từ một đơn vị dẫn đầu thị trường, mang tính ứng dụng cao cho cộng đồng lập trình và phát triển AI.
Kim@kimmonismus
Mô hìnhĐiểm AI 79/100

Cùng sự kiệnDeepSeek ra mắt V4.1-Flash: Kiến trúc Causal Encoder-Decoder mới với khả năng hiểu thị giác

DeepSeek just released V4.1-Flash with a new architecture, six weeks after its July V4-Flash update….

DịchDeepSeek giới thiệu V4.1-Flash, mô hình MoE 552B tham số tối ưu hóa hiệu suất với kiến trúc mới, giúp giảm đáng kể yêu cầu bộ nhớ KV cache và chi phí API trong khi vẫn hỗ trợ xử lý hình ảnh trực tiếp.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
MarkTechPost
Mô hìnhĐiểm AI 87/100

Tinh chọnDeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh

DeepSeek-V4.1-Flash là mô hình MoE đa phương thức mới với 748B tham số, nổi bật nhờ khả năng xử lý 1 triệu token và giảm dung lượng KV Cache xuống chỉ còn 890 byte mỗi token, tối ưu hiệu suất vượt trội so với các thế hệ trước.

Diễn biến sự kiện · 32 bài →Thêm 27 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: AI Notes (@AYi_AInotes)X: Alibaba Cloud (@alibaba_cloud)X: Ma Dongxi NLP (@dongxi_nlp)Fireworks AI (Web)X: Hongming (@hongming731)Latent SpaceX: SemiAnalysis (@SemiAnalysis_)Baseten Blog kỹ thuật (Web)X: OpenRouter (@OpenRouter)WeChat: Carl AI WattsX: Artificial Analysis (@ArtificialAnlys)X: Yuchen Jin (@Yuchenj_UW)X: Tencent WorkBuddy (@WorkBuddy_AI)The Decoder: AI NewsIT HomeX: Thomas Wolf (Hugging Face đồng sáng lập/CSO) (@Thom_Wolf)X: X.PIN (@thexpin)X: Kim (@kimmonismus)X: Testing Catalog (@testingcatalog)X: Elvis Saravia (@omarsar0, DAIR.AI)X: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)TechNodePandailyX: DeepSeek (@deepseek_ai)X: opencode (@opencode)X: Tianyi Cui (@tianyi)

Vì sao đáng đọc: Đây là bước tiến lớn về kỹ thuật tối ưu hóa bộ nhớ và hiệu suất suy luận cho mô hình ngôn ngữ lớn, thông tin cực kỳ quan trọng với cộng đồng AI.
Testing Catalog@testingcatalog
Mô hìnhĐiểm AI 75/100

Cùng sự kiệnDeepSeek-V4.1-Flash trình làng: Mô hình MoE 552 tỷ tham số với kiến trúc đột phá

DeepSeek V4.1 Flash is now available on Huggingface! > 552B parameters MoE model with a new Encode…

DịchDeepSeek vừa ra mắt DeepSeek-V4.1-Flash trên Hugging Face. Đây là mô hình MoE 552 tỷ tham số, ứng dụng kiến trúc Encoder-Decoder mới cùng phương pháp huấn luyện tăng cường quy mô lớn.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
WeChat: DeepSeek
Mô hìnhĐiểm AI 85/100

Cùng sự kiệnDeepSeek ra mắt V4.1 Flash: Mô hình đa phương thức 552B MoE, mã nguồn mở và giảm giá API

DeepSeek trình làng V4.1 Flash, mô hình MoE 552 tỷ tham số với cấu trúc Causal-Encoder-Decoder mới, hỗ trợ đa phương thức và vượt trội hơn cả bản Pro trong các bài kiểm tra hiệu năng.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt V4.1-Flash: Mô hình đa phương thức nhỏ gọn với giá API siêu rẻ»
Pandaily
Mô hìnhĐiểm AI 95/100

Tinh chọnAlibaba công bố Qwen3.8-2.4T-A95B: Mô hình MoE mạnh mẽ nhất từ trước đến nay

Alibaba vừa phát hành mã nguồn mở cho Qwen3.8-2.4T-A95B, mô hình MoE với 2,4 nghìn tỷ tham số. Với khả năng xử lý ngữ cảnh dài và tối ưu cho tác vụ đại lý (agentic), đây là bước tiến lớn trong hệ sinh thái mã nguồn mở.


Vì sao đáng đọc: Đây là cột mốc quan trọng khi một mô hình đẳng cấp 'Max' được mở mã nguồn, mang lại sức mạnh tính toán khổng lồ cho cộng đồng phát triển AI.

07/09

Thứ Hai · 2 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (62 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “MoE” | AIHOT.vn