Mô hình
Jina AI ra mắt jina-ocr-v1: Mô hình MoE 3.4B tối ưu cho GPU phổ thông
(giờ Việt Nam)
Tóm tắt AI
Jina AI giới thiệu mô hình OCR 3.4B sử dụng kiến trúc MoE, cho phép chuyển đổi tài liệu phức tạp như PDF, hóa đơn sang Markdown với hiệu suất cao trên các thiết bị có cấu hình thấp.
Bản dịch AI
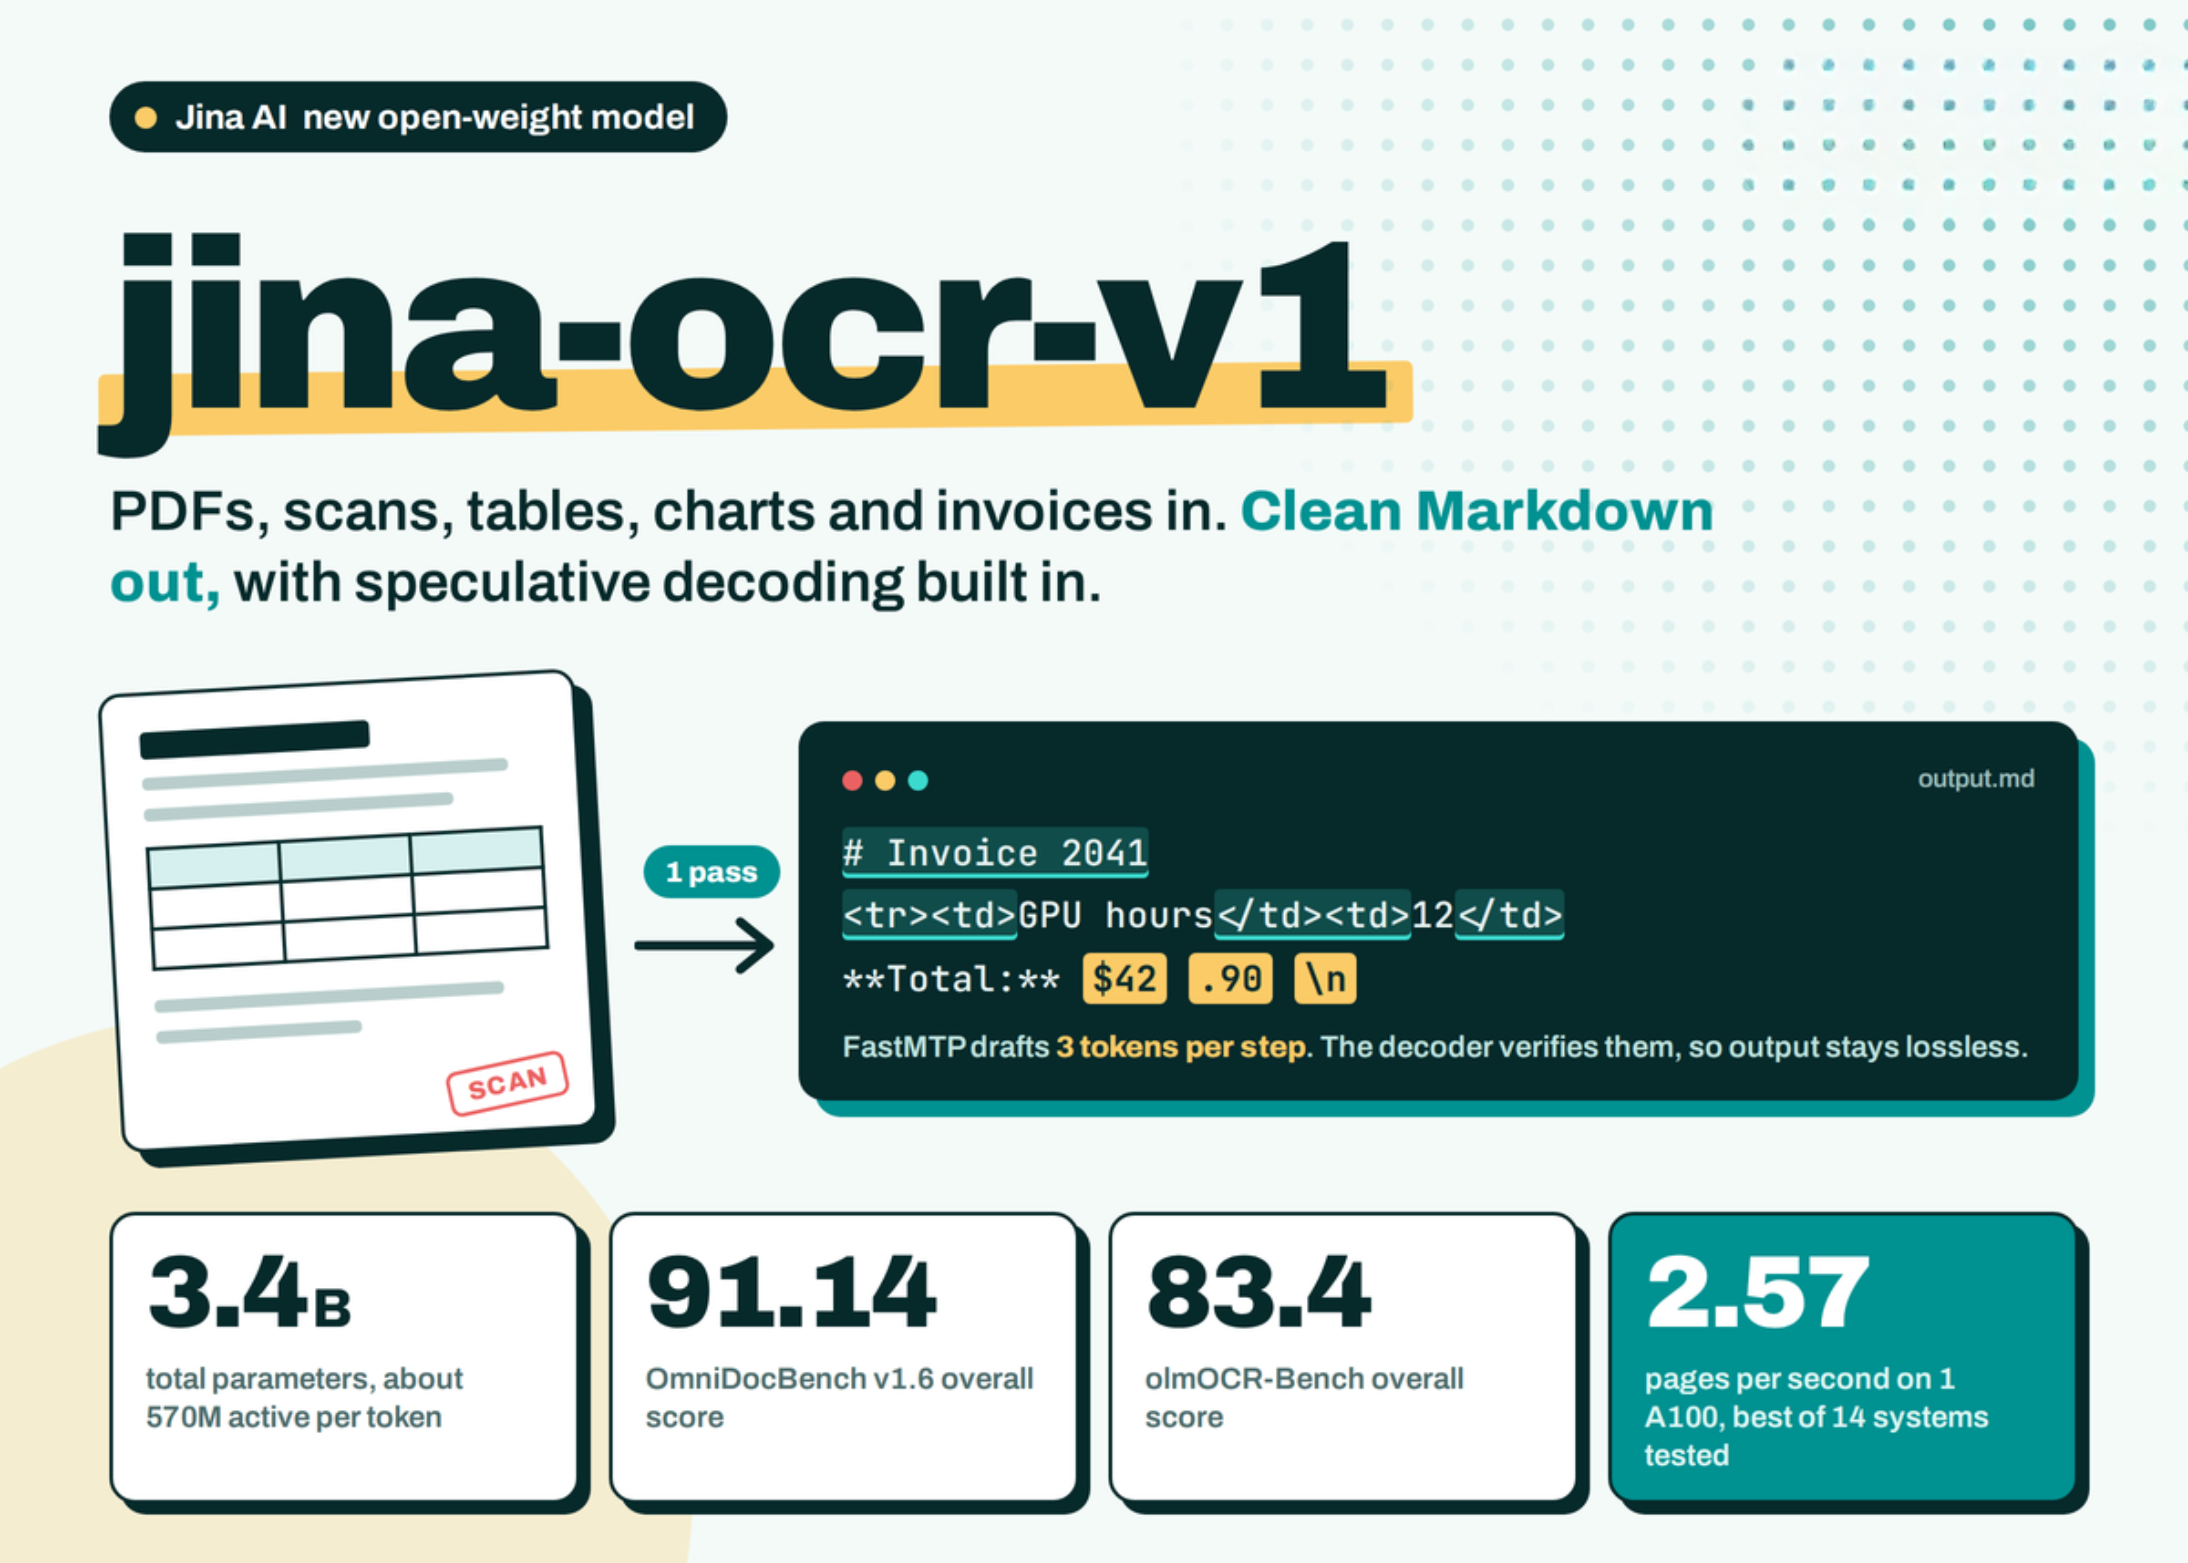
Jina AI, một thành viên của Elastic, vừa phát hành jina-ocr-v1, một trình phân tích tài liệu trực quan end-to-end. Mô hình này xử lý các tệp PDF, bản quét, bảng biểu, biểu đồ hoặc hóa đơn và trả về kết quả định dạng Markdown sạch sẽ chỉ trong 1 lần chạy. Mô hình có tổng cộng 3,4 tỷ tham số, với khoảng 570 triệu tham số bộ giải mã (decoder) hoạt động trên mỗi token. Một đầu giải mã suy đoán (speculative decoding head) được tích hợp sẵn bên trong checkpoint. Jina AI xây dựng mô hình này để phục vụ trên các GPU ngân sách thấp như NVIDIA L4. Báo cáo kỹ thuật ghi nhận mô hình đạt 91,14 điểm trên OmniDocBench v1.6 và 83,4 điểm trên olmOCR-Bench.
Mô hình có thể triển khai được không? Có, dành cho mục đích nghiên cứu và phi thương mại. Các trọng số mở có dung lượng khoảng 6,8 GB ở định dạng BF16 và chạy trên Transformers hoặc vLLM. Giấy phép CC BY-NC 4.0 đồng nghĩa với việc sử dụng thương mại cần phải liên hệ với Jina AI.
jina-ocr-v1 là gì?
Mô hình này được huấn luyện hậu kỳ (post-train) từ DeepSeek-OCR và giữ lại 2 thành phần hiệu suất của nó. DeepEncoder có khoảng 380 triệu tham số và kết hợp SAM, bộ nén tích chập 16x và CLIP-L. Nó chuyển đổi một trang tài liệu 1024×1024 từ 4.096 bản vá (patches) thành 256 token hình ảnh. Chế độ phân giải động bổ sung tối đa 9 ô cục bộ với 100 token mỗi ô. Điều đó giới hạn một trang ở mức 1.156 token hình ảnh.
Bộ giải mã là DeepSeek-3B-MoE với 12 lớp, 64 chuyên gia định tuyến (routed experts) và 2 chuyên gia dùng chung (shared experts). Cơ chế định tuyến Top-6 kích hoạt khoảng 570 triệu tham số trên mỗi token. Giới hạn vị trí là 32.768. Đầu ra là Markdown, với bảng biểu ở định dạng HTML và công thức ở định dạng LaTeX.
Cách thức hoạt động của FastMTP Speculative Decoding
Đầu ra OCR gần như mang tính xác định và có cấu trúc cục bộ. Điều đó làm cho nó trở nên phù hợp với giải mã suy đoán. Jina AI bổ sung một đầu FastMTP: 1 khối dự đoán dày (dense draft block) được áp dụng đệ quy cho K=3 bước. Các tham số dự đoán giữ nguyên khi độ sâu tăng lên.
Sau đó, bộ giải mã xác minh các bản dự đoán theo phương pháp tham lam (greedy). Nó chấp nhận tiền tố dài nhất khớp với các lựa chọn của chính nó và tự cam kết thêm 1 token nữa. Nếu cả 3 bản dự đoán đều khớp, token bổ sung đó là một phần thưởng. Văn bản được cam kết luôn tương đương với giải mã tham lam thông thường, vì vậy việc tăng tốc là không mất mát dữ liệu (lossless). Tại K=3, mô hình cam kết trung bình 2,73 token mỗi bước.
Huấn luyện hậu kỳ với các phần thưởng xác minh dày (Dense Verifiable Rewards)
Quá trình huấn luyện hậu kỳ kết hợp giữa căn chỉnh hướng dẫn (instruction alignment), tinh chỉnh độ bền vững trên các trang bị lỗi và GRPO. Mỗi thuật ngữ phần thưởng là mã xác định được chấm điểm dựa trên bản phiên mã tham chiếu. Các thuật ngữ bao gồm nội dung, công thức, bảng biểu, tính hợp lệ của cấu trúc, kiểm thử đơn vị (unit tests), sự lặp lại và định dạng.
Các thuật ngữ được nhân với nhau và mỗi thuật ngữ đều được chấm điểm, vì vậy các trang đúng một phần sẽ nhận được điểm một phần. Các thuật ngữ về cấu trúc, kiểm thử đơn vị và định dạng được đặt mức sàn là 0,2, và thuật ngữ bảng biểu là 0,1. Thuật ngữ lặp lại không có mức sàn, vì các vòng lặp có thể làm tăng điểm nội dung.
Trên các trang tự nhiên, phần thưởng cho công thức và bảng biểu chỉ áp dụng cho một vài mẫu. Do đó, Jina AI đã xây dựng JinaOCRSynth, các trang tổng hợp chứa cả hai yếu tố trên, mỗi trang đều đi kèm với các bài kiểm thử đơn vị theo phong cách olmOCR-Bench. Một tác nhân cũng hợp nhất các checkpoint ứng viên trong ngân sách đánh giá cố định. Đầu dự đoán được huấn luyện cuối cùng, dựa trên bộ xác minh cuối cùng đã đóng băng.
Điểm chuẩn và Thông lượng
Đối với các mô hình MoE, các tham số hiển thị tổng số bộ giải mã và số lượng hoạt động. Toàn bộ mô hình jina-ocr-v1 có khoảng 3,4 tỷ tham số.
Mô hình không dẫn đầu về độ chính xác. PaddleOCR-VL-1.6 và HunyuanOCR-1.5 (94,74) đạt điểm cao hơn trên OmniDocBench. chandra-ocr-2 và dots.mocr (83,9) đạt điểm cao hơn trên olmOCR-Bench. Huấn luyện hậu kỳ giúp tăng 7,4 điểm so với nền tảng DeepSeek-OCR trên olmOCR-Bench.
Thông lượng là kết quả chính. Trên 1 card A100 40 GB với độ đồng thời 32, jina-ocr-v1 phân tích 2,57 trang mỗi giây. Đây là mức cao nhất trong số 14 hệ thống mà Jina AI đo lường, so với 1,22 của olmOCR-2 và 0,38 của chandra-ocr-2. Nó tạo ra 1.085 token đầu ra mỗi trang. Jina AI cho biết đây là đầu ra ngắn nhất trong số các hệ thống đạt điểm trên 83.
Trên NVIDIA L4 với kích thước batch là 1, giải mã eager tăng từ 42,7 lên 83,1 token mỗi giây. Đó là mức tăng tốc 1,95 lần với tỷ lệ chấp nhận 57,6%. Với CUDA graphs, mức cơ sở đã là 158,3 token mỗi giây. Ở đó, K=1 hoạt động tốt nhất ở mức 185,6 token mỗi giây, đạt mức tăng 1,17 lần.
Cách chạy mô hình
Cách nhanh nhất là sử dụng Jina Reader. Gửi URL đến r.jina.ai với tiêu đề X-Respond-With: jina-ocr-v1. Reader sẽ lấy trang hoặc PDF, chạy mô hình và trả về Markdown. Tiêu đề X-Page sẽ phiên mã 1 trang của một tài liệu dài hơn.
Jina AI cũng cung cấp một endpoint tương thích với OpenAI tại https://api.jina.ai/v1/chat/completions. Bản demo trực tuyến cũng có sẵn để kiểm tra nhanh.
Để tự lưu trữ, các trọng số và mã tùy chỉnh được cung cấp trong 1 kho lưu trữ và tải với trust_remote_code=True. FastMTP yêu cầu vLLM 0.21 trở lên và một lệnh gọi register một lần. Đường dẫn Transformers chỉ chạy bộ giải mã MoE và bỏ qua các trọng số dự đoán.
Những điểm chính cần lưu ý
Hãy xem qua Bài báo, Trọng số mô hình, Bài đăng phát hành, Trang mô hình và Thông báo. Mọi công lao đều thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit ML 150k+ của chúng tôi và Đăng ký Bản tin của chúng tôi. Khoan đã! bạn có dùng Telegram không? bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá GitHub Repo HOẶC Trang Hugging Face HOẶC Phát hành sản phẩm HOẶC Hội thảo trực tuyến, v.v.? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về tin tức học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào với hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với người xem.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.