Mô hình
PrismML ra mắt Ternary Bonsai 2 27B: Mô hình 3-giá trị siêu nhẹ, giữ 98,2% hiệu năng Qwen 27B
(giờ Việt Nam)
Tóm tắt AI
PrismML vừa phát hành Ternary Bonsai 2 27B, mô hình nén 3-giá trị chỉ nặng 5,93 GB nhưng vẫn duy trì 98,2% hiệu năng của bản gốc Qwen 27B, hỗ trợ đa phương thức và cửa sổ ngữ cảnh lên tới 262K token.
Bản dịch AI
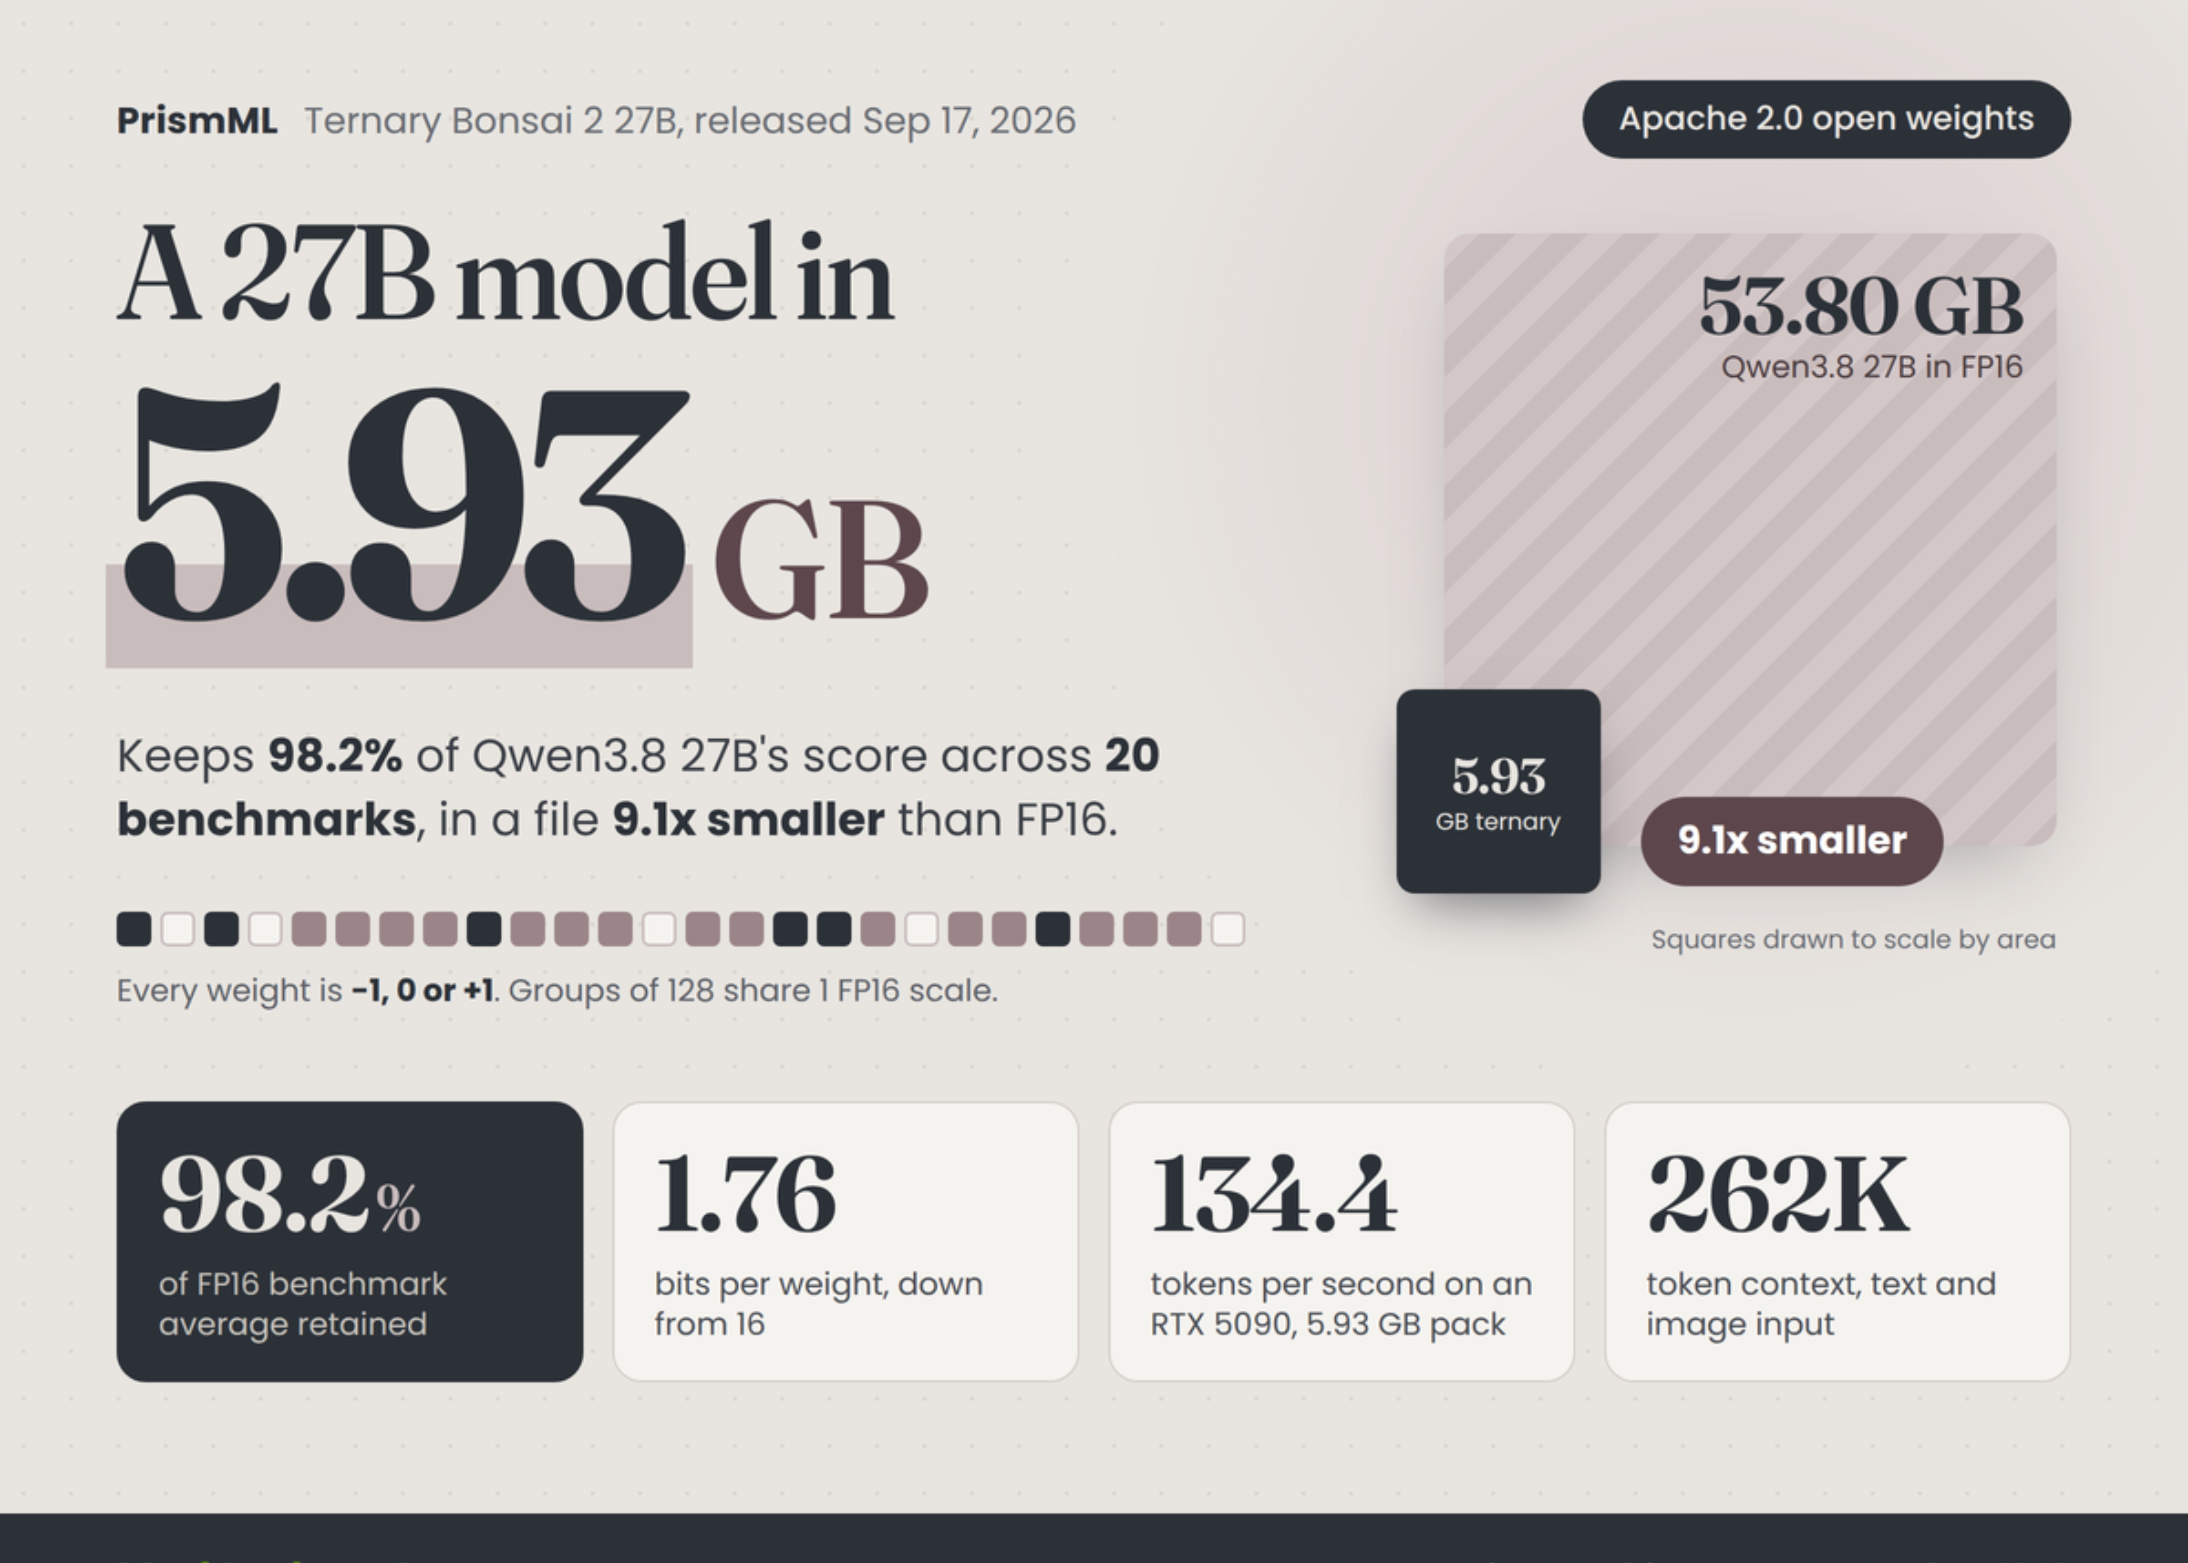
PrismML vừa phát hành Ternary Bonsai 2 27B, một phiên bản trọng số tam phân (ternary-weight) của Qwen3.8 27B. Mô hình ngôn ngữ này chiếm dung lượng 5,93 GB, so với 53,80 GB ở định dạng FP16. PrismML báo cáo rằng mô hình giữ lại 98,2% hiệu suất trung bình của mô hình gốc trên 20 bộ tiêu chuẩn đánh giá. Mô hình chấp nhận đầu vào là văn bản và hình ảnh, đồng thời hỗ trợ ngữ cảnh 262K token. PrismML đã trình diễn khả năng điều khiển các tác nhân lập trình Cline và sử dụng máy tính trên card đồ họa RTX 5090. Sản phẩm này ra mắt 2 tháng sau phiên bản Bonsai 27B đầu tiên, vốn có biến thể tam phân giữ lại khoảng 95% hiệu suất.
Liệu mô hình có thể triển khai được không? Có. Các trọng số Apache 2.0 hiện có thể chạy trên máy tính xách tay 16 GB hoặc một GPU đơn lẻ 24 GB. Bạn cần sử dụng bản fork llama.cpp của PrismML hoặc runtime MLX của họ.
Ternary Bonsai 2 27B là gì?
Mô hình giữ nguyên kiến trúc của Qwen3.8 27B. Nó có 27,36 tỷ tham số, được chia thành 24,35 tỷ tham số cho phần lõi ngôn ngữ, 2,54 tỷ cho phần nhúng (embeddings) và LM head, cùng 0,47 tỷ cho phần xử lý hình ảnh (vision tower). Phần lõi sử dụng cơ chế chú ý hỗn hợp (hybrid attention), với khoảng 75% là các lớp linear-attention và 25% là các lớp full-attention.
Các trọng số tam phân bao phủ phần nhúng, các phép chiếu chú ý (attention projections), các phép chiếu MLP và LM head. Chỉ có 26,2 triệu tham số, tương đương 0,0976%, được giữ ở độ chính xác cao hơn. Đó là các trọng số của đường dẫn trạng thái tái phát (recurrent state path) và chuẩn hóa (normalization). Trong định dạng GGUF, phần vision tower được đóng gói riêng thành một tệp 0,63 GB, chỉ được tải khi có đầu vào là hình ảnh.
Định dạng tam phân hoạt động như thế nào?
Mỗi trọng số nhận 1 trong 3 giá trị: -1, 0 hoặc +1. Mỗi nhóm 128 trọng số chia sẻ chung 1 thang đo FP16. Một giá trị tam phân mang log2(3), hay khoảng 1,585 bit. Việc thêm 16 bit thang đo cho mỗi 128 trọng số giúp đạt mức 1,71 bit trên mỗi trọng số. Tính cả các tensor độ chính xác cao, mô hình đạt mức 1,72 bit.
Các kernel thực tế cần một bố cục đóng gói, vì vậy tài liệu kỹ thuật mô tả 2 cách đóng gói GGUF. PTQ1_0 đóng gói các trit một cách dày đặc với 1,76 bit mỗi trọng số và dung lượng 5,93 GB. PQ2_0 lưu trữ mỗi trit trong một khe 2-bit với dung lượng 7,25 GB, giúp việc giải nén tốn ít chi phí hơn.
Các trọng số cũng được lưu trữ trong một cơ sở xoay (rotated basis). PrismML áp dụng phép xoay Hadamard theo khối với kích thước khối 1.024 trước khi gán giá trị tam phân. Runtime áp dụng phép biến đổi tương ứng cho các kích hoạt (activations) trước mỗi phép nhân. Tài liệu kỹ thuật trích dẫn SpinQuant cho ý tưởng này. PrismML không công bố cách họ gán các giá trị tam phân.
Mô hình đạt điểm số thế nào so với Qwen3.8 27B?
PrismML đã đánh giá tất cả các mô hình ở chế độ tư duy (thinking mode) với EvalScope và vLLM trên các GPU H100.
Sự so sánh với phương pháp lượng tử hóa thông thường cho thấy kết quả rõ rệt hơn. Một bản dựng IQ2_XXS của Qwen3.8 27B đạt trung bình 75,2 điểm ở mức 7,3 GB. Trên bộ tiêu chuẩn AIME26, nó đạt 78,6 điểm, trong khi Bonsai 2 đạt 95,83. Trên LiveCodeBench v6, khoảng cách là 70,05 so với 90,07.
Mô hình vẫn bị giảm chất lượng ở đâu?
Con số 98,2% là mức trung bình, và sự sụt giảm không đồng đều. Khả năng xử lý hình ảnh giữ lại 96,3%, trong khi kiến thức và suy luận giữ lại 96,9%.
Hiệu suất của các tác nhân làm việc dài hạn (long-horizon agent) giảm mạnh hơn. Bonsai 2 đạt 52,8 điểm trên Terminal-Bench 2.1, so với 69,7 của Qwen3.8 27B. Trên SWE-bench Verified, nó đạt 60,8 so với 80,6. Đó là mức giữ lại khoảng 75%, và cả hai đều nằm ngoài mức trung bình của 20 bộ tiêu chuẩn.
Nỗ lực suy luận cũng rất quan trọng. Ở mức nỗ lực trung bình, mô hình đạt trung bình 79,3 điểm, so với 82,6 của mô hình gốc FP16. Mức nỗ lực thấp không được hỗ trợ. Tất cả kết quả đều do PrismML tự thực hiện và chưa được kiểm chứng độc lập.
Tốc độ của mô hình trên phần cứng thực tế là bao nhiêu?
Các số liệu dựa trên giải mã batch size 1 trên các kernel tùy chỉnh của PrismML, đo lường vào ngày 16 tháng 9 năm 2026. Một card RTX 5090 đạt 142,5 token mỗi giây với mức tiêu thụ 0,582 mWh mỗi token. RTX 4090 đạt 96,7 với PTQ1_0, và card L4 72W đạt 32,1. Trên máy tính Apple, chip M5 Max đạt 46,8 và M5 Pro đạt 27,7.
Không có phương pháp đóng gói nào thắng thế trong mọi trường hợp. PTQ1_0 nhanh hơn trên các card kiến trúc Ada và L4. PQ2_0 nhanh hơn trên các kiến trúc Blackwell, Hopper, Ampere, Apple silicon và trong quá trình xử lý prompt ở mọi nơi.
Nhóm nghiên cứu PrismML cũng tuyên bố hiệu suất năng lượng tốt hơn 40% so với mô hình 8B độ chính xác đầy đủ.
Làm thế nào để chạy mô hình?
Các tệp GGUF cần bản fork llama.cpp của PrismML. Bản llama.cpp gốc không hỗ trợ các loại PTQ1_0 và PQ2_0. Kho lưu trữ Bonsai-demo là con đường được hỗ trợ chính thức. Hãy chạy./setup.sh, sau đó chạy./scripts/start_llama_server.sh để sử dụng tính năng trò chuyện, hình ảnh và công cụ tại localhost:8080.
Người dùng Mac có thể sử dụng gói MLX, vốn cần trình tải đi kèm của nó. Một bản demo WebGPU cho phép chạy mô hình ngay trong trình duyệt.
Những điểm chính cần lưu ý
Hãy xem qua Tài liệu kỹ thuật (Whitepaper), Trọng số mô hình, kho lưu trữ GitHub, Tài liệu hướng dẫn, bản demo WebGPU và thông báo trên X. Mọi công lao thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter, đừng quên tham gia SubReddit ML với hơn 150 nghìn thành viên và đăng ký nhận Bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá kho lưu trữ GitHub, Trang Hugging Face, Phát hành sản phẩm hoặc Hội thảo trực tuyến, v.v.? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo công chúng. Nền tảng này tự hào với hơn 2 triệu lượt xem mỗi tháng, minh chứng cho sự phổ biến của nó đối với độc giả.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.