Tin ngành
Giải mã quy trình suy luận mô hình MoE: Phân tích 4 giai đoạn từ Prefill đến Decode
(giờ Việt Nam)
Tóm tắt AI
Bài phân tích chuyên sâu từ SemiAnalysis chia quy trình suy luận của mô hình MoE thành 4 giai đoạn, làm rõ sự khác biệt về nhu cầu tính toán, bộ nhớ và băng thông mạng.
Bản dịch AI
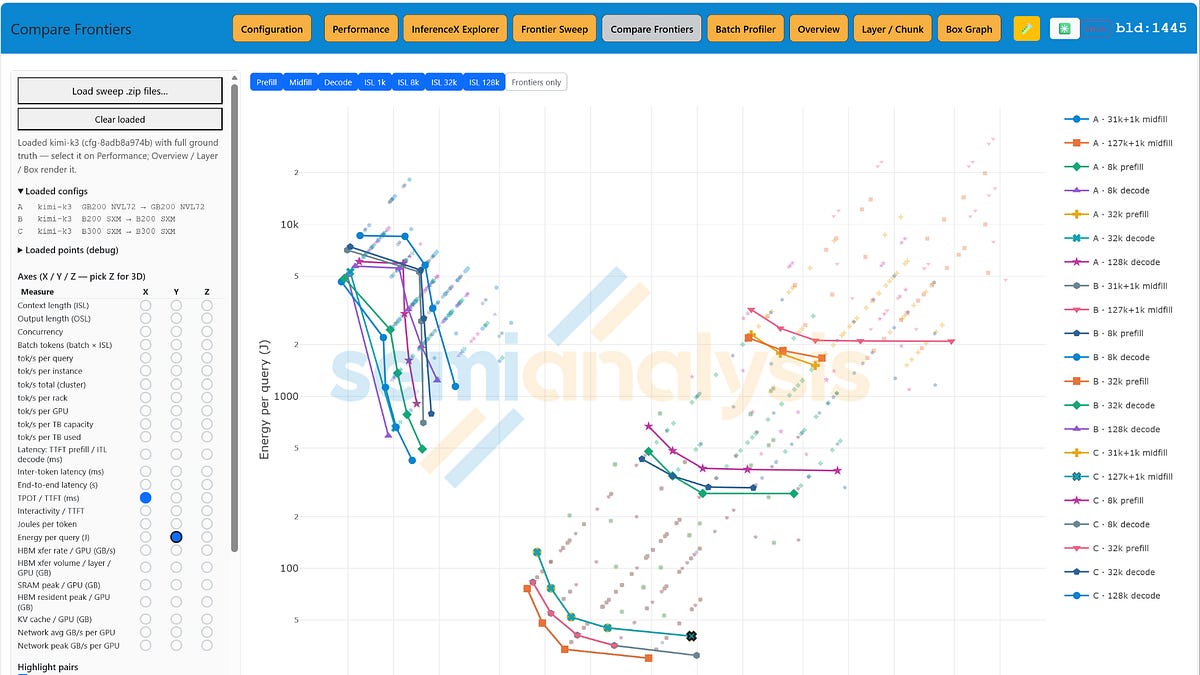
Mixture of Experts (MoE), hiện được sử dụng rộng rãi trong các mô hình tiên tiến, đã thay đổi cả cấu trúc phục vụ lẫn khía cạnh kinh tế của việc suy luận (inference) hiệu quả. Nó không chỉ đơn thuần làm tăng số lượng tham số. Nó thay đổi những tensor nào được kích hoạt cho mỗi token, những dữ liệu nào cần phải đặt gần nhau, những quá trình truyền tải nào cần băng thông cục bộ mạnh, những quá trình nào có thể chịu được kết nối mạng yếu hơn, và cách thức di chuyển bộ nhớ, lưu trữ cũng như lập lịch góp phần tạo nên thông lượng hữu ích.
Nơi tốt nhất để bắt đầu là toàn bộ dịch vụ. Quá trình suy luận diễn ra bên trong một cụm (cluster) được điều phối bởi một lớp điều phối (orchestration layer) như NVIDIA Dynamo, Mooncake hoặc một bộ lập lịch tùy chỉnh. Các thành phần này hoạt động chặt chẽ với các máy chủ suy luận như vLLM hoặc SQlang, và bản thân chúng cũng có các tính năng điều phối riêng. Bài viết này sẽ không đi sâu vào chi tiết cách bạn làm việc với phần mềm điều phối hay bạn nên chọn loại nào. Bài viết nhằm mục đích cung cấp cái nhìn tổng quan về quy trình và lý do cho các tính năng khác nhau mà bạn có thể sử dụng.
Một người dùng (hoặc tác nhân của họ) bắt đầu một cuộc hội thoại bằng một yêu cầu (query), và cuộc hội thoại có thể tiếp tục sau khi nhận được câu trả lời với nhiều yêu cầu hơn. Mỗi cặp yêu cầu - câu trả lời là một "lượt" (turn). Trong các hệ thống AI hiện đại, người dùng thường chạy trong một ứng dụng khách (dù là giao diện đồ họa GUI hay dòng lệnh) và một số câu trả lời từ AI được ứng dụng đó chặn lại như các chỉ dẫn để thực thi, chẳng hạn như chỉnh sửa mã nguồn của bạn hoặc tìm kiếm các hướng dẫn của công ty về một câu hỏi nhân sự.
Hệ thống AI cũng có thể tự thực hiện một số việc đó từ trung tâm dữ liệu của nó, ví dụ như tìm kiếm trên web. Kết quả từ các hành động của công cụ chặn này cũng được trả về cho AI dưới dạng các yêu cầu, tạo ra nhiều lượt hơn. Máy chủ duy trì một ngữ cảnh (thường được gọi là KV cache hoặc chỉ đơn giản là cache), đây là phần chắt lọc của phiên làm việc, cho phép mỗi yêu cầu mới, từ người dùng hoặc từ công cụ, được diễn giải chính xác để đạt được tiến trình tổng thể. Có thể có hàng ngàn lượt mỗi giờ khi người dùng khởi chạy một tác nhân cho một tác vụ chạy dài hạn. Cuộc hội thoại cũng có thể tạm dừng và tiếp tục sau vài giờ hoặc thậm chí vài ngày.
Khi một yêu cầu đến các máy chủ suy luận, bộ điều phối sẽ đưa nó vào một hàng đợi, hàng đợi này sẽ chuyển tiếp đến một worker nạp đầu vào (input-fill worker), cùng với bất kỳ ngữ cảnh nào từ các lời nhắc hệ thống (system prompts) và các lượt trước đó trong cuộc hội thoại. Truy vấn sau đó được chuyển đổi thành ngữ cảnh mới được thêm vào cuộc hội thoại. Trạng thái ngữ cảnh mới đó sau đó được chuyển đến một worker giải mã (decode worker). Quá trình giải mã liên tục đọc trạng thái đã tích lũy, tạo ra các token trả lời, và các token trả lời đó cũng được thêm vào trạng thái cuộc hội thoại. Quá trình này có thể lặp lại thông qua các công cụ, tác nhân, người dùng và các công việc nạp đầu vào tiếp theo. Một worker mô hình chạy trên GPU chỉ là một phần của "nhà máy tạo token" này; lưu trữ, mạng và điều phối kết nối các giai đoạn của nó.
Bên trong các worker, có bốn chế độ vận hành đáng chú ý ngay từ đầu:
Prefill (nạp trước), nơi khối token mới ban đầu được xử lý cùng nhau.
Midfill (nạp giữa), nơi một yêu cầu tiếp nối được thêm vào một ngữ cảnh đã được lưu trong cache.
Decode attention (giải mã chú ý), nơi ngữ cảnh được sử dụng để tạo ra các thành phần cơ bản của các token mới được tạo.
Decode experts (giải mã chuyên gia), nơi mỗi token cơ bản mới được tinh chỉnh bởi một lựa chọn các chuyên gia từ một tập hợp lớn các chuyên gia khả thi.
Các chế độ này đặt ra những yêu cầu khác nhau về tính toán, bộ nhớ và mạng. Prefill và midfill có liên quan chặt chẽ với nhau, trong đó Prefill là một dạng Midfill với ngữ cảnh trước đó bằng không. Tuy nhiên, Prefill là một trường hợp đặc biệt phổ biến, tương ứng với các truy vấn một lần như cách dùng "chatbot" cổ điển, và có thể được tối ưu hóa khác một chút so với Midfill. Prefill đạt cường độ tính toán cao (tỷ lệ giữa tính toán và di chuyển dữ liệu) và không cần chờ đợi ngữ cảnh được định vị và đọc. Midfill bắt đầu từ một KV cache hiện có cho trạng thái trước đó và thêm vào một chuỗi đầu vào yêu cầu mới. Điều này thường có cường độ tính toán vừa phải hơn so với prefill vì có ít token mới hơn và nhiều dữ liệu hiện có cần di chuyển hơn cho mỗi token.
Decode attention và decode expert thường có cường độ tính toán thấp vì có ít token mới so với ngữ cảnh trước đó hoặc trọng số chuyên gia, vốn là dữ liệu cần được di chuyển ở trạng thái giải mã. Trong khi đó, trên tất cả các chế độ này, các tensor cho attention và cho experts là như nhau bất kể giá trị token, vì vậy có lợi ích khi chia sẻ một lần đọc tensor cho càng nhiều token càng tốt, ngay cả những token đến từ các yêu cầu không liên quan của những người dùng khác chỉ đơn giản là đang chạy cùng lúc và được kết nối mạng đủ gần để chia sẻ. Coi cả bốn chế độ là cùng một khối lượng công việc sẽ làm mất đi nhiều lợi thế cấu trúc mà các mô hình MoE mang lại về cường độ khác nhau và các mô hình chia sẻ khác nhau.
Trong tài liệu này, chúng tôi sẽ xử lý 4 giai đoạn một cách riêng biệt, và đôi khi giả định rằng chúng được phân tách (disaggregated). Có những sự đánh đổi giữa việc gộp (aggregated - nơi các mô hình nằm trên một máy chủ, máy chủ này cấu hình lại khi yêu cầu tiến triển giữa các giai đoạn) và phân tách (nơi bộ điều phối có thể tìm thấy một vị trí trống trên một máy khác đã được cấu hình phù hợp). Thông thường, chúng tôi sẽ nói về các giai đoạn như là phân tách, với việc gộp là một trường hợp đặc biệt của việc luôn làm cho nút hiện tại khả dụng khi giai đoạn trước kết thúc. Sẽ có một phần về các sự đánh đổi ở cuối, sau khi công việc cần thực hiện đã được giới thiệu đầy đủ hơn.
Một mô hình transformer là một chồng sâu các nhóm lớp lặp lại. Một nhóm có thể chứa một loại lớp, hoặc nó có thể chứa một lớp full-attention cùng với một vài lớp tuyến tính, cục bộ, chọn lọc hoặc các lớp attention được tối ưu hóa khác (đây là một nhóm lớp lai). Trong mỗi lớp, attention, các phép biến đổi chia sẻ, định tuyến, các chuyên gia được chọn và tái tổ hợp xảy ra theo trình tự. Các bước đó được biết trước và lặp lại liên tục, cho phép cùng một tài nguyên phần cứng phục vụ các phần khác nhau của luồng tại các thời điểm khác nhau.
Các máy móc cũng có thể được mô tả như các đơn vị lặp lại đơn giản tương đương. Một nút (node) là một nhóm các bộ tăng tốc (accelerator), thường là một khay trong tủ rack, mỗi bộ tăng tốc ghép nối tính toán với bộ nhớ nhanh cục bộ. Một nút được điều phối bởi một CPU và kết nối với các nút khác thông qua các NIC (bộ điều khiển giao diện mạng). Các nút xếp chồng thành các tủ rack. Một tủ rack có thể đóng vai trò là một miền mở rộng (scale-up domain) khi các tensor rất lớn được xử lý, hoặc một vài hòn đảo mở rộng nhỏ hơn, hoặc một tập hợp các giai đoạn đường ống (pipeline stages). Mạng trung tâm dữ liệu sau đó kết nối các worker bị giới hạn với lưu trữ và điều phối thay vì tham gia vào mọi phép toán tensor bên trong.
Bài luận này tuân theo tiến trình đó. Nó bắt đầu với dịch vụ toàn cầu và các chế độ vận hành, sau đó mở mô hình thành các lát cắt nhóm lớp rộng và ánh xạ chúng lên các nút bộ tăng tốc và tủ rack. Từ đó, nó phát triển tính song song đường ống, tensor và chuyên gia; giới hạn do bộ nhớ KV-cache áp đặt; giá trị khác nhau của việc batching trong prefill, midfill và decode; và vai trò của lập lịch trong một nhà máy tạo token nhiều tủ rack.
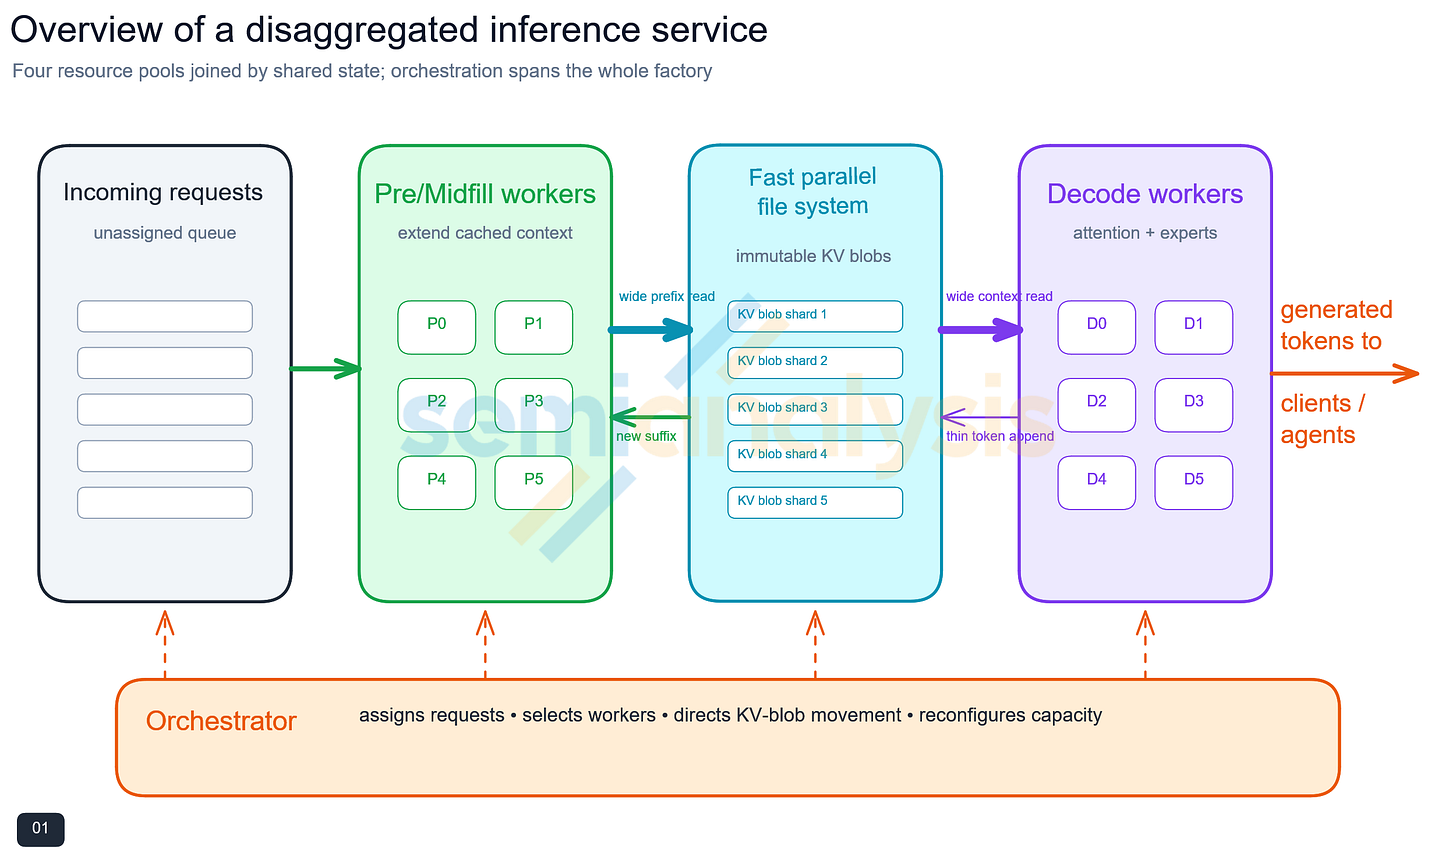
Một dịch vụ suy luận là một cụm nơi các yêu cầu trước đó và trạng thái bất biến được lưu trữ khi nhàn rỗi và sau đó được xếp hàng để chuyển đến các worker chuyên dụng khi một yêu cầu mới kéo theo ngữ cảnh hoặc một yêu cầu trước đó được đánh thức để tiếp tục. Hàng đợi đến chưa phải là một batch. Mỗi yêu cầu mang theo các token nhắc (prompt tokens), tham chiếu đến ngữ cảnh có thể tái sử dụng, mục tiêu dịch vụ, và thường là một cuộc hội thoại hoặc trạng thái tác nhân hiện có. Một bộ điều phối có thể đặt nó vào một batch prefill, midfill hoặc decode, và yêu cầu có thể tham gia hoặc rời khỏi batch đó một cách độc lập khi nó hoàn thành, làm cho công suất đó khả dụng cho công việc mới. Continuous batching (batching liên tục) hoạt động tốt nhất khi bộ lập lịch biết worker nào có các vị trí khớp với độ dài ngữ cảnh và mục tiêu dịch vụ của yêu cầu.
Các worker Prefill tạo ngữ cảnh từ một khối token mới đáng kể. Đầu ra của chúng là trạng thái KV mới cho mỗi lớp mô hình, được lưu trữ độc lập với worker đã tạo ra nó. Trạng thái KV di chuyển dọc theo các lớp mô hình, đầu ra của lớp K từ một lượt trở thành đầu vào cho lớp K trong lượt tiếp theo. Trong các máy chủ có đường ống, điều này tạo ra một sự "torrenting" tự nhiên của đầu ra và đầu vào từ các NIC riêng biệt.
Các worker Midfill mở rộng ngữ cảnh đã được xử lý trước đó. Tiền tố (prefix) được lưu trong cache có thể chứa các lời nhắc hệ thống và người dùng, bộ nhớ, các lượt hội thoại trước đó, các bước của tác nhân hoặc các tài liệu được truy xuất. Các gốc lớn có thể đã được lưu trong cache, trong khi đầu vào tăng dần có thể nhỏ hơn nhiều so với một yêu cầu không có cache tương đương: một ngữ cảnh nửa triệu token có thể chỉ nhận thêm vài trăm hoặc vài nghìn token mới.
Các worker Decode tiêu thụ ngữ cảnh đã được xử lý, tích lũy và tạo ra một hoặc một vài token (dự đoán đa token đang trở nên khá phổ biến) mỗi lượt. Mỗi token được tạo ra thêm một lượng nhỏ trạng thái mới. Cùng một ngữ cảnh sau đó có thể quay lại một worker midfill khi người dùng, công cụ hoặc tác nhân đóng góp thêm một khối đầu vào khác. Công việc tác nhân sử dụng các công cụ tạo ra một chuỗi lặp lại của việc mở rộng ngữ cảnh và tạo, không chỉ đơn thuần là một prefill theo sau bởi một decode.
Một worker có thể chiếm một nút, một khay hoặc một tủ rack. Dịch vụ trở nên lớn mạnh bằng cách vận hành nhiều worker bị giới hạn và di chuyển các yêu cầu và trạng thái giữa chúng. Tùy thuộc vào độ chính xác và yêu cầu trạng thái làm việc, ngay cả các mô hình có hàng nghìn tỷ tham số cũng có thể nằm gọn trong bộ nhớ tổng hợp của một hệ thống quy mô tủ rack hiện đại. Mạng trung tâm dữ liệu vẫn là thiết yếu vì nhà máy phải kết nối nhiều worker như vậy với lưu trữ chia sẻ và liên tục khớp các cấu hình worker với nhu cầu. Các lần chuyển KV có thể có kích thước hàng gigabyte, nhưng chúng có thể được phân mảnh (striped) hoặc torrent trên nhiều liên kết và đích đến; thời gian di chuyển của chúng có thể vẫn thấp hơn nhiều so với vòng đời của một công việc decode dài.
Sự phân tách này hữu ích cho cả hiệu suất và vận hành. Prefill và midfill có thể dự đoán được khi kích thước tiền tố cache, số lượng token mới và cấu hình worker đã biết. Thời gian hoàn thành decode là ngẫu nhiên vì thời điểm đến của token đầu ra cuối cùng không thể dự đoán trước. Bộ nhớ và lưu trữ chia sẻ giữa các nhóm cho phép mỗi giai đoạn chạy theo nhịp độ riêng của nó. Các phần sau của bài viết này sẽ thảo luận về hàng đợi, bộ đệm sẵn sàng và cấu hình lại worker. Hiện tại, điểm quan trọng là dịch vụ là một vòng lặp các giai đoạn được kết nối bởi trạng thái có thể di chuyển.
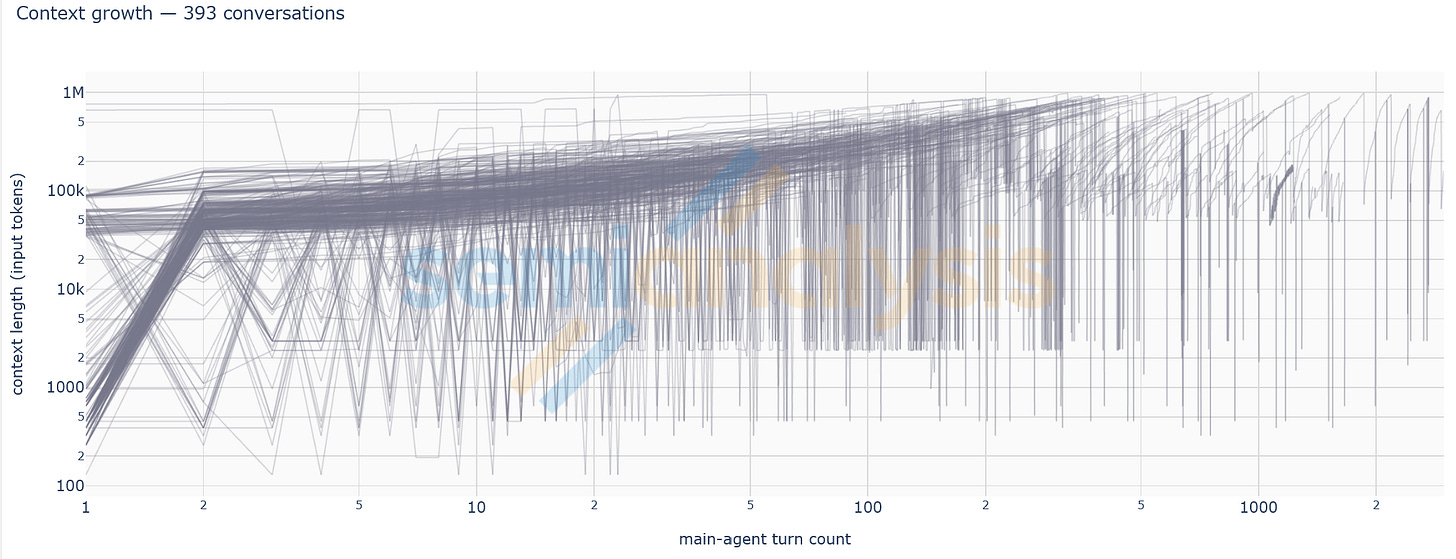
Điều này được xem xét với SemiAnalysis Conversation Explorer. Nó cho thấy rằng sự tăng trưởng ngữ cảnh trong các cuộc hội thoại có thể khá nhanh nhưng cũng trải qua những biến động lớn do việc nén và các hành vi mô hình khác có thể không được giải thích trong các cuộc thảo luận công khai. Việc điều phối ngữ cảnh suy luận là một lợi thế cạnh tranh cho các công ty AI.
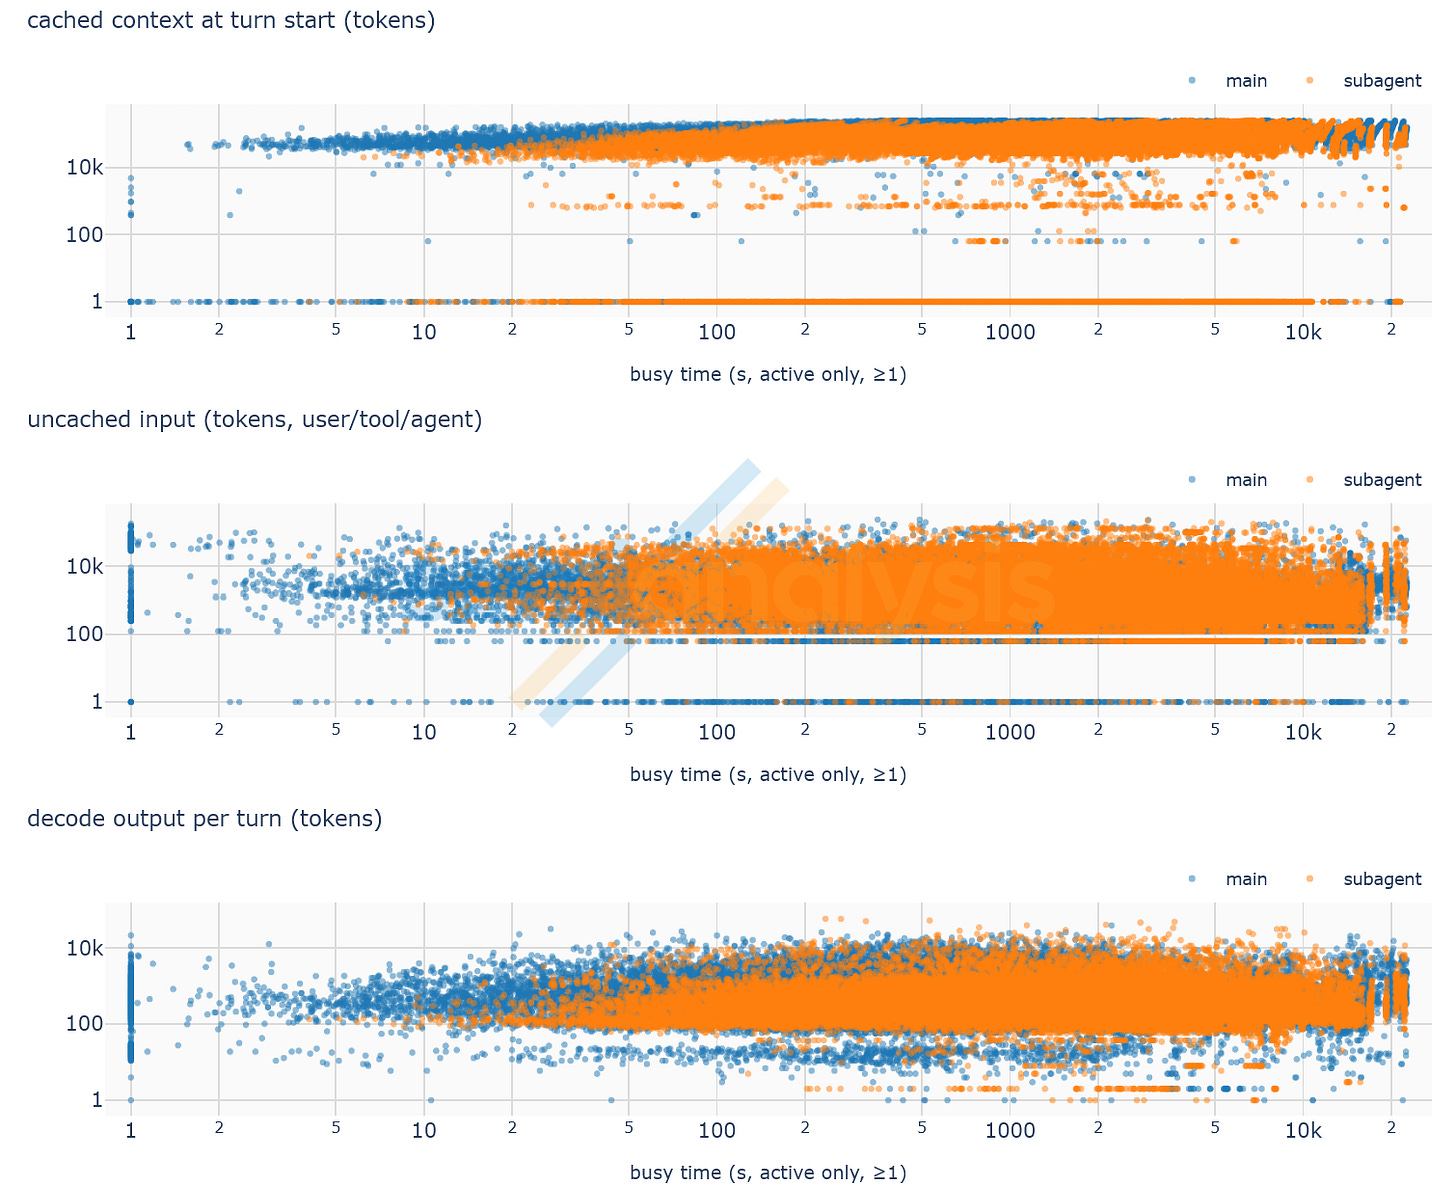
Chúng ta có thể lấy cùng một tập dữ liệu đó và rút ra các giá trị cache, đầu vào mới và độ dài kết quả được thấy ở mỗi lượt. Hình ảnh này cho thấy cách "Nhà máy tạo Token" cần phục vụ nhiều khối lượng công việc khác nhau. Về nguyên tắc, có thể có các yêu cầu tương tự như mỗi dấu chấm trong các dấu vết đó (và nhiều dấu chấm hơn từ các tập dữ liệu khối lượng công việc khác) tất cả đều chạy cùng một lúc, được gán cho một worker nào đó trong cụm AI.
Bài viết này nhằm mục đích khảo sát một số chức năng chính trong suy luận giúp điều đó trở nên khả thi.
Ngữ cảnh có thể tái sử dụng ở quy mô trung tâm dữ liệu trở thành một kho lưu trữ đối tượng chia sẻ (shared object-store) của các blob bất biến thay vì một tệp đính kèm vào một máy. Một lời nhắc hệ thống, ngữ cảnh dự án, các lượt người dùng trước đó, đầu ra công cụ và các token được tạo có thể nằm trong các blob riêng biệt. Một thao tác mới đọc các blob nó cần và thêm các blob mới; các blob hiện có thường không thay đổi. Cấu trúc chỉ tiến này tuân theo chính transformer nhân quả. Các thay đổi có thể được xử lý bằng cách quay lui và tạo một nhánh mới thay vì viết lại đường dẫn chung.
Nguồn bền vững của các blob này là một nhóm bộ nhớ và lưu trữ nhanh, song song, có khả năng mở rộng (scale-out). Nó cần đủ băng thông tổng hợp và phạm vi mạng để các worker prefill, midfill và decode có thể được chọn dựa trên sự phù hợp và tính khả dụng thay vì vì một máy sở hữu bản sao duy nhất của ngữ cảnh. Các blob mới nhàn rỗi trước tiên có thể di chuyển vào DRAM gắn mạng chia sẻ, bao gồm bộ nhớ CPU-nút và các thiết bị bộ nhớ chuyên dụng. Khi tầng đó đầy, một bộ phân loại có thể loại bỏ các blob không có khả năng tái sử dụng, hoặc thúc đẩy trạng thái tồn tại lâu hơn sang SSD. Văn bản và tham chiếu cơ bản thường nhỏ hơn nhiều bậc so với biểu diễn KV mở rộng, vì vậy có thể xây dựng lại một blob KV từ văn bản nhỏ hơn đó nếu việc phân loại quyết định tái sử dụng không gian và loại bỏ trạng thái nhúng mở rộng. Các tính toán AI có thể thay đổi tinh vi, vì vậy trong khi trạng thái được xây dựng lại có thể được mong đợi là một ngữ cảnh hợp lệ, các dịch vụ có thể áp dụng các cách tiếp cận khác nhau về mức độ tùy tiện loại bỏ và xây dựng lại, và mức độ cố gắng giữ lại trạng thái bất biến quan trọng.
Để tìm hiểu sâu hơn về cách các blob được quản lý, Unified Radix Cache: One Tree for Hybrid Model Prefix Caching - LMSYS Org là tài liệu đọc được khuyến nghị. Đó không phải là lời cuối cùng, nhưng nó được viết rõ ràng và sẽ chỉ cho bạn các nguồn khác nếu bạn muốn tìm hiểu thêm.
Cũng có những lần nén trạng thái thường xuyên với các tác nhân chạy dài tích lũy đến ngữ cảnh tối đa, vì vậy nhìn chung sau khi nén sẽ có nhiều blob trước đó đã bị bỏ rơi để ưu tiên cho một ngữ cảnh mới. Không gian từ các ngữ cảnh trước khi nén có lẽ được tái chế cho công việc mới.
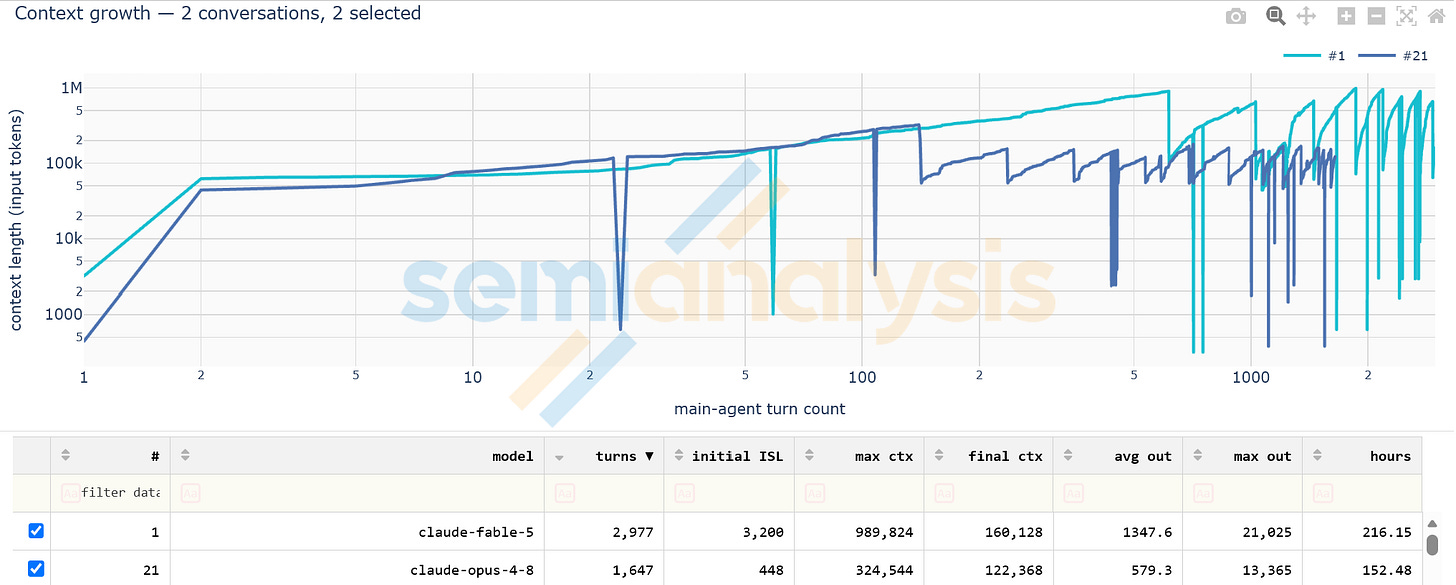
Bạn có thể thấy các lần nén xảy ra ở nửa bên phải của các cuộc hội thoại này khi ngữ cảnh tiến gần đến giới hạn ngữ cảnh thực tế cho mỗi mô hình (250k token cho Opus 4.8, 1MT cho Fable). Cũng có những "nhũ đá" trong cả hai dòng dường như là nhất thời và phản ánh một số hành vi độc quyền trong các mô hình của Anthropic.
HBM của bộ tăng tốc là tầng làm việc "nóng". Nó quá đắt đỏ và bị hạn chế nguồn cung để trở thành một mặc định tốt cho lưu trữ ngữ cảnh thụ động. Tiền tố và hậu tố hoạt động nên đi vào HBM ngay trước khi sử dụng và rời đi ngay sau khi worker đã hoàn thành với chúng. CPU DRAM là một tầng dàn dựng và lắp ráp hữu ích, đặc biệt là cho trạng thái đầu ra: một worker đã hoàn thành có thể di chuyển các blob mới tạo vào bộ nhớ CPU trong khi hệ thống lưu trữ chọn vị trí và tính dự phòng, sau đó NIC gửi chúng vào nhóm chia sẻ.
Đối với dữ liệu đầu vào, các hệ thống có khả năng RDMA có thể cho phép mạng đặt dữ liệu trực tiếp vào bộ nhớ bộ tăng tốc, tránh việc sao chép đầy đủ qua CPU DRAM. Bộ nhớ CPU vẫn hữu ích cho siêu dữ liệu, điều phối, lắp ráp một phần, đường dẫn dự phòng, bản sao và dàn dựng đầu ra. Khi một worker sử dụng nhiều GPU, ngữ cảnh đầu vào có thể được phân mảnh trực tiếp đến bộ nhớ đích của chúng song song.
Các cache blob nóng cấp tủ rack cũng có thể hữu ích, dù được triển khai dưới dạng thiết bị bộ nhớ/lưu trữ hay tận dụng bộ nhớ CPU được gán cho nhóm lưu trữ phân tán. Các đối tượng rất phổ biến như lời nhắc hệ thống là những ứng viên tự nhiên. Các cache này nên duy trì là các tài nguyên chia sẻ có khả năng mở rộng thay vì trạng thái riêng tư ràng buộc một yêu cầu với một máy decode. HBM đắt hơn vài lần và bị hạn chế nguồn cung hơn so với DDR. Cách sử dụng tốt nhất của HBM là cho dữ liệu trong một batch đang hoạt động và tạo ra doanh thu.
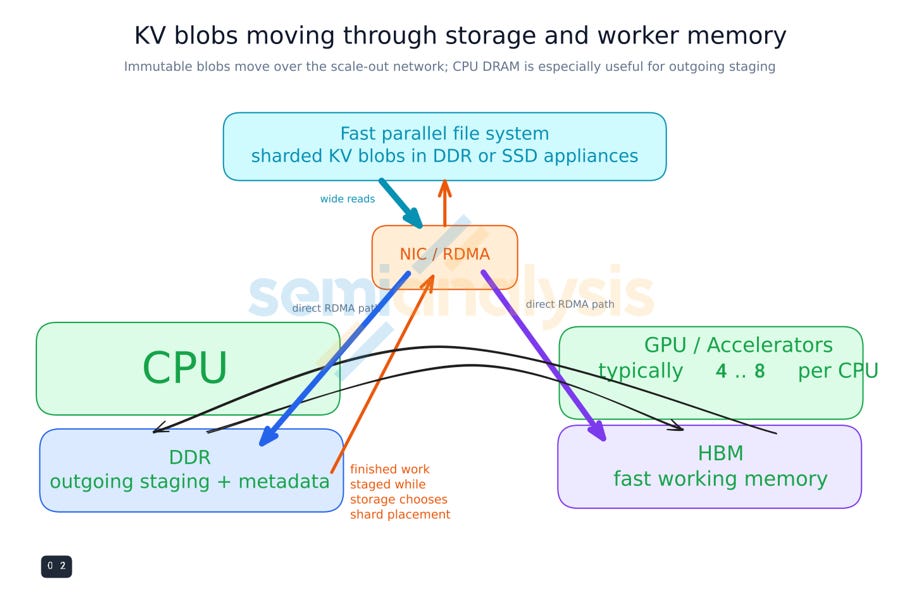
Đầu vào dữ liệu thường lớn hơn đầu ra. Midfill thường đọc một tiền tố lớn và thêm một hậu tố có ý nghĩa nhưng nhỏ hơn. Decode đọc ngữ cảnh đã tích lũy và chỉ thêm trạng thái cho một hoặc một vài token được tạo. Các lần đọc được lặp lại, các lần ghi thường chỉ xảy ra một lần. Thiết kế hệ thống nên thể hiện trực tiếp những khác biệt này với độ rộng của mỗi đường dẫn dữ liệu.
Bài viết được AI dịch và tổng hợp tự động từ SemiAnalysis RSS. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.