Hôm qua · 27/09

Chủ Nhật · 4 tin
Xiaomi MiMo: Phát hành và blog chính thức
Nghiên cứuĐiểm AI 63/100

Tinh chọnXiaomi MiMo-V2.6: Khắc phục lỗi lặp lại lệnh gọi công cụ với chi phí tối ưu nhờ MOPD

Xiaomi phân tích lỗi lặp lại lệnh gọi công cụ trên MiMo-V2.6 và giới thiệu phương pháp MOPD, giúp giảm chi phí khắc phục xuống chỉ còn 4% so với giải pháp MixRL truyền thống.


Vì sao đáng đọc: Bài viết cung cấp các thí nghiệm quy kết và lộ trình khắc phục hoàn chỉnh, đồng thời công khai so sánh chi phí, giúp độc giả tham khảo phương pháp chẩn đoán hành vi đột biến trong huấn luyện RL.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 54/100

Sử dụng Jev làm bộ kiểm lỗi (linter) cho Agent: Thử nghiệm phân tầng độ tin cậy và lọc quy tắc

This is brilliant. Recommended reading. It's a great example of how you could potentially build mo…

DịchMichael Thiessen chia sẻ cách dùng Jev để biến các hướng dẫn lập trình thành những quy tắc nhỏ, giúp Agent kiểm lỗi mã nguồn hiệu quả mà không cần suy luận phức tạp, đồng thời sử dụng tập dữ liệu kiểm thử để tránh quá tải (overfitting).

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 67/100

Cùng sự kiệnPrivatemode biến GLM-5.3-Flash thành mô hình ra quyết định có cấu trúc chỉ với một lần suy luận

Nhóm Privatemode giới thiệu kỹ thuật không cần tinh chỉnh, tận dụng log probability của GLM-5.3-Flash để thực hiện các quyết định có kiểu dữ liệu cụ thể chỉ trong một lần forward pass.

Cùng sự kiện, bài đại diện «Hướng dẫn sử dụng Jev: Kiểm duyệt nội dung với mô hình ra quyết định của TypeSafe trên OpenRouter»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

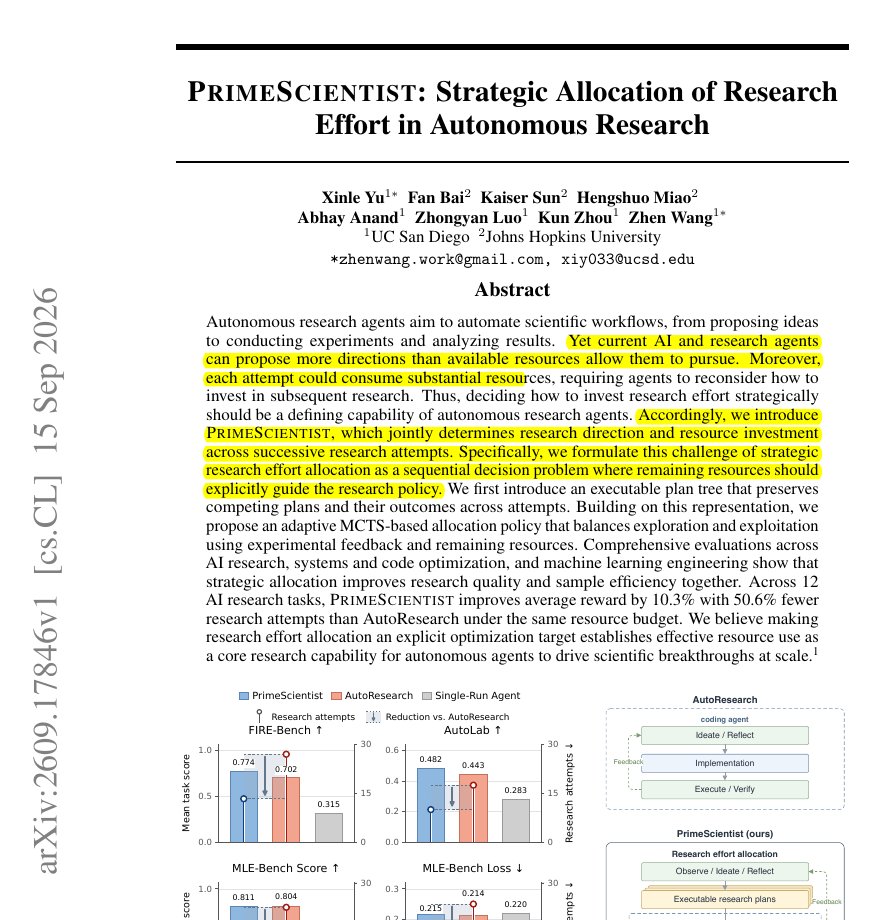
PRIMESCIENTIST: Tối ưu hóa ngân sách cho các tác nhân nghiên cứu AI

PRIMESCIENTIST shows that research agents should choose where to spend their experiments, rather tha…

DịchPRIMESCIENTIST cho phép các tác nhân nghiên cứu tự phân bổ ngân sách thử nghiệm thông qua cấu trúc cây, giúp tối ưu hóa việc khám phá khi dư dả và tập trung vào các nhánh tiềm năng khi ngân sách hạn hẹp, vượt trội hơn AutoResearch về hiệu suất lẫn tiết kiệm tài nguyên.

26/09

Thứ Bảy · 7 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 62/100

Xây dựng trình bao bọc LLM phong cách Jev: Tối ưu hóa phản hồi qua xác suất token và hỗ trợ thị giác

Tác giả allanrbo giới thiệu cách tiếp cận đơn hàm (single-function) để ép LLM trả về lựa chọn thông qua logprobs, đồng thời mở rộng hỗ trợ đầu vào hình ảnh cho các mô hình thị giác.

@typesafeai@typesafeai
Sản phẩmĐiểm AI 44/100

Cùng sự kiệnOpenRouter tích hợp Jev: Bộ định tuyến thông minh giúp tối ưu hóa chi phí và tốc độ LLM

You've never routed like this before. @OpenRouter is bringing Jev to all of your LLM calls, so your…

DịchOpenRouter vừa ra mắt Jev Router, công cụ định tuyến thông minh giúp tự động chọn mô hình và cường độ suy luận tối ưu cho từng yêu cầu, giúp tiết kiệm token mà vẫn đảm bảo chất lượng.

Cùng sự kiện, tinh chọn hiển thị «So sánh Jev 1.13 và Claude Opus 5: Hiệu năng phân loại dữ liệu ngân hàng trên OpenRouter»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

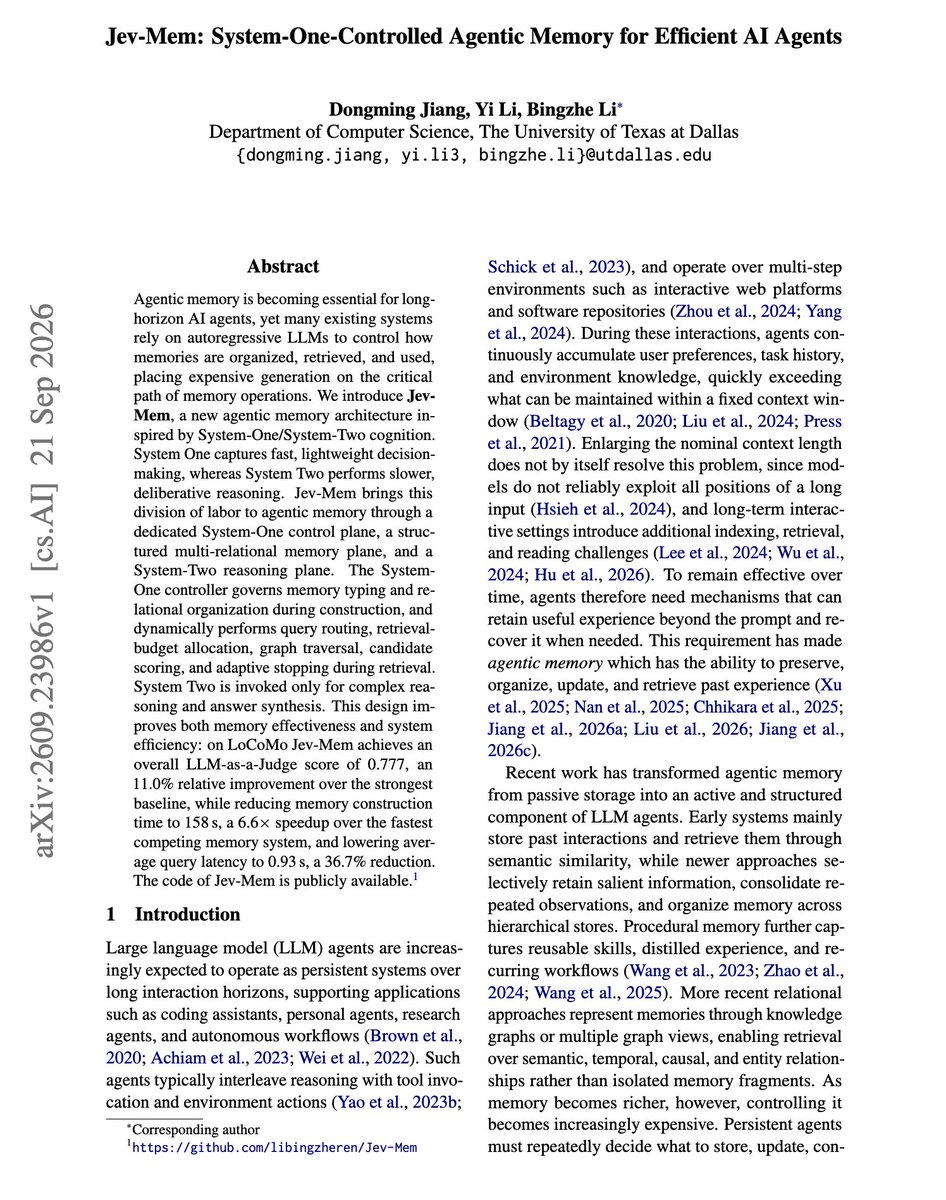
Jev-Mem: Kiến trúc bộ nhớ cho AI Agent lấy cảm hứng từ tư duy System-One/System-Two

Banger report on building faster memory for AI Agents. If your agent's memory layer is slow, this d…

DịchJev-Mem là kiến trúc bộ nhớ mới giúp tăng tốc độ xây dựng bộ nhớ lên 6,6 lần và giảm độ trễ truy vấn 36,7%, đạt hiệu suất vượt trội trên benchmark LoCoMo so với các giải pháp hiện có.

AK@_akhaliq
Mô hìnhĐiểm AI 48/100

Cùng sự kiệnRa mắt Qwen-Image-2.1-viggle-turbo v0.2: Tạo ảnh siêu tốc chỉ với 6 bước

Qwen-Image-2.1-viggle-turbo v0.2 is out on Hugging Face Text-to-image and image editing in 6 steps …

DịchPhiên bản Qwen-Image-2.1-viggle-turbo v0.2 đã có mặt trên Hugging Face, cho phép tạo và chỉnh sửa ảnh chỉ trong 6 bước, nhanh gấp 5 lần so với phiên bản Qwen-Image-2.1 tiêu chuẩn (40 bước).

Cùng sự kiện, bài đại diện «Viggle Turbo v0.2 ra mắt: Tạo ảnh và chỉnh sửa chỉ trong 6 bước»
Thariq@trq212
Hướng dẫnĐiểm AI 40/100

Giải mã 'effort' trong suy luận AI: Tại sao không nên luôn dùng mức tối đa?

What is effort really? When do you change it it and why not just use max effort for everything? I d…

DịchBài viết phân tích sâu về cơ chế 'effort' trong các mô hình AI, giải đáp lý do tại sao việc luôn đặt mức tối đa không phải lúc nào cũng mang lại hiệu quả tối ưu thông qua các thử nghiệm thực tế.

Viggle AI@ViggleAI
Sản phẩmĐiểm AI 39/100

Viggle Turbo v0.2 ra mắt: Tạo ảnh và chỉnh sửa chỉ trong 6 bước

🚀 Viggle Turbo v0.2 is out! Text-to-image and image editing in 6 steps: about 5× faster than the 40…

DịchViggle Turbo v0.2 vừa trình làng với khả năng tạo và chỉnh sửa ảnh chỉ trong 6 bước, đạt tốc độ nhanh gấp 5 lần so với Qwen-Image-2.1 (40 bước). Người dùng có thể trải nghiệm miễn phí ngay trên Hugging Face.

Thêm 1 nguồn khác đưa tinX: AK (@_akhaliq)

25/09

Thứ Sáu · 15 tin
Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 51/100

Perceptron ra mắt Mk1.5: Mô hình AI 35B cho robot, tốc độ xử lý nhanh gấp 4.7 lần

Perceptron released Mk1.5, a 35B embodied-agent model with up to 4.7× faster request completion. 4…

DịchPerceptron giới thiệu Mk1.5, mô hình 35B chuyên dụng cho robot và thiết bị đeo, giúp tối ưu hóa điều khiển mà không cần huấn luyện lại. Cải tiến này giúp tăng điểm MMSearch F1 lên 54.3 và giảm độ trễ phản hồi từ 5.2 giây xuống chỉ còn 1.1 giây.

@completeskeptic@completeskeptic
Sản phẩmĐiểm AI 47/100

DSPy 3.4.0 ra mắt: Tích hợp ReAnchor giúp tối ưu hóa độ tin cậy của mô hình

this is an honor! 🥹

DịchDSPy 3.4.0 vừa chính thức phát hành với khả năng hỗ trợ native cho các mô hình Jev và System one. Điểm nhấn của bản cập nhật này là trình tối ưu hóa ReAnchor hoàn toàn mới, giúp người dùng hiệu chỉnh độ tin cậy cho kết quả đầu ra một cách hiệu quả.

Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 40/100

Các mô hình System One đang tạo ra làn sóng mới cho hệ thống tùy chỉnh Agent

Own your harness, folks. I feel like System One models take custom agent harnesses to a whole diff…

DịchElvis Saravia từ DAIR.AI nhận định các mô hình System One đang nâng tầm hệ thống tùy chỉnh Agent. Điển hình là Contrastive Language Model (CLM) với tốc độ nhanh gấp 9 lần Jev, mang lại hiệu suất vượt trội trong các tác vụ dài hạn.

GitHub Blog
Hướng dẫnĐiểm AI 64/100

Tinh chọnGitHub tối ưu hóa hiệu suất: Chuyển đổi sang CSS Modules giúp giảm 55% thời gian SSR

Kỹ sư GitHub chia sẻ hành trình chuyển đổi hệ thống thiết kế Primer từ CSS-in-JS sang CSS Modules, giúp giảm 55% thời gian render phía máy chủ và 25% thời gian khởi tạo thành phần.


Vì sao đáng đọc: Bài viết cung cấp lộ trình hoàn chỉnh và lợi ích định lượng khi các tập đoàn lớn chuyển đổi từ CSS-in-JS sang CSS Modules, có thể áp dụng cho các dự án cải tiến kiến trúc frontend tương tự.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

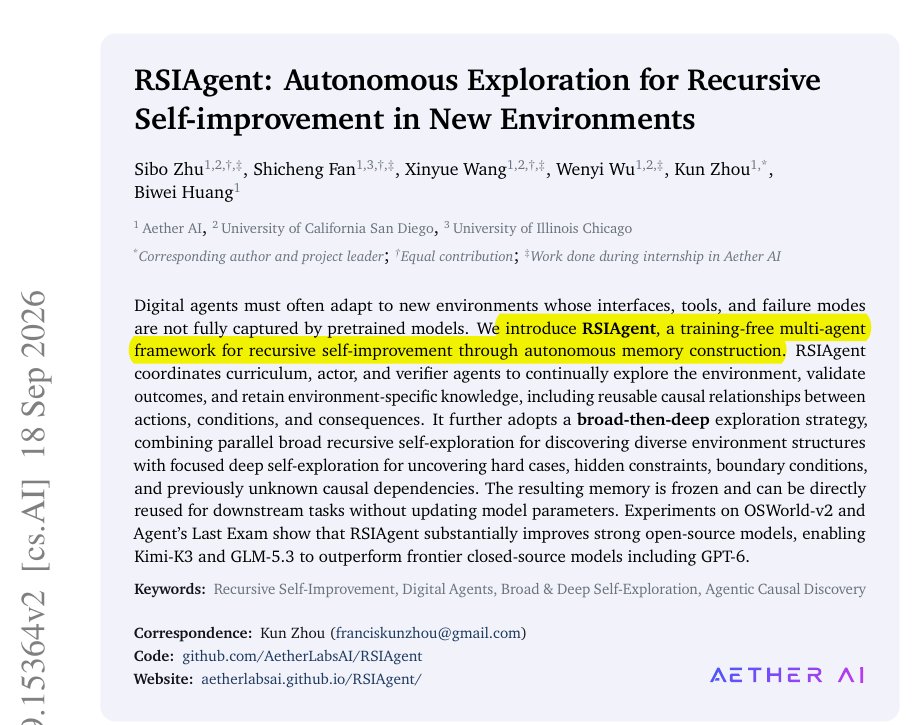
RSIAgent: Phương pháp huấn luyện tác nhân AI giải quyết tác vụ mới hiệu quả hơn

Agents that explored widely before tackling hard cases averaged 74.54% on 4 tasks, versus 56.50% whe…

DịchRSIAgent sử dụng chiến lược học tập theo lộ trình: khám phá rộng trước khi đi sâu vào các trường hợp khó, giúp tăng tỷ lệ thành công từ 56,5% lên 74,54% so với cách tiếp cận trực tiếp.

MarkTechPost
Nghiên cứuĐiểm AI 54/100

Perplexity huấn luyện AI Agent tự học từ sai lầm thực tế bằng phương pháp OPSD

Perplexity giới thiệu kỹ thuật OPSD kết hợp tinh chỉnh từ chối lấy mẫu, sử dụng dữ liệu từ các phiên làm việc thực tế của Perplexity Computer (chạy trên GLM 5.2) để giúp AI tự rút kinh nghiệm từ những lỗi sai.

Thêm 1 nguồn khác đưa tinX: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

ViRDM: Đột phá tạo video nhân quả ít bước bằng khớp phân phối biểu diễn

ViRDM là phương pháp hậu huấn luyện video không cần mô hình giáo viên hay bộ phân biệt, giúp tối ưu hóa việc tạo video nhân quả chỉ với 20 bước cập nhật, đạt hiệu suất vượt trội trên VBench với chi phí tính toán thấp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 41/100

IterSynth: Tối ưu hóa tác vụ tìm kiếm chuyên sâu thông qua cơ chế tách biệt vai trò và tổng hợp lặp

IterSynth giới thiệu phương pháp tìm kiếm chuyên sâu mới, tách biệt vai trò giữa lập kế hoạch và tổng hợp thông tin, giúp giải quyết hiệu quả vấn đề quá tải ngữ cảnh và xung đột vai trò trong các tác vụ tìm kiếm phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

Tối ưu hóa tỷ lệ méo hình cho các chỉ số chất lượng ảnh toàn tham chiếu bằng ước tính Hessian ngẫu nhiên

Nghiên cứu giới thiệu IDQD-RDO, phương pháp sử dụng ước tính Hessian ngẫu nhiên để tối ưu hóa các chỉ số chất lượng ảnh như MS-SSIM và LPIPS trong mã hóa VVC, giúp tiết kiệm 14.2-36.7% BD-rate mà không cần thay đổi bộ giải mã.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Boltzbit công bố nghiên cứu 'Infinite-Parameter LLMs' với kiến trúc BAST đột phá

There are two ways to make an agent improve. One is to leave the model unchanged and accumulate doc…

DịchBoltzbit giới thiệu Bayesian Self-learning Transformers (BAST), cho phép cập nhật tham số theo thời gian thực với chi phí tính toán thấp hơn 1.000 lần so với huấn luyện truyền thống, vượt trội hơn RAG trong các tác vụ hội thoại dài.

Perplexity@perplexity_ai
Sản phẩmĐiểm AI 46/100

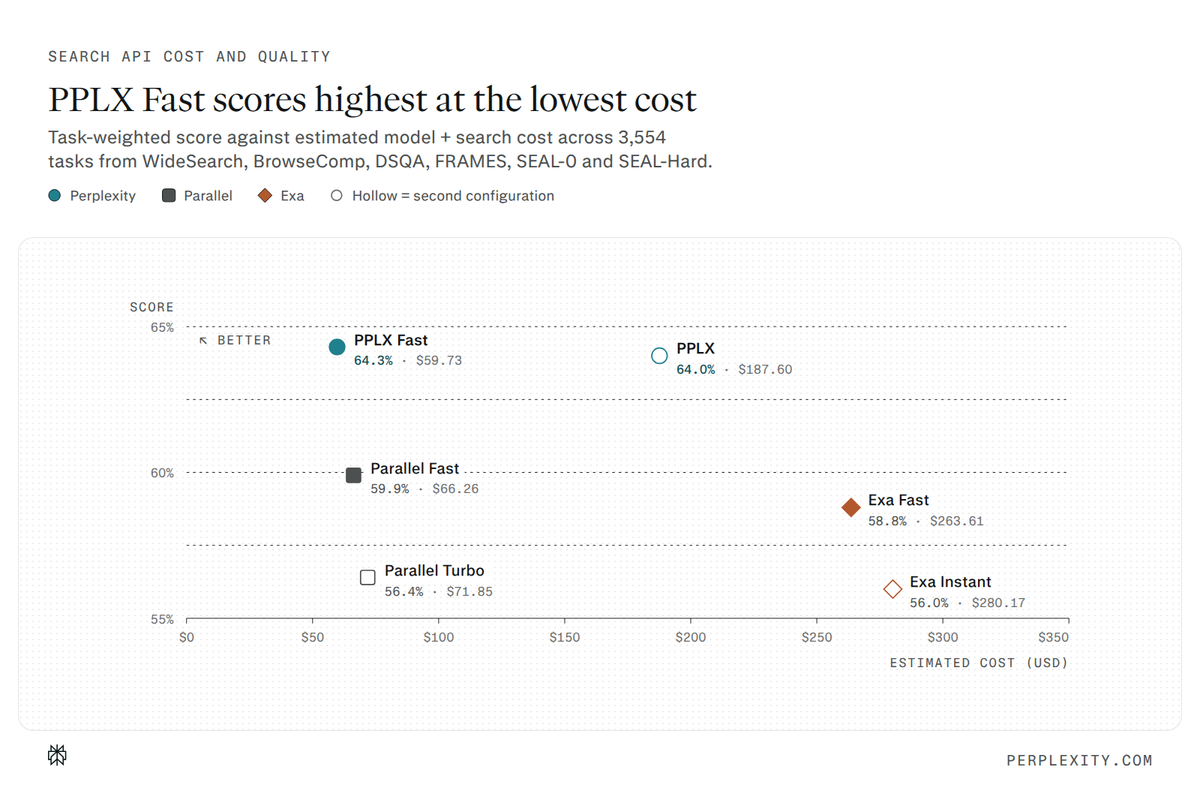
Perplexity ra mắt Fast Search cho API: Tốc độ phản hồi dưới 230ms

Introducing Fast Search in the Perplexity Search API. Fast Search runs on Photon, our new Rust-base…

DịchPerplexity giới thiệu Fast Search, dịch vụ tìm kiếm và xếp hạng mới dựa trên Rust mang tên Photon, giúp API đạt tốc độ phản hồi dưới 230ms cho 95% truy vấn.

Thêm 1 nguồn khác đưa tinX: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)

24/09

Thứ Năm · 19 tin
Peter Steinberger@steipete
Hướng dẫnĐiểm AI 63/100

OpenClaw loại bỏ 400.000 dòng mã kiểm thử dư thừa nhờ kỹ năng 'test-audit'

OpenClaw deleted around 400k LOC of its own tests without much change in code coverage. Modern model…

DịchPeter Steinberger chia sẻ cách OpenClaw cắt giảm 400.000 dòng mã kiểm thử không cần thiết mà không làm giảm độ phủ mã. Ông cho rằng các mô hình AI hiện nay thường tạo ra quá nhiều test thừa, và kỹ năng 'test-audit' là giải pháp hiệu quả để tối ưu hóa quy trình này.

QbitAI
NgànhĐiểm AI 92/100

Tinh chọnCard đồ họa PCIe bị đánh giá thấp: Tối ưu nhân và tái cấu trúc giao tiếp giúp DeepSeek tăng tốc suy luận gấp 7 lần

Nhờ cải tiến kỹ thuật, hệ thống sử dụng 1,5 card 6000D đã vượt qua hiệu suất của 1 card B300 trong tác vụ suy luận DeepSeek.


Vì sao đáng đọc: Bài viết mang tính đột phá về kỹ thuật tối ưu hóa phần cứng, giúp giảm chi phí hạ tầng đáng kể cho các mô hình AI lớn, rất hữu ích cho cộng đồng kỹ thuật.
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 57/100

DeepSeek thử nghiệm dùng GPU chơi game để chạy suy luận mô hình nhỏ nhằm giảm tải hạ tầng

DeepSeek is testing whether aggressive model optimization can push some share of inference for its s…

DịchDeepSeek đang thử nghiệm tối ưu hóa mô hình để có thể chạy suy luận trên các dòng GPU chơi game phổ thông, giúp giảm bớt áp lực thiếu hụt tài nguyên tính toán cao cấp.

WeChat: Volcano Engine
Sản phẩmĐiểm AI 66/100

Tinh chọnSeedance 2.5 ra mắt chế độ Draft: Tạo nháp 480P siêu tốc, xuất bản 1080P chỉ với một cú click

API Seedance 2.5 bổ sung chế độ Draft cho phép người dùng tạo bản nháp 480P để kiểm tra ý tưởng nhanh chóng, sau đó dùng ID bản nháp để xuất file 1080P hoàn chỉnh mà vẫn giữ nguyên các thông số kỹ thuật.


Vì sao đáng đọc: Thông tin chính thức đưa ra các con số tiết kiệm chi phí cụ thể và giải thích quy trình làm việc hai giai đoạn, giúp người sáng tạo xác định xem có nên tích hợp chế độ Draft vào quy trình tạo video của mình hay không.
@typesafeai@typesafeai
Mô hìnhĐiểm AI 27/100

JEV: Đột phá mới giúp LLM phản hồi suy luận tức thì

Stepping away while LLMs churn is the new "sorry, code's compiling". Jev makes instant feedback ju…

DịchJEV giới thiệu mô hình suy luận ngữ nghĩa mới, cho phép LLM đưa ra quyết định có cấu trúc ngay lập tức với mọi ngữ cảnh. Hiệu suất của JEV trong các tác vụ truy vấn phức tạp đã đạt ngưỡng tương đương với các mô hình Claude hàng đầu hiện nay.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 37/100

WhatWorkedBench: Bộ tiêu chuẩn đánh giá khả năng thấu hiểu thực nghiệm của AI Agent

WhatWorkedBench là bộ benchmark mới giúp đo lường khả năng dự đoán hiệu quả các thay đổi thành phần trong điều kiện ngân sách hạn chế của AI Agent, thông qua phân tích 1.248 bản ghi cấu hình và 108 tập dữ liệu thực nghiệm.

Claude Devs@ClaudeDevs
Hướng dẫnĐiểm AI 51/100

Tinh chọnĐội ngũ Claude chia sẻ cách tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần

We made claude.ai 3x faster in two weeks. Here's how we use Claude to measure, debug and improve p…

DịchĐội ngũ phát triển Claude tiết lộ quy trình sử dụng chính AI để đo lường, gỡ lỗi và tối ưu hóa hiệu suất hệ thống, kèm theo các bộ prompt thực chiến giúp tăng tốc độ phản hồi của claude.ai lên gấp 3 lần.

Diễn biến sự kiện · 3 bài →Thêm 3 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Thariq (@trq212)X: Boris Cherny (@bcherny)

Vì sao đáng đọc: Tác giả chia sẻ các phương pháp cụ thể để đo lường, gỡ lỗi và cải thiện hiệu suất của claude.ai, kèm theo các câu lệnh gợi ý (prompt) để độc giả tham khảo và áp dụng.
Thariq@trq212
Hướng dẫnĐiểm AI 63/100

Cùng sự kiệnAnthropic chia sẻ bí quyết tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần

this is a new type of post we're trying where we share in-depth about how we do work using specific …

DịchĐội ngũ Anthropic công bố quy trình tối ưu hóa hiệu suất cho claude.ai, cung cấp chi tiết các phương pháp đo lường, gỡ lỗi và bộ prompt thực tế để cộng đồng có thể áp dụng.

Cùng sự kiện, tinh chọn hiển thị «Đội ngũ Claude chia sẻ cách tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần»
Apple Machine Learning Research
Nghiên cứuĐiểm AI 42/100

Apple giới thiệu Probe Guidance: Tối ưu hóa mô hình ngôn ngữ khuếch tán mà không cần tăng tính toán

Apple đề xuất phương pháp Probe Guidance tận dụng trạng thái nội tại của mô hình khuếch tán để dẫn dắt quá trình tạo văn bản mà không làm tăng chi phí tính toán, thiết lập kỷ lục SOTA mới cho các mô hình 1.7B.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 48/100

Nghiên cứu mới từ Google: Tải mô hình là 'nút thắt' chính gây độ trễ khi khởi động LLM lượng tử hóa

New Google paper shows for small quantized LLMs on serverless CPUs, 55-70% of cold-start latency is …

DịchNghiên cứu của Google chỉ ra rằng 55-70% độ trễ khởi động của các LLM lượng tử hóa trên CPU serverless đến từ việc tải trọng số mô hình. Việc tăng dung lượng RAM cấp phát có thể giúp tối ưu hóa đáng kể tốc độ suy luận.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 79/100

Cùng sự kiệnAnthropic chia sẻ cách tối ưu hóa giúp claude.ai và ứng dụng desktop nhanh gấp 3 lần

Đội ngũ kỹ thuật Anthropic đã thực hiện đợt chạy nước rút 2 tuần để tăng tốc trải nghiệm người dùng, giảm thời gian phản hồi ban đầu trên claude.ai từ 3,1 giây xuống còn 0,55 giây và cải thiện đáng kể tốc độ khởi chạy của Claude Code cũng như Claude Cowork.

Cùng sự kiện, tinh chọn hiển thị «Đội ngũ Claude chia sẻ cách tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (64 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa” | AIHOT.vn