Hôm qua · 27/09

Chủ Nhật · 1 tin
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 24/100

ClusterMAX 3.0: Tác động của cấu hình cụm máy chủ đến hiệu suất thực tế

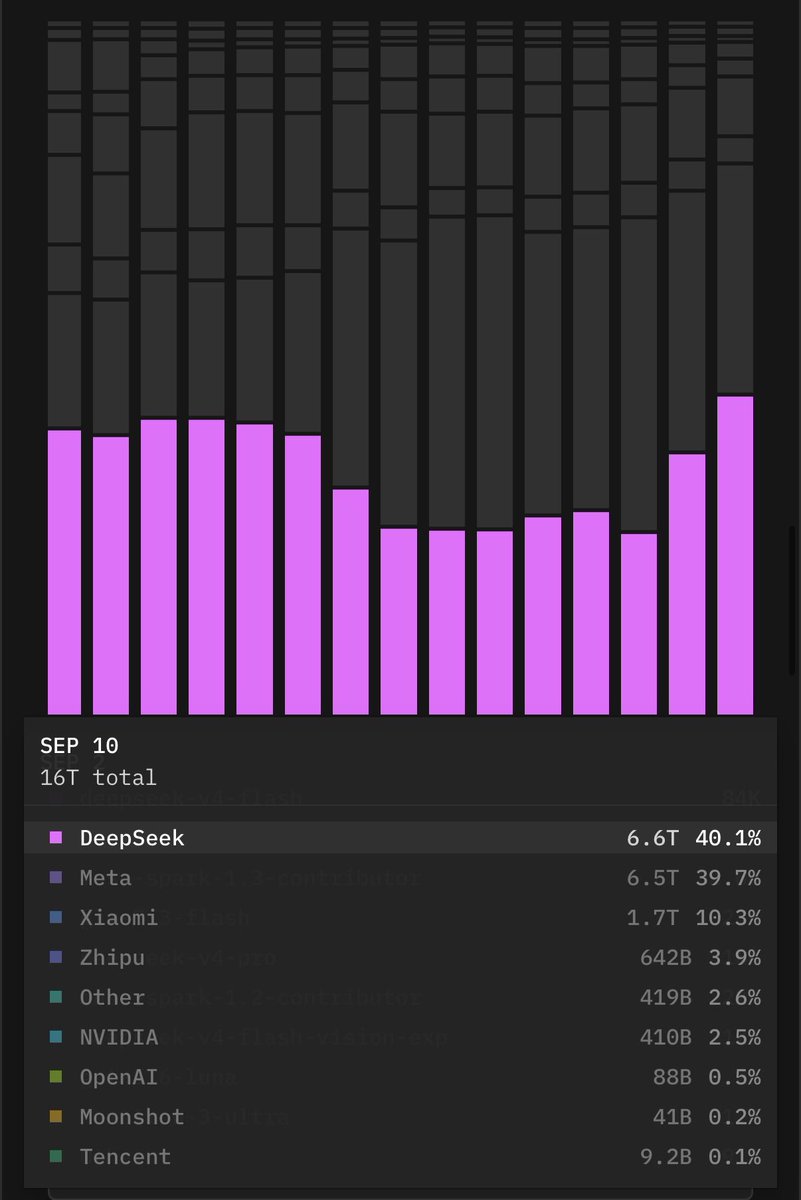
In our ClusterMAX 3.0 article we shared some real examples of how changes in a cluster configuration…

DịchBài viết phân tích các ví dụ thực tế về cách thay đổi cấu hình cụm máy chủ ảnh hưởng trực tiếp đến hiệu suất vận hành, minh họa cụ thể qua các khối lượng công việc huấn luyện AI.
26/09

Thứ Bảy · 2 tin
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 26/100

SemiAnalysis đánh giá độ tin cậy của ClusterMAX 3.0

In our testing for ClusterMAX 3.0, one of the biggest things that we tested was reliability. we buil…

DịchSemiAnalysis thực hiện kiểm thử độ tin cậy cho ClusterMAX 3.0, tập trung vào khả năng nhận diện và phục hồi sau sự cố để đảm bảo hiệu suất thông lượng ổn định từ các nhà cung cấp.

Thariq@trq212
Hướng dẫnĐiểm AI 40/100

Giải mã 'effort' trong suy luận AI: Tại sao không nên luôn dùng mức tối đa?

What is effort really? When do you change it it and why not just use max effort for everything? I d…

DịchBài viết phân tích sâu về cơ chế 'effort' trong các mô hình AI, giải đáp lý do tại sao việc luôn đặt mức tối đa không phải lúc nào cũng mang lại hiệu quả tối ưu thông qua các thử nghiệm thực tế.

24/09

Thứ Năm · 5 tin
@completeskeptic@completeskeptic
Mô hìnhĐiểm AI 18/100

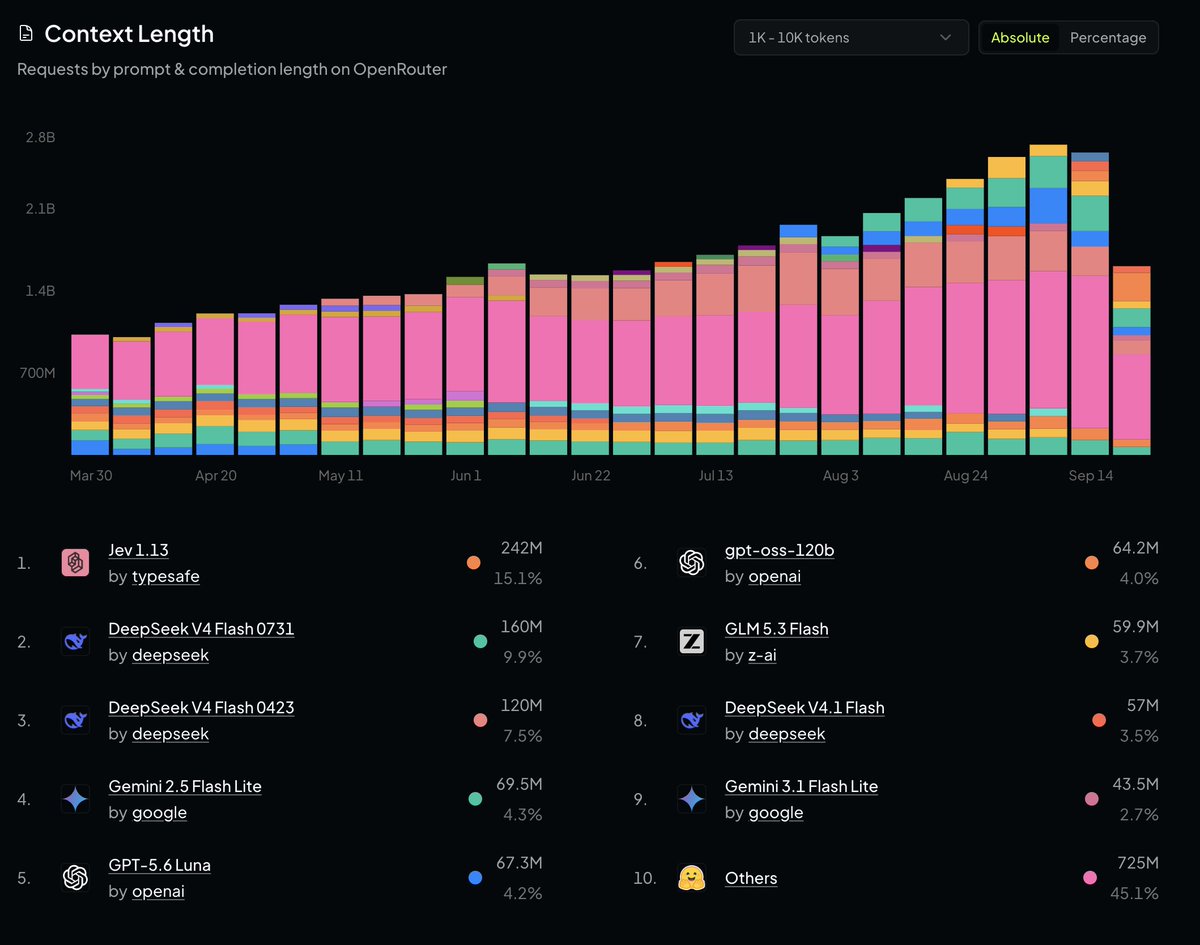
Cùng sự kiệnMô hình jev chính thức dẫn đầu bảng xếp hạng OpenRouter cho ngữ cảnh ngắn

jev is the top model at 1k-10k context on openrouter!

DịchMô hình jev đã vượt qua các đối thủ để chiếm vị trí số 1 trên OpenRouter trong phân khúc xử lý ngữ cảnh từ 1k đến 10k token.

Cùng sự kiện, tinh chọn hiển thị «So sánh Jev 1.13 và Claude Opus 5: Hiệu năng phân loại dữ liệu ngân hàng trên OpenRouter»
Claude Devs@ClaudeDevs
Hướng dẫnĐiểm AI 51/100

Tinh chọnĐội ngũ Claude chia sẻ cách tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần

We made claude.ai 3x faster in two weeks. Here's how we use Claude to measure, debug and improve p…

DịchĐội ngũ phát triển Claude tiết lộ quy trình sử dụng chính AI để đo lường, gỡ lỗi và tối ưu hóa hiệu suất hệ thống, kèm theo các bộ prompt thực chiến giúp tăng tốc độ phản hồi của claude.ai lên gấp 3 lần.

Diễn biến sự kiện · 3 bài →Thêm 3 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Thariq (@trq212)X: Boris Cherny (@bcherny)

Vì sao đáng đọc: Tác giả chia sẻ các phương pháp cụ thể để đo lường, gỡ lỗi và cải thiện hiệu suất của claude.ai, kèm theo các câu lệnh gợi ý (prompt) để độc giả tham khảo và áp dụng.
Thariq@trq212
Hướng dẫnĐiểm AI 63/100

Cùng sự kiệnAnthropic chia sẻ bí quyết tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần

this is a new type of post we're trying where we share in-depth about how we do work using specific …

DịchĐội ngũ Anthropic công bố quy trình tối ưu hóa hiệu suất cho claude.ai, cung cấp chi tiết các phương pháp đo lường, gỡ lỗi và bộ prompt thực tế để cộng đồng có thể áp dụng.

Cùng sự kiện, tinh chọn hiển thị «Đội ngũ Claude chia sẻ cách tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần»

23/09

Thứ Tư · 1 tin
Tibo@thsottiaux
Quan điểmĐiểm AI 16/100

Đội ngũ phát triển tập trung tối ưu hóa đồng thời hiệu suất và trí tuệ nhân tạo

We have been focusing on efficiency and intelligence for all. Very proud of the team. Only possibl…

DịchĐội ngũ cam kết cân bằng giữa hiệu suất và trí tuệ, khẳng định rằng việc sở hữu các mô hình AI hàng đầu là chìa khóa để tạo ra những thay đổi đột phá trên mọi phương diện.

22/09

Thứ Ba · 2 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

Khảo sát doanh nghiệp: 60% gặp khó trong việc dự báo chi phí triển khai AI

The information conducted a survey with 107 senior leaders/professionals. - 60% of companies report…

DịchDù 60% doanh nghiệp ghi nhận hiệu suất tăng, phần lớn vẫn chật vật kiểm soát chi phí AI. Chỉ 1/3 số đơn vị thực sự làm chủ được ngân sách token dù hơn một nửa cho biết họ hiểu rõ cơ cấu giá.

16/09

Thứ Tư · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Lightning Weave: Tối ưu hóa sự cân bằng giữa độ chính xác và hiệu suất cho các mô hình suy luận

Lightning Weave là khung huấn luyện hậu kỳ giúp kết hợp các khả năng suy luận từ nhiều mô hình chuyên biệt vào một mô hình duy nhất, giúp cải thiện đồng thời độ chính xác và tốc độ suy luận thông qua kỹ thuật chưng cất chính sách.

15/09

Thứ Ba · 1 tin
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 62/100

Giải mã Prefill và Decode: Tại sao AI đọc tài liệu dài mới phản hồi, nhưng viết lại càng lúc càng chậm?

Bài viết giải thích hai giai đoạn suy luận của LLM: Prefill xử lý song song đầu vào quyết định tốc độ phản hồi ban đầu (TTFT), trong khi Decode tạo văn bản từng token một và thường bị nghẽn băng thông bộ nhớ.

12/09

Thứ Bảy · 1 tin

08/09

Thứ Ba · 2 tin
AI Notes@AYi_AInotes
NgànhĐiểm AI 32/100

Đột phá hiệu suất AI: Grok Bots phối hợp qua sơ đồ trạng thái giúp tăng năng suất gấp 33 lần

Thay vì chờ đợi các mô hình đơn lẻ thông minh hơn, kỹ sư SpaceXAI đã kết nối 20 Grok Bots vào một sơ đồ trạng thái để tự động hóa quy trình từ lập kế hoạch đến kiểm duyệt, giúp tăng khối lượng công việc xử lý hàng ngày từ 6 lên hơn 200 tác vụ.

07/09

Thứ Hai · 2 tin
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 57/100

Đừng nhồi nhét kỹ năng cho AI Agent: Cách tối ưu hóa hiệu suất bằng 'kiểm toán' prompt

Việc lạm dụng plugin và kỹ năng khiến AI Agent bị quá tải ngữ cảnh, làm giảm hiệu suất phản hồi. Tác giả chia sẻ prompt giúp lọc bỏ các kỹ năng dư thừa, chỉ giữ lại những công cụ cốt lõi để tối ưu hóa khả năng xử lý của mô hình.

Tibo@thsottiaux
Hướng dẫnĐiểm AI 54/100

Mẹo tối ưu chi phí: GPT-6 Astra ở mức suy luận thấp vẫn vượt trội hơn GPT-5.6 Sol mức cao

To calibrate you all on which reasoning effort to use for Astra, know that GPT-6 Astra on low perfor…

DịchChuyên gia Tibo khuyến nghị người dùng nên hạ mức suy luận khi chuyển sang GPT-6 Astra, vì hiệu năng ở mức thấp (low) đã vượt qua GPT-5.6 Sol ở mức cao (high), giúp tiết kiệm tài nguyên mà vẫn đảm bảo chất lượng.

04/09

Thứ Sáu · 1 tin
OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
Hướng dẫnĐiểm AI 29/100

Legora ứng dụng GPT-6 Astra: Rà soát 41 tài liệu tài chính trong vài phút, độ chính xác tuyệt đối

Legora đã tối ưu hóa quy trình kiểm toán tài chính bằng GPT-6 Astra, giúp rà soát 41 tài liệu trong vài phút và phát hiện chính xác 4 lỗi sai, nâng cao hiệu suất công việc lên gần 40%.

03/09

Thứ Năm · 3 tin
Alibaba Cloud@alibaba_cloud
Mô hìnhĐiểm AI 50/100

Qwen3.8-Flash ra mắt chế độ Standard trên QwenWork: Tăng tốc độ tạo tác vụ gấp 2 lần, giảm 75% tiêu thụ token

🚀 A better AI shouldn't just be faster-it should get more real work done with less budget. Qwen3.8-…

DịchAlibaba Cloud vừa tích hợp Qwen3.8-Flash vào chế độ Standard của QwenWork, giúp tối ưu hóa hiệu suất vượt trội với tốc độ xử lý nhanh gấp đôi và tiết kiệm đáng kể chi phí token cho người dùng.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Declarative Attention: Bước tiến mới giúp mô hình ngôn ngữ tự kiểm soát cơ chế chú ý

Nghiên cứu giới thiệu giao thức Declarative Attention (DA), cho phép mô hình tự chỉ định vùng ngữ cảnh cần tập trung trong quá trình suy luận. Điều này giúp tối ưu hóa hiệu suất bằng cách lược bỏ các thao tác đọc KV cache không cần thiết.

01/09

Thứ Ba · 1 tin

29/08

Thứ Bảy · 1 tin

28/08

Thứ Sáu · 4 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 65/100

Kỷ nguyên mô hình nhỏ: Cách gpt-5.6-luna thay đổi cuộc chơi chi phí AI

Các mô hình nhỏ như gpt-5.6-luna đang tạo ra bước ngoặt về tốc độ và chi phí, cho phép xử lý khối lượng công việc lớn với giá cực rẻ. Đây là tín hiệu cho thấy các ứng dụng AI tiêu dùng và doanh nghiệp sẽ bùng nổ nhờ hiệu suất tối ưu.

27/08

Thứ Năm · 2 tin

25/08

Thứ Ba · 2 tin
Eric Zakariasson@ericzakariasson
Hướng dẫnĐiểm AI 59/100

Mẹo xử lý khi robot bị treo bằng kỹ thuật giám sát qua Prompt

if your bots quietly quit, try this: you are a workforce checker. every 15 minutes, look at the oth…

DịchKhi robot của bạn ngừng hoạt động, hãy thiết lập một 'giám sát viên' AI để kiểm tra trạng thái mỗi 15 phút. AI chỉ cần thông báo cho bạn khi phát hiện sự cố thực sự cần can thiệp, giúp tối ưu hóa quy trình vận hành tự động.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 47/100

Thuế không khí: Cái giá ẩn sau các AI Coding Agent

Một lập trình viên phát hiện AI tiêu tốn sạch hạn mức token chỉ để tạo ra hàng đống file test thừa thãi thay vì ứng dụng thực tế. Hiện tượng này được gọi là 'thuế không khí' – cái giá đắt đỏ mà người dùng phải trả cho sự tự tin thái quá của AI.

24/08

Thứ Hai · 2 tin
NVIDIA Blog
Sản phẩmĐiểm AI 63/100

Tinh chọnNVIDIA Vera Rubin NVL72 thiết lập chuẩn mực mới: Hiệu suất xử lý AI Agent tăng gấp 30 lần

Dữ liệu từ NVIDIA cho thấy Vera Rubin NVL72 giúp tăng lưu lượng xử lý trên mỗi megawatt lên gấp 30 lần và giảm chi phí trên mỗi triệu token xuống 35 lần so với thế hệ GB300 NVL72.

Thêm 1 nguồn khác đưa tinJiqizhixin

Vì sao đáng đọc: Tin tức quan trọng về phần cứng thế hệ mới của NVIDIA, tác động trực tiếp đến chi phí vận hành và hiệu suất của các hệ thống AI Agent quy mô lớn.

23/08

Chủ Nhật · 1 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 29/100

Qwen 2.5 27B gây ấn tượng khi hoàn thành tác vụ kỹ thuật đảo ngược chỉ trong 30 phút

Một lập trình viên đã thử thách mô hình Qwen 2.5 27B với một tác vụ kỹ thuật đảo ngược phức tạp và nhận được kết quả hoàn hảo chỉ sau 30 phút, khẳng định năng lực xử lý kỹ thuật vượt trội của mô hình này.

21/08

Thứ Sáu · 3 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 37/100

CTIFoundry: Tối ưu hóa cấu trúc dữ liệu giúp tăng hiệu suất cho AI Agent

Very interesting new work Amazon and colleagues. (bookmark it) This connects to the emerging theme…

DịchAmazon giới thiệu CTIFoundry, phương pháp xây dựng cấu trúc tri thức tại thời điểm lập chỉ mục giúp tăng đáng kể điểm F1 cho các AI Agent. Giải pháp này cho phép các mô hình nhỏ đạt hiệu suất vượt trội so với các mô hình flagship mà không cần tăng số lượng lệnh gọi công cụ.

Hugging Face: Blog
Mô hìnhĐiểm AI 61/100

Tinh chọnHugging Face ra mắt dòng mô hình DSpark: Tăng tốc suy luận lên đến 3,18 lần

Hugging Face giới thiệu các mô hình dự đoán DSpark cho dòng LFM2.5, giúp tăng tốc độ xử lý trên GPU lên 3,18 lần và thiết bị đầu cuối lên 2,87 lần mà không làm giảm chất lượng đầu ra. Công nghệ này đã hỗ trợ mã nguồn mở cho llama.cpp và SGLang.

Thêm 1 nguồn khác đưa tinMarkTechPost

Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng giúp tối ưu hóa hiệu suất mô hình nhỏ, có tính ứng dụng cao cho cộng đồng phát triển AI và triển khai thực tế.

20/08

Thứ Năm · 2 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (59 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Hiệu suất” | AIHOT.vn