In our testing for ClusterMAX 3.0, one of the biggest things that we tested was reliability. we buil…
DịchSemiAnalysis thực hiện kiểm thử độ tin cậy cho ClusterMAX 3.0, tập trung vào khả năng nhận diện và phục hồi sau sự cố để đảm bảo hiệu suất thông lượng ổn định từ các nhà cung cấp.
Nhóm nghiên cứu tại Stanford chỉ ra rằng nhiều bộ tiêu chuẩn đánh giá AI hiện nay không đo lường chính xác năng lực như tuyên bố, thậm chí còn cho kết quả mâu thuẫn nhau khi cùng kiểm tra một thuộc tính.
Bài báo chỉ ra rằng việc thiếu kiểm định độ tin cậy của mô hình là rào cản lớn trong đánh giá LLM, dẫn đến sai lầm nguy hiểm khi triển khai thực tế và làm hỏng quy trình nghiên cứu.
Một nghiên cứu từ Financial Times cho thấy các chatbot AI hiện nay thường xuyên cung cấp thông tin sai lệch khi người dùng đặt câu hỏi về lĩnh vực tài chính, đặt ra thách thức lớn về độ tin cậy.
XConf là phương pháp ước tính độ tin cậy mới, không chỉ dựa vào suy luận hiện tại mà còn truy xuất các bài học từ những trải nghiệm giải quyết vấn đề trong quá khứ để đánh giá chính xác hơn khả năng thành công của mô hình.
Vì sao đáng đọc: Đây là hướng tiếp cận mới mẻ và thực tiễn trong việc giải quyết bài toán 'ảo tưởng' của AI, giúp các hệ thống tự động hóa đưa ra quyết định tin cậy hơn.
Giao thức DCP thiết lập quy trình kiểm chứng nghiêm ngặt nhằm xác minh tính xác thực của các kết quả nghiên cứu từ AI, ngăn chặn việc gian lận dữ liệu thông qua các bài kiểm tra phục hồi và phản hồi độc lập.
A model can look strong on average and still be unpredictable on the same prompt. Martian's new AI …
DịchMartian công bố bảng xếp hạng AI Frontier, đánh giá độ tin cậy qua 16 tiêu chuẩn khắt khe. Kết quả cho thấy Qwen3.7 Max dẫn đầu với 96,1%, vượt qua Claude Opus 4.6 và GPT-5.5.
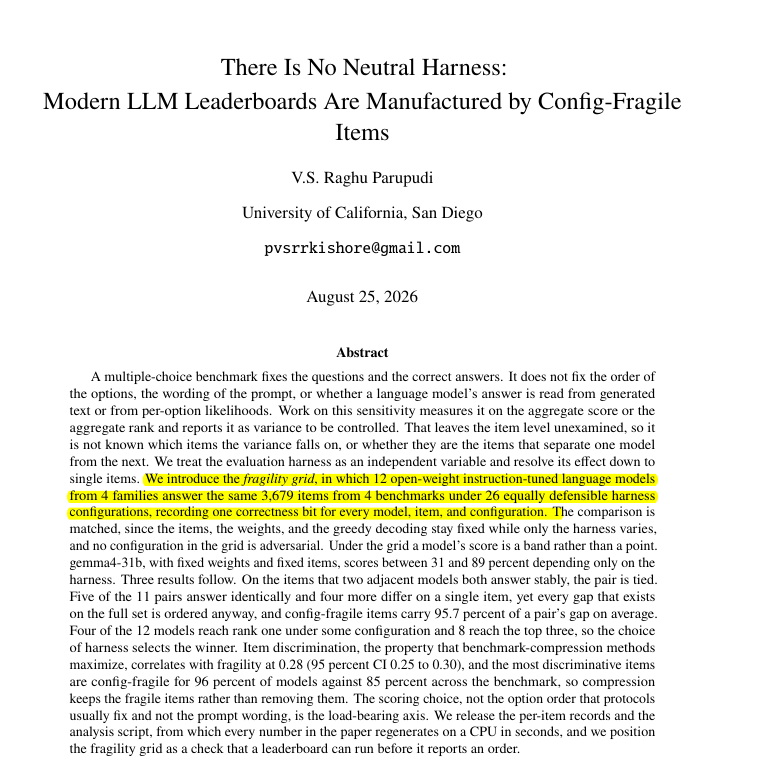
LLM rankings can be created by evaluation choices as much as model differences, so one setup should …
DịchMột nghiên cứu cho thấy chỉ cần thay đổi định dạng prompt hoặc cách chấm điểm, điểm số của cùng một mô hình (như Gemma-2-27b) có thể dao động từ 31% đến 89%, làm lung lay tính khách quan của các bảng xếp hạng LLM hiện nay.
Nghiên cứu giới thiệu ElephantBench, bộ dữ liệu gồm 1.094 câu hỏi để kiểm tra khả năng của LLM trong việc ghi nhớ các quan điểm trái chiều về những sự kiện ít phổ biến. Kết quả cho thấy ngay cả các mô hình mạnh nhất cũng thường bỏ sót các luồng thông tin khác nhau, cho thấy lỗ hổng trong tri thức của AI.
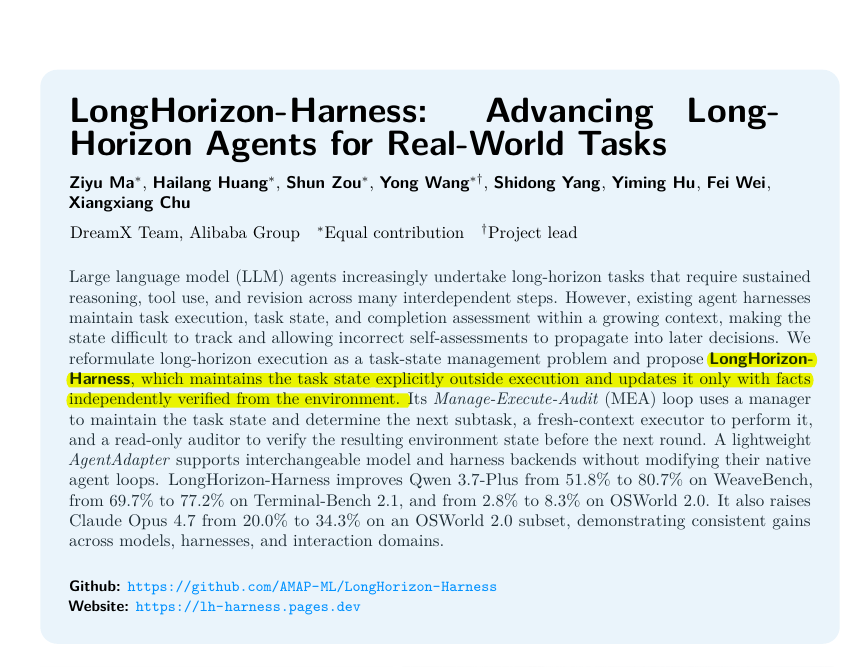
Long-horizon agent reliability has not arrived yet with better models. On WeaveBench's 114 hybrid …
DịchDù các mô hình AI ngày càng mạnh, khả năng thực hiện nhiệm vụ dài hạn vẫn hạn chế với tỷ lệ thành công chỉ 41,2% trên WeaveBench. Nghiên cứu chỉ ra rằng độ tin cậy phụ thuộc nhiều vào hệ thống kiểm soát ngoại vi (harness) hơn là bản thân mô hình.
// There Is No Neutral Harness // Great work discussing some of the issues in harness evaluation. …
DịchNghiên cứu chỉ ra rằng chỉ cần thay đổi thứ tự đáp án hoặc cách diễn đạt câu lệnh, điểm số của các mô hình AI có thể dao động cực lớn, khiến bảng xếp hạng hiện nay trở nên thiếu khách quan.
DịchNghiên cứu mới chỉ ra rằng cách thiết lập bộ khung đánh giá ảnh hưởng cực lớn đến kết quả của AI. Chỉ cần thay đổi thứ tự đáp án hay cách đặt câu hỏi, thứ hạng của các mô hình có thể bị đảo lộn hoàn toàn, cho thấy các bài kiểm tra hiện nay còn nhiều lỗ hổng.
LLMs can reproduce the broad direction of human survey results, but not the actual human response di…
DịchMột nghiên cứu tâm lý học cho thấy LLM chỉ mô phỏng được xu hướng chung chứ không tái hiện chính xác phân phối câu trả lời của con người. Các mô hình huấn luyện bằng dữ liệu AI có hiệu suất dự báo kém, cho thấy LLM chỉ phù hợp cho các khảo sát thử nghiệm chi phí thấp.
RUPA là khung làm việc mới giúp đánh giá độ tin cậy của tác nhân LLM bằng cách mô hình hóa lịch sử thực thi dưới dạng đồ thị, từ đó phát hiện lỗi tích tụ qua các bước suy luận thay vì chỉ dựa vào xác suất từng từ đơn lẻ.
Grok 4.6 ranks #1 on RuntimeWire's Newsroom Reliability v0.2 benchmark with a score of 0.79, beating…
DịchGrok 4.6 vừa xuất sắc giành vị trí quán quân trong bài kiểm tra Newsroom Reliability v0.2 của RuntimeWire với số điểm 0.79, vượt qua các đối thủ sừng sỏ như GPT-5.6 Sol, Claude Opus 4.8, Gemini và DeepSeek.
 SemiAnalysis@SemiAnalysis_