Sản phẩmĐiểm AI 36/100
TinyAIArena: Đấu trường so tài cho các AI Agent
Dự án TinyAIArena vừa ra mắt, cung cấp bảng xếp hạng trực quan cho các trận đấu giữa các AI Agent với dữ liệu từ 43 trận đã hoàn thành, trung bình 10,3 lượt mỗi trận.
Dự án TinyAIArena vừa ra mắt, cung cấp bảng xếp hạng trực quan cho các trận đấu giữa các AI Agent với dữ liệu từ 43 trận đã hoàn thành, trung bình 10,3 lượt mỗi trận.
Bài hướng dẫn chi tiết cách lập trình Sound Encoder theo chuẩn MSEB 0.1.0 và thực hiện đánh giá đa nhiệm trên các tác vụ phân loại, phân cụm, truy xuất và phân đoạn âm thanh.
 Dex Horthy (HumanLayer)@dexhorthy
got tired of watching slopcodebench boxes progress so made something a little…sloppier
DịchChán ngấy các thanh tiến trình cứng nhắc của slopcodebench, Dex Horthy đã tạo ra một công cụ đánh giá năng lực lập trình mới với cách tiếp cận tự do và phóng khoáng hơn.

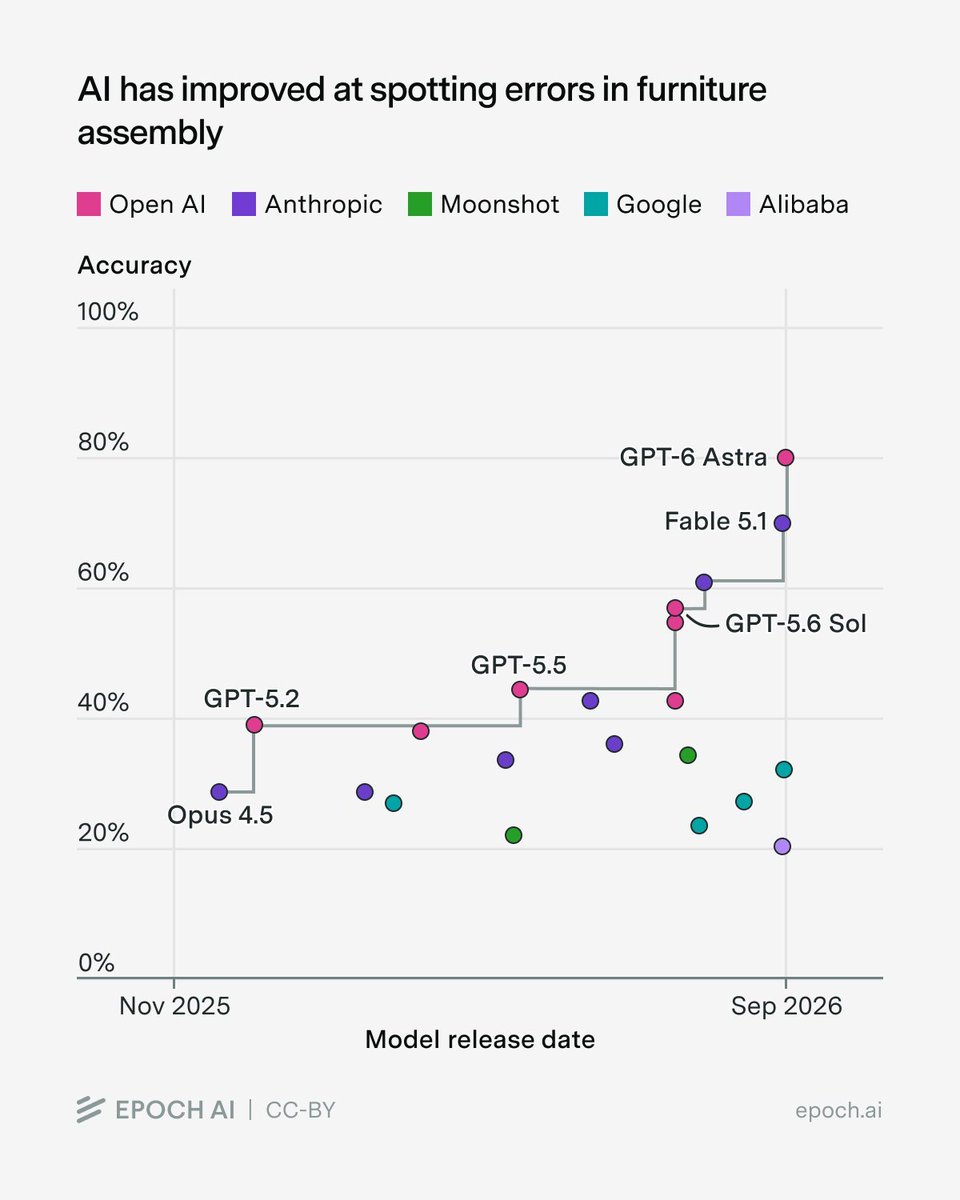
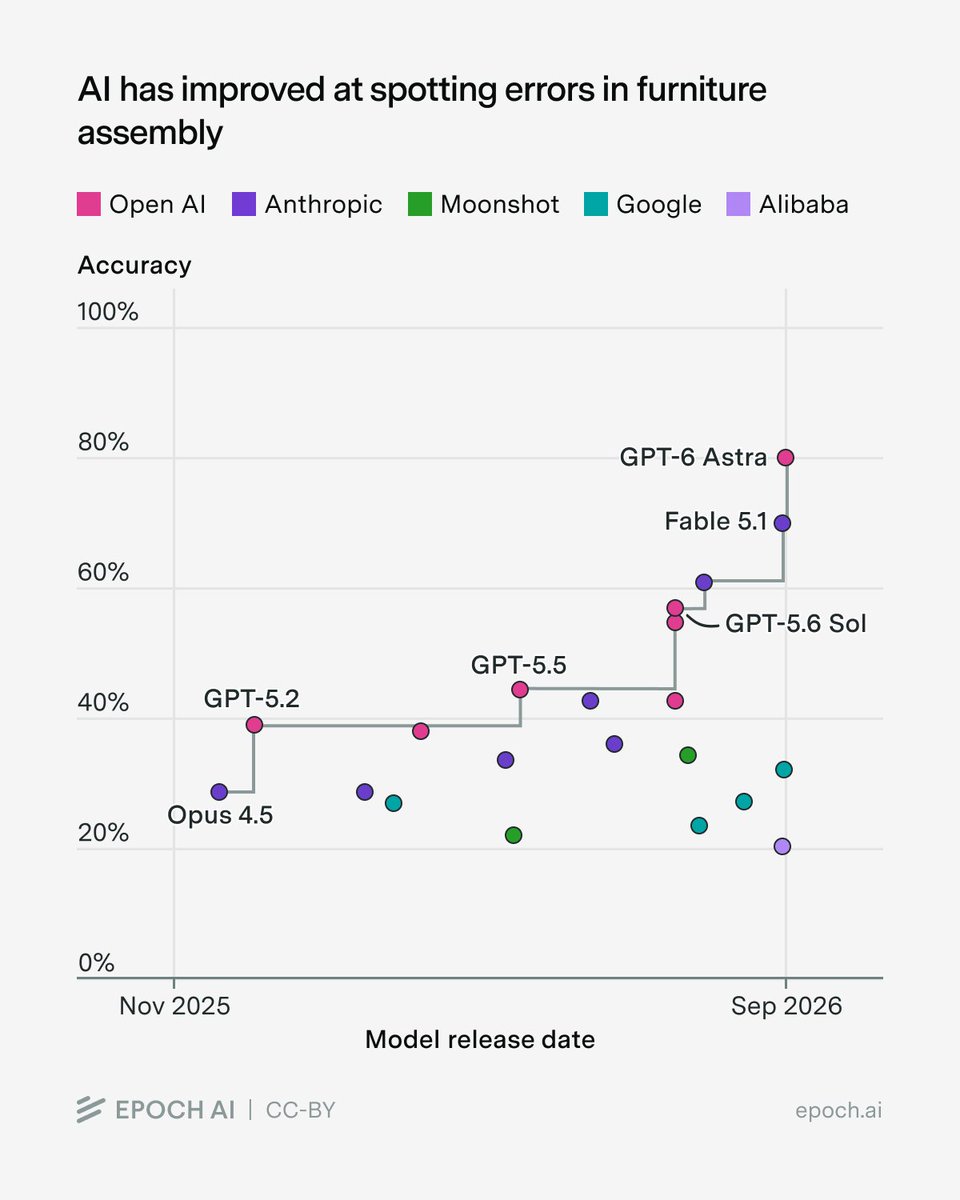
Benchmark FAB từ Epoch AI cho thấy OpenAI GPT-6 Astra dẫn đầu với 80% độ chính xác trong việc phát hiện lỗi lắp ráp nội thất, vượt qua Claude Fable 5.1 (70%) và Claude Opus 5 (61%).
Cùng sự kiện, bài đại diện «GPT-6 Astra của OpenAI đạt độ chính xác 80% trong việc phát hiện lỗi lắp ráp nội thất IKEA»Nhóm nghiên cứu tại Stanford chỉ ra rằng nhiều bộ tiêu chuẩn đánh giá AI hiện nay không đo lường chính xác năng lực như tuyên bố, thậm chí còn cho kết quả mâu thuẫn nhau khi cùng kiểm tra một thuộc tính.
 Arena@arena
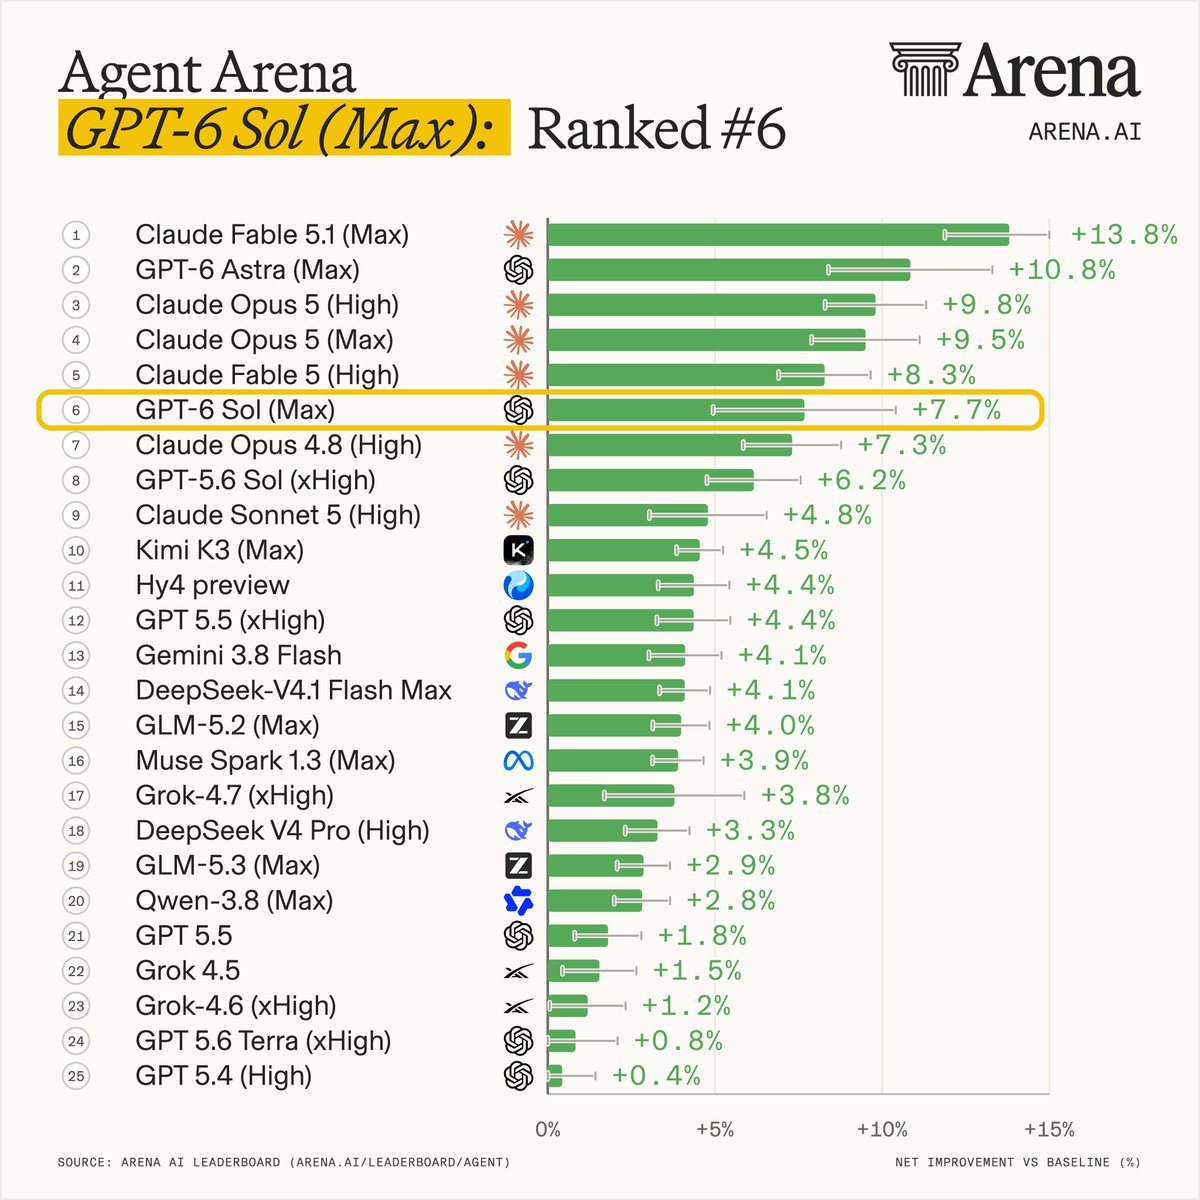
GPT-6 Sol (Max) just landed in the Agent Arena with +7.7% net-improvement at #6 across 4K+ real-worl…
DịchOpenAI vừa ra mắt GPT-6 Sol và GPT-6 Luna. Trong đó, phiên bản GPT-6 Sol (Max) đã nhanh chóng đạt vị trí thứ 6 trên bảng xếp hạng Agent Arena, ghi nhận mức tăng trưởng hiệu suất 7,7% qua hơn 4.000 phiên hội thoại thực tế.
 Elvis Saravia@omarsar0
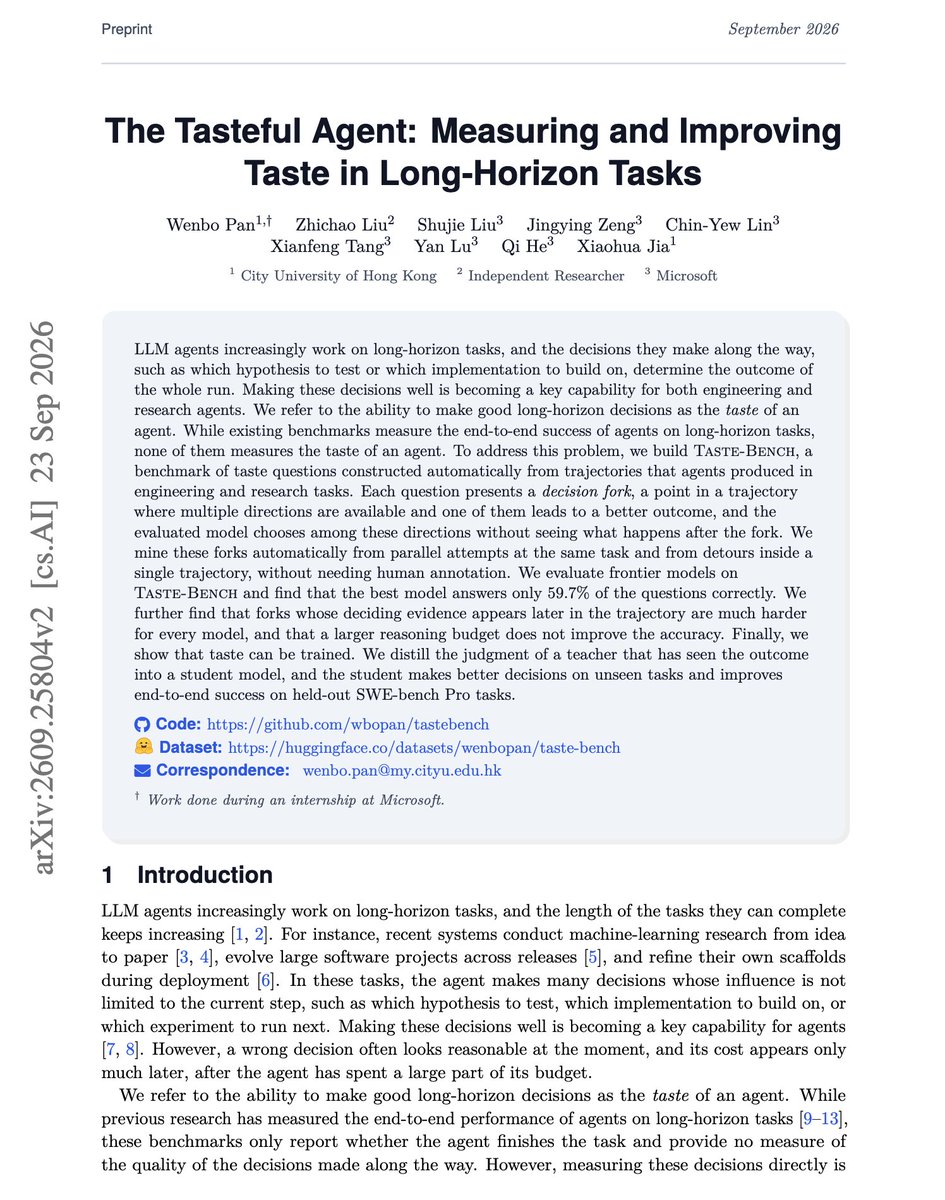
Banger paper from Microsoft and colleagues. We talk about human taste being important in this AI er…
DịchMicrosoft giới thiệu Taste-Bench, bộ tiêu chuẩn đánh giá khả năng chọn hướng đi đúng của AI Agent trong các tác vụ dài. Kết quả cho thấy ngay cả khi tăng ngân sách suy luận, các mô hình vẫn gặp khó khăn với độ chính xác chỉ 59,7%, đòi hỏi phương pháp chưng cất tri thức từ mô hình giáo viên để cải thiện hiệu suất.
 Arena@arena
Grok 4.7 by @SpaceXAI just landed in Agent Arena at #16, with a net improvement score of +3.96% Gro…
DịchMô hình Grok 4.7 (xHigh) vừa ghi dấu ấn tại vị trí thứ 16 trên bảng xếp hạng Agent Arena với mức cải thiện điểm số ấn tượng là +3,96%.

ExplorationBench sử dụng các môi trường giả lập với quy tắc logic mới lạ, buộc AI phải tự khám phá thay vì dựa vào dữ liệu huấn luyện sẵn, giúp đánh giá chính xác tư duy khoa học của mô hình.
 Artificial Analysis@ArtificialAnlys
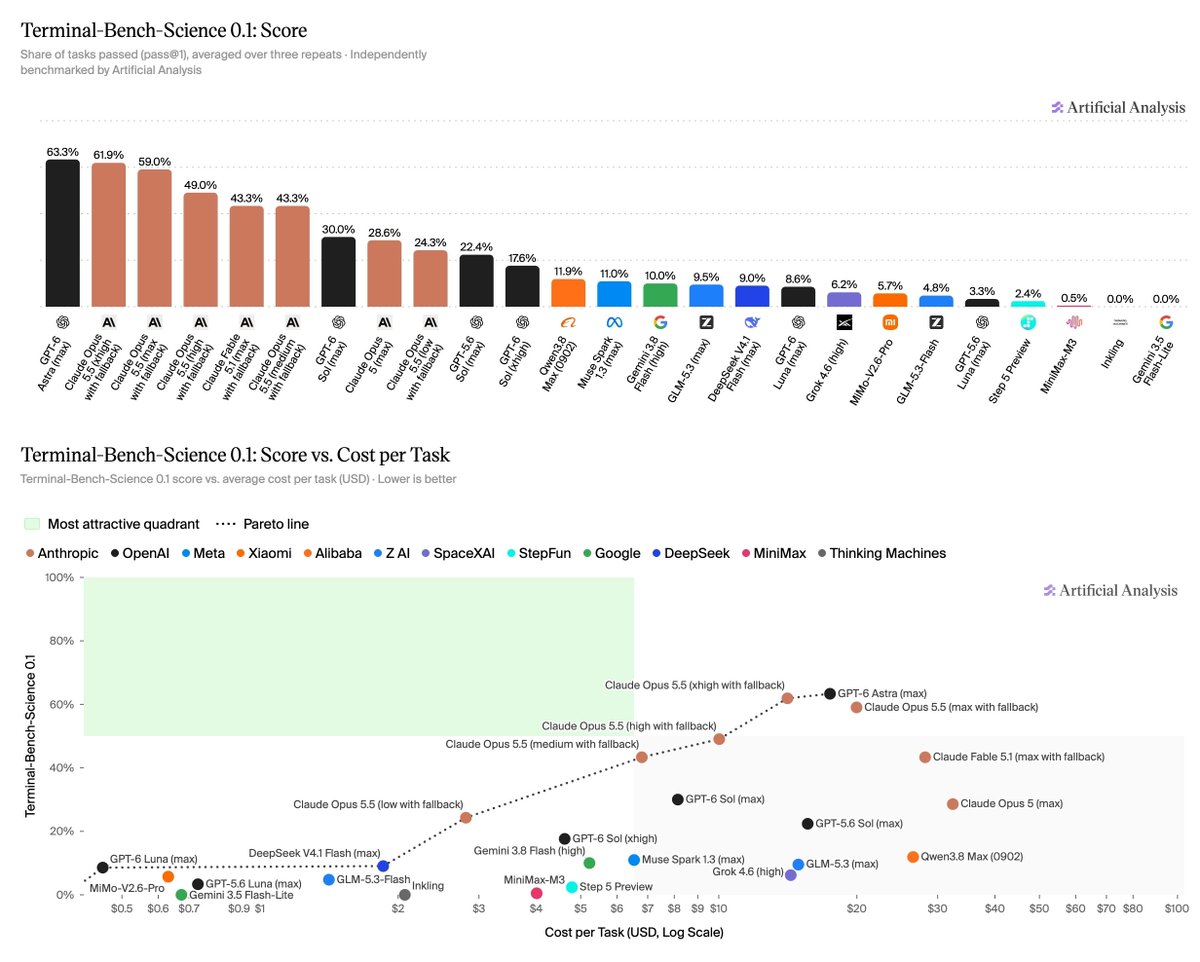
Today we're launching our leaderboard for Terminal-Bench-Science 0.1, an agentic benchmark for scien…
DịchArtificial Analysis vừa công bố bảng xếp hạng Terminal-Bench-Science 0.1, trong đó GPT-6 Astra (max) dẫn đầu với 63%, theo sát là Claude Opus 5.5 (xhigh) với 62%.
 Arena@arena
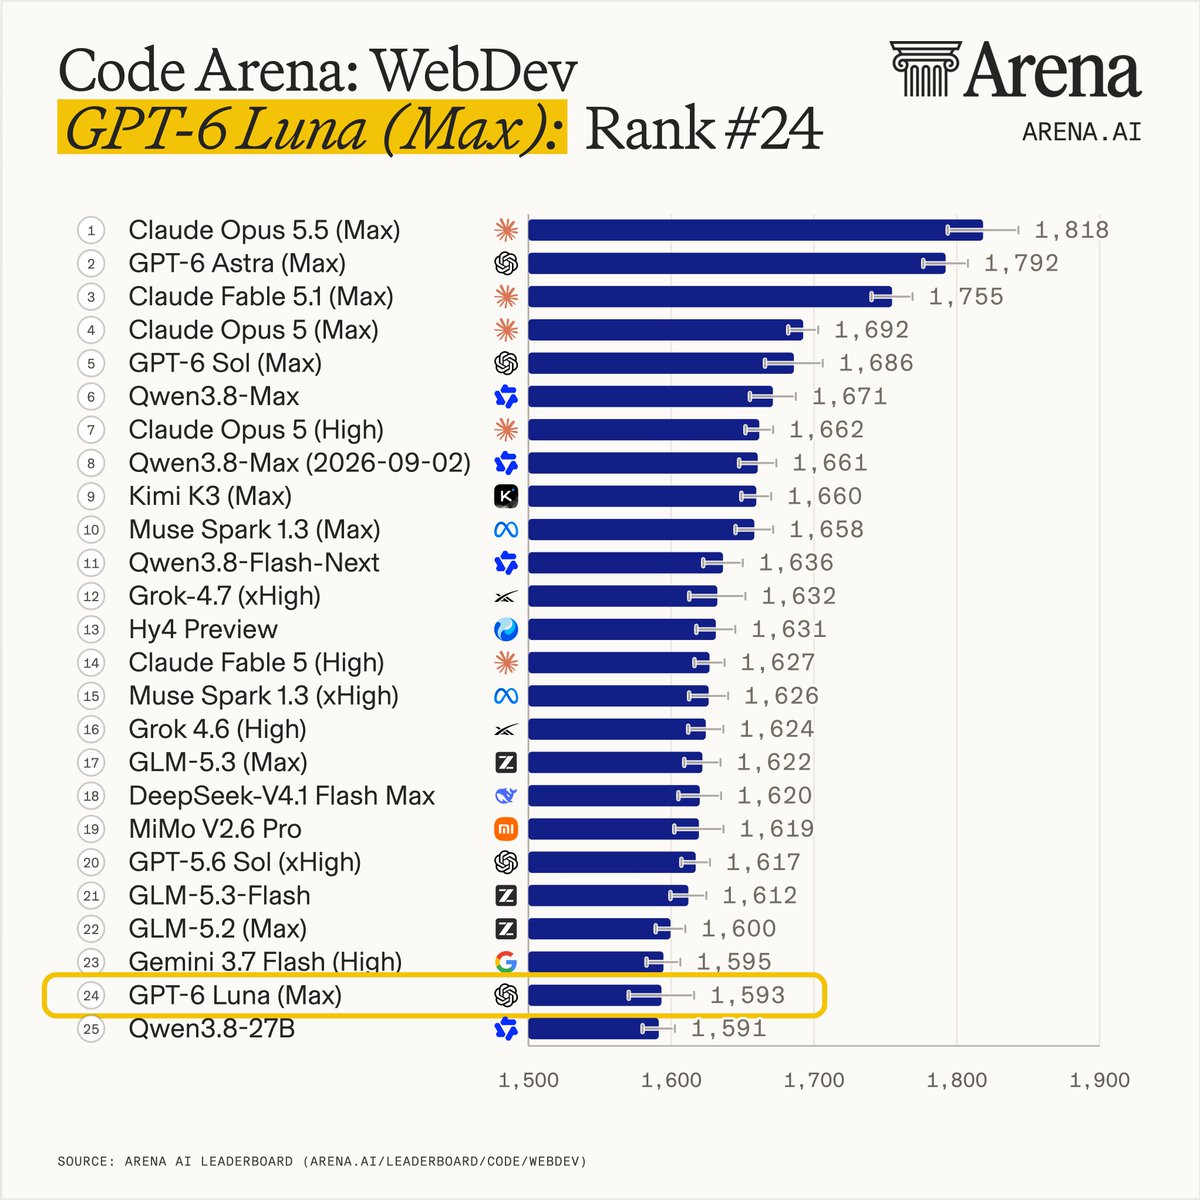
Real-world results are in for GPT-6 Luna (Max). It just landed #24 in the Code Arena: WebDev with 15…
DịchGPT-6 Luna (Max) vừa ghi dấu ấn với 1593 điểm, xếp thứ 24 trên bảng xếp hạng Code Arena: WebDev, vượt xa người tiền nhiệm GPT-5.6 Luna (xHigh) tới 74 điểm.
 Elvis Saravia@omarsar0
Interesting results here. This is why I expect more agent workloads to run on blended models. Paret…
DịchPareto 26.9 gây ấn tượng khi đạt đồng hạng nhất với GPT-6 Astra trong 30 tác vụ AI Agent, với chi phí chỉ bằng 1/3 và tốc độ vượt trội so với DeepSeek V4 Pro và GLM 5.3 Flash.
 OpenRouter@OpenRouter
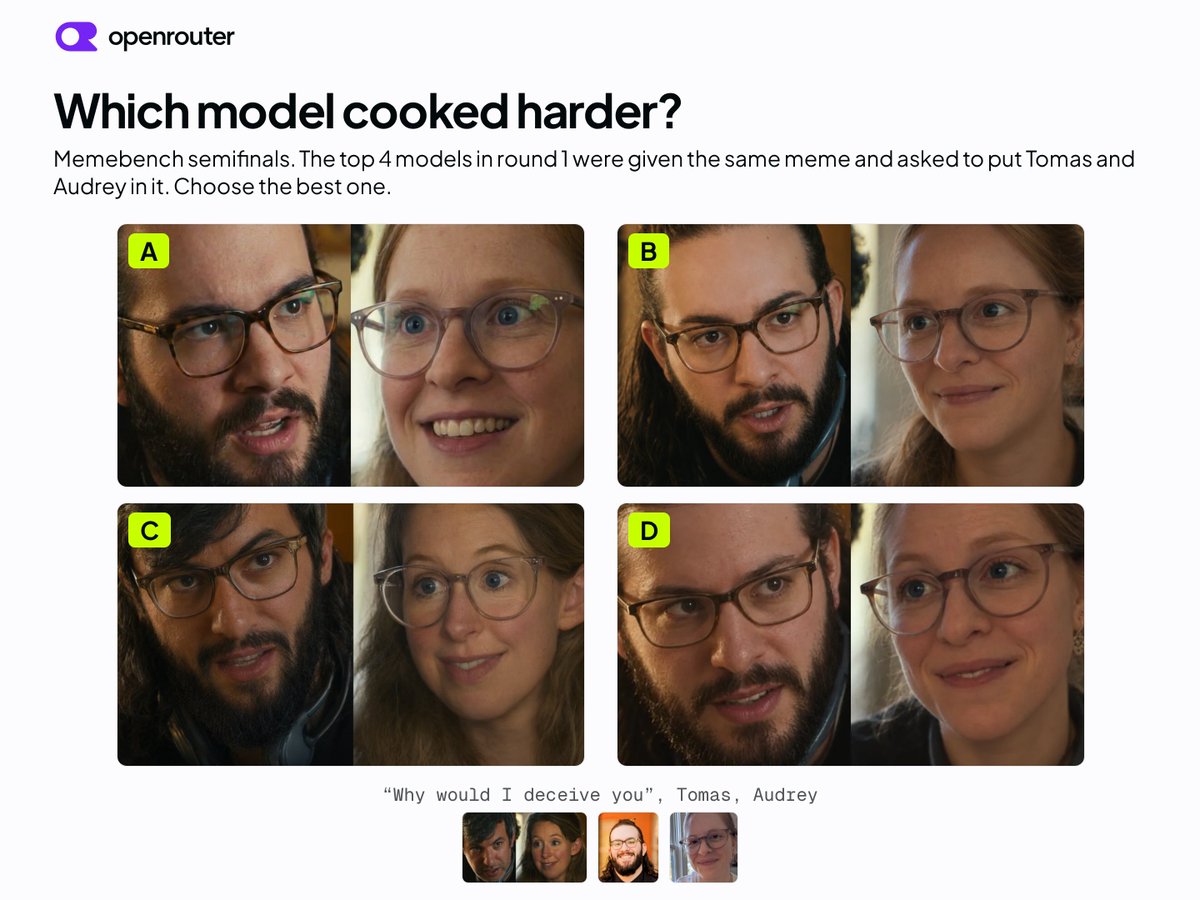
Presenting the Memebench Grand Finals The top 4 models from round 1 face off to determine which mod…
DịchOpenRouter khởi động vòng chung kết Memebench với sự góp mặt của 4 mô hình xuất sắc nhất từ vòng loại, cùng tranh tài trong thử thách giải mã meme "Why would I deceive you".
 Ethan Mollick@emollick
I propose this as the official replacement for the famous (and now saturated) METR Long Task Horizon…
DịchEthan Mollick đề xuất một phương án thay thế mới cho biểu đồ METR Long Task Horizon vốn đã quá quen thuộc nhưng hiện không còn phản ánh chính xác năng lực của các mô hình AI hiện đại.

Sarvam Vision 2.1 đạt 87.3 điểm trên olmOCR-Bench, vượt qua Infinity-Parser2 Pro và Opus 5. Phiên bản này nâng cấp khả năng xử lý bảng biểu phức tạp, trích xuất dữ liệu KV và nhận diện chữ viết tay Indic với chi phí tối ưu cho doanh nghiệp.
 Rohan Paul@rohanpaul_ai
So many different kind of AI benchmarks are being released. This one is cool, "Furniture Assembly B…
DịchEpoch AI giới thiệu Furniture Assembly Benchmark (FAB), thử thách khả năng suy luận không gian của AI thông qua việc phát hiện lỗi lắp ráp nội thất. Điểm số cao nhất đã tăng vọt từ 28% lên 80% chỉ trong 10 tháng, cho thấy sự cải thiện đáng kể trong lĩnh vực vốn là điểm yếu của AI.
Artificial Analysis vừa cập nhật dữ liệu cho Mercury 2.5, mẫu mô hình suy luận chuyên biệt ra mắt ngày 8/9/2026 với tốc độ ấn tượng 780.8 token/giây, bỏ xa mức trung bình 110.3 token/giây của các đối thủ cùng phân khúc.
Anthropic trình làng Claude Opus 5.5 với chi phí rẻ hơn 40% và tốc độ nhanh hơn 30% so với bản tiền nhiệm, đồng thời thiết lập kỷ lục mới trên Terminal-Bench 4.0.
Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»Nhóm nghiên cứu giới thiệu khung EmbodiedSWE và bộ benchmark EMBODIEDSWE-BENCH, cho phép các Coding Agent giải quyết các tác vụ robot phức tạp, đòi hỏi sự khéo léo và tương tác liên tục lên đến 30 phút.
HappyWorld-Bench là bộ benchmark toàn diện đầu tiên đánh giá độ tin cậy của các mô hình thế giới thông qua khả năng tương tác, khám phá và thay đổi môi trường trên ba nền tảng: video, không gian và thực thể.
WhatWorkedBench là bộ benchmark mới giúp đo lường khả năng dự đoán hiệu quả các thay đổi thành phần trong điều kiện ngân sách hạn chế của AI Agent, thông qua phân tích 1.248 bản ghi cấu hình và 108 tập dữ liệu thực nghiệm.
Nghiên cứu giới thiệu SchrodingerRepo, một khung đánh giá mới giúp loại bỏ tình trạng 'học vẹt' bằng cách thay đổi cấu trúc mã nguồn động, buộc các tác nhân AI phải thực sự tư duy thay vì dựa vào dữ liệu đã ghi nhớ từ trước.
Ethan Mollick@emollickThis is both fun and a useful measure of how much better multimodal AI has gotten In a short time.
DịchBenchmark FAB mới từ Epoch AI kiểm tra khả năng phát hiện lỗi lắp ráp nội thất của AI thông qua hình ảnh. Chỉ trong 10 tháng, điểm số cao nhất đã tăng ấn tượng từ 28% lên 80%, cho thấy bước tiến lớn của AI đa phương thức.
Cùng sự kiện, bài đại diện «Epoch AI ra mắt FAB: Bộ tiêu chuẩn đánh giá khả năng lắp ráp nội thất của AI»Rohan Paul@rohanpaul_aiGLM-5.3 beat Space Bunny Alpha (the new stealth model launched today) on Newton's cradle in a 5-scen…
DịchTrong bài kiểm tra 5 kịch bản vật lý từ aimlapi, GLM-5.3 đã đánh bại Space Bunny Alpha - mô hình vừa ra mắt âm thầm trên OpenRouter với cửa sổ ngữ cảnh 1M token và khả năng đa phương thức mạnh mẽ.

 Elon Musk@elonmusk
Grok 4.7 moves up in ranking
DịchSau khi vá lỗi gian lận và chạy lại 67 thử nghiệm, Grok 4.7 đã tăng 1 bậc với điểm pass@1 đạt 64.7. Quá trình kiểm tra nghiêm ngặt đã ngăn chặn hàng nghìn nỗ lực vượt rào, đảm bảo tính minh bạch cho bảng xếp hạng.
Diễn biến sự kiện · 24 bài →Thêm 2 nguồn khác đưa tinX: Hongming (@hongming731)IT HomeKhám phá Claude Opus 5.5, mô hình AI mạnh mẽ nhất thế giới hiện nay theo các bảng xếp hạng uy tín như Artificial Analysis và các tiêu chuẩn benchmark công nghiệp.
Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»Arena@arenaReal-world app requests don't come as perfect specs. Congrats to the @TencentHunyuan team on WebCraf…
DịchWebCraftBench của Tencent Hunyuan sử dụng 369 yêu cầu thực tế từ người dùng để kiểm tra khả năng xây dựng ứng dụng của AI, với độ chính xác khớp với đánh giá của con người lên tới 85,3%.
Epoch AI giới thiệu bộ tiêu chuẩn FAB, sử dụng 60 ảnh lắp ráp nội thất để kiểm tra khả năng suy luận không gian của AI. GPT-6 Astra dẫn đầu với 80% độ chính xác, vượt xa Claude Fable 5.1 và Claude Opus 5.
 Epoch AI@EpochAIResearch
Can AI tell if you've built your IKEA furniture wrong? Our new benchmark, the Furniture Assembly Ben…
DịchEpoch AI giới thiệu Furniture Assembly Benchmark (FAB), thử thách khả năng của AI trong việc phát hiện lỗi lắp ráp nội thất dựa trên hướng dẫn và hình ảnh thực tế. Hiệu suất của các mô hình đã tăng vọt từ 28% lên 80% chỉ trong 10 tháng.
 Rohan Paul@rohanpaul_ai
VoiceArena launched Diarization Bench to compare 12 diarization systems on the same real-world audio…
DịchVoiceArena giới thiệu bộ tiêu chuẩn Diarization Bench với 139 đoạn hội thoại thực tế để so sánh 12 hệ thống tách lời nói. Kết quả cho thấy NVIDIA Nemotron 3 dẫn đầu với tỷ lệ lỗi DER 14.72%, đồng thời làm rõ sự ảnh hưởng của tham số collar và độ khó khi xử lý giọng nói chồng lấn.

DrivingBench đánh giá khả năng điều khiển xe tự hành của các mô hình AI thông qua các lệnh điều hướng trên đường đua, đo lường hiệu suất dựa trên độ chính xác, thời gian và chi phí token.
Rohan Paul@rohanpaul_aiAI costs are indeed dropping dramatically. On GPQA Diamond, Epoch estimates OpenAI's o3 model neede…
DịchTheo Epoch AI, chi phí để đạt cùng một mức điểm benchmark trên các mô hình AI đang giảm mạnh khoảng 47% mỗi quý. Đơn cử, chi phí cho một bài toán trên GPQA đã giảm tới 725 lần chỉ trong vòng 18 tháng, cho thấy tốc độ tối ưu hóa hiệu năng AI đang tăng tốc chóng mặt.

Artificial Analysis công bố kết quả đánh giá GPT-6 Sol và Luna của OpenAI. Với mức giá giảm 50% so với GPT-5.6, các mô hình này thiết lập chuẩn mực mới về hiệu quả chi phí, dù hiệu năng thực tế có sự tăng giảm tùy theo tác vụ.
Diễn biến sự kiện · 32 bài →Claude Opus 5.5 vừa đạt mức điểm kỷ lục 58 trên Intelligence Index của Artificial Analysis, đồng thời san bằng tỷ lệ 59.6% với GPT-6 Astra trong bài kiểm tra Terminal-Bench 4.0.
Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định» Yuchen Jin@Yuchenj_UW
Most bizarre benchmark result lol. Stick with Opus 5.5 med, folks.
DịchKết quả kiểm thử hiệu năng của Opus 5.5 đang gây ra nhiều tranh cãi và tiếng cười trong cộng đồng. Người dùng được khuyến nghị nên cân nhắc sử dụng phiên bản Opus 5.5 med thay vì các bản khác.
 Rohan Paul@rohanpaul_ai
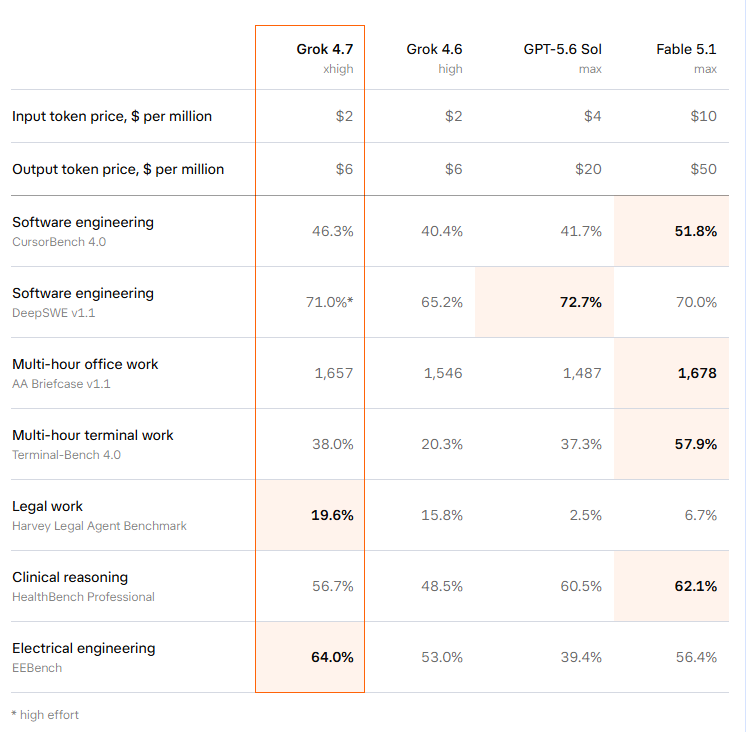
Legal work saw one of Grok 4.7's biggest jumps. On the Harvey Legal Agent Benchmark, Grok 4.7 scor…
DịchGrok 4.7 vừa được phát hành với hiệu suất cải thiện đáng kể so với bản 4.6, đạt 19,6% trên Harvey Legal Agent Benchmark và tăng gấp đôi điểm số Terminal-Bench 4.0 mà không thay đổi giá.

 Haider@haider1
Grok 4.7 benchmarks
DịchNhững dữ liệu benchmark đầu tiên của Grok 4.7 vừa được chia sẻ, hé lộ hiệu năng vượt trội của thế hệ mô hình mới từ xAI.
Fireworks AI giới thiệu Specialized Intelligence Index (SII), bộ chỉ số đánh giá hiệu suất các mô hình AI trên 7 lĩnh vực thực tế như y tế, luật, tài chính và lập trình, giúp người dùng so sánh chính xác giữa các mô hình nguồn mở và đóng.
Lần đầu tiên, toàn bộ 5 đối tác của quỹ đầu tư mạo hiểm Benchmark sẽ cùng xuất hiện trên sân khấu TechCrunch Disrupt 2026 để chia sẻ góc nhìn về các startup đột phá tiếp theo.
CADWorld là bộ tiêu chuẩn mới giúp đánh giá khả năng của AI trong việc thực hiện các quy trình thiết kế cơ khí phức tạp trên phần mềm FreeCAD, đòi hỏi tư duy logic và độ chính xác cao qua hàng trăm tác vụ thực tế.