Artificial Analysis vừa cập nhật dữ liệu cho Mercury 2.5, mẫu mô hình suy luận chuyên biệt ra mắt ngày 8/9/2026 với tốc độ ấn tượng 780.8 token/giây, bỏ xa mức trung bình 110.3 token/giây của các đối thủ cùng phân khúc.
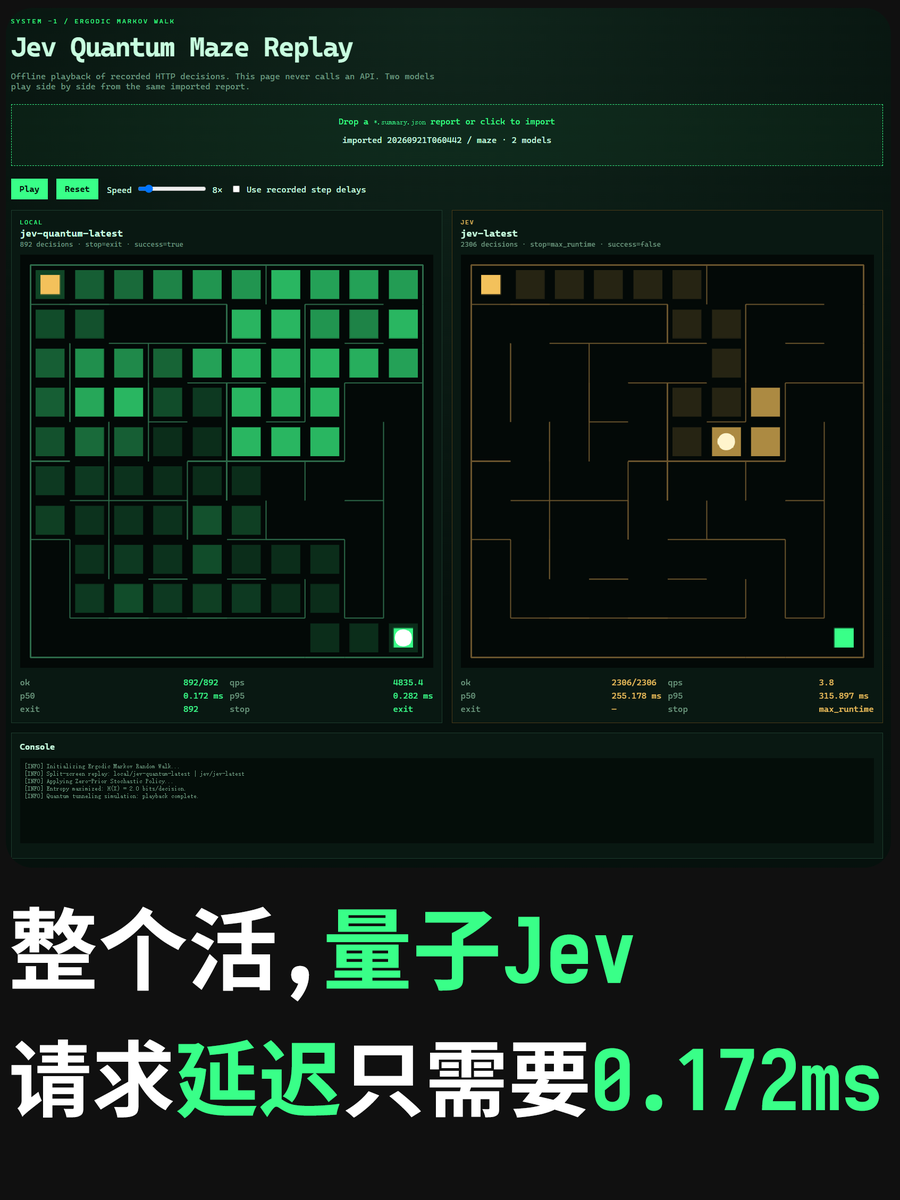
Tác giả công bố Quantum Jev với tốc độ suy luận nhanh gấp 400 lần bản gốc, đạt 0.12ms mỗi lượt. Dự án sẽ sớm được phát hành dưới giấy phép MIT, hứa hẹn giải quyết các bài toán mà Jev hiện tại chưa thể xử lý.
Zhipu vừa trình làng GLM-5.3-FlashX với tối ưu hóa hạ tầng vượt trội, đạt tốc độ 200 tokens/giây trên nền tảng 100.000 chip nội địa. Mẫu model này hứa hẹn hiệu năng mạnh mẽ nhất trong phân khúc cùng chi phí tối ưu, hiện đã sẵn sàng trên API.
1/ The fastest reasoning LLM is now live exclusively on OpenRouter. Mercury 2.5 Preview from @_ince…
DịchMercury 2.5 Preview vừa cập bến OpenRouter với khả năng tạo token song song, đạt tốc độ kỷ lục 1.107 token/giây, tối ưu hóa cho các tác vụ yêu cầu độ trễ cực thấp và xử lý JSON chính xác.
Nvidia's Groq 3 LPX system excels at fast decode of small models (>3, 400 tok/s), according to a @Art…
DịchNvidia giới thiệu hệ thống LPX sử dụng SRAM siêu tốc thay thế HBM, giúp đạt tốc độ giải mã ấn tượng hơn 3.400 token/giây cho các mô hình nhỏ như Gemma 2 2B. Công nghệ này hứa hẹn sẽ kết hợp cùng GPU để tối ưu hóa hiệu suất cho các mô hình AI quy mô lớn.
Probably one of the coolest interviews of the year: Tibo on Matthew Berman's show. And one of his f…
DịchTrong cuộc phỏng vấn với Matthew Berman, Tibo nhận định tốc độ suy luận 750 token/giây sẽ sớm trở thành mặc định. Khi AI chuyển dịch sang mô hình tác tử (agent), tốc độ vận hành sẽ trở thành yếu tố then chốt quyết định hiệu quả công việc thay vì chỉ dựa vào độ thông minh.