DịchChuyên gia Nathan Lambert đánh giá cao Claude Opus 5.5 khi đạt kết quả dẫn đầu với chi phí cực thấp ở thiết lập mặc định, đồng thời cải thiện tốc độ tạo văn bản nhanh hơn 30% so với thế hệ tiền nhiệm.
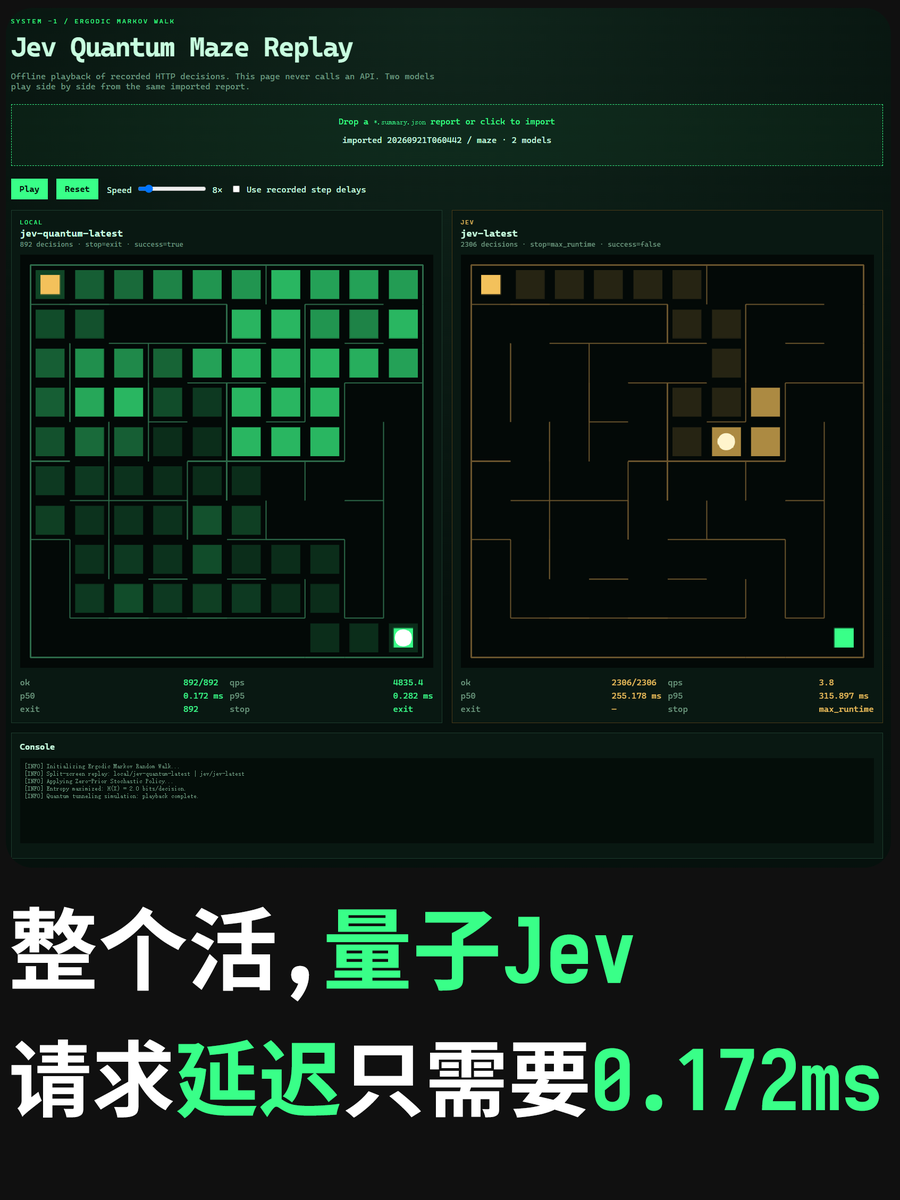
Tác giả công bố Quantum Jev với tốc độ suy luận nhanh gấp 400 lần bản gốc, đạt 0.12ms mỗi lượt. Dự án sẽ sớm được phát hành dưới giấy phép MIT, hứa hẹn giải quyết các bài toán mà Jev hiện tại chưa thể xử lý.
PrismML vừa phát hành Ternary Bonsai 2 27B, mô hình nén 3-giá trị chỉ nặng 5,93 GB nhưng vẫn duy trì 98,2% hiệu năng của bản gốc Qwen 27B, hỗ trợ đa phương thức và cửa sổ ngữ cảnh lên tới 262K token.
Sounds almost too good to be true. Jev is an AI model built for decisions rather than text generat…
DịchDiogo Almeida giới thiệu Jev, mô hình AI chuyên biệt cho việc ra quyết định thay vì tạo văn bản. Sử dụng phương pháp RLCD, Jev tối ưu hóa hiệu suất vượt trội với chi phí cực thấp, mở ra hướng đi mới cho các tác vụ điều khiển và chọn lọc dữ liệu.
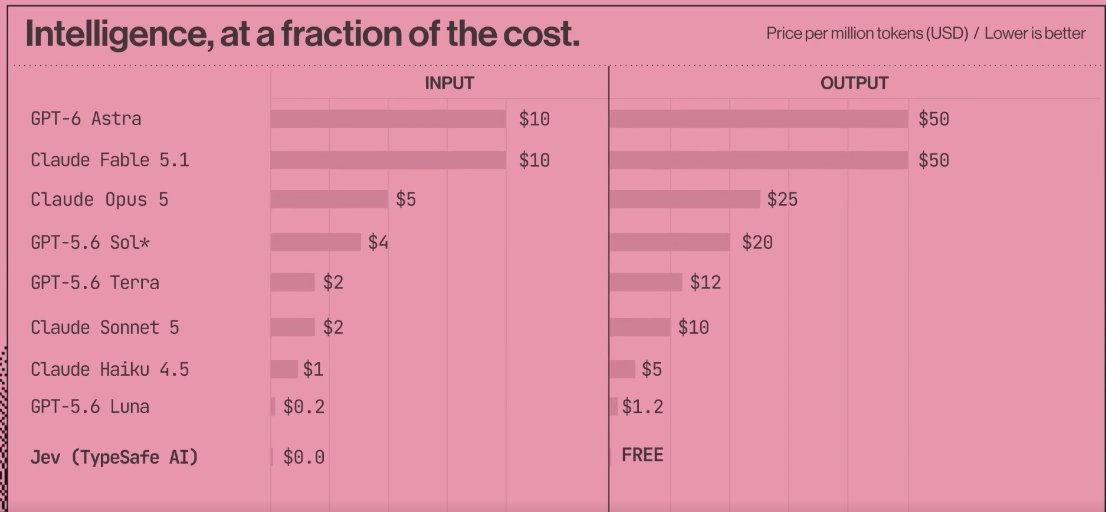
Typesafe.ai vừa ra mắt Jev, một mô hình AI đột phá với hiệu suất vượt trội về tốc độ và chi phí. Tuy nhiên, các thông số kỹ thuật chi tiết vẫn chưa được công bố, gây ra nhiều tranh luận trong cộng đồng công nghệ.
Ant Group vừa phát hành Qwen3.6-27B-singprobe trên HuggingFace, một mô hình dò tìm an toàn theo thời gian thực giúp đánh giá từng token với chi phí giải mã cực thấp, dưới 0,5%.
Inception vừa trình làng Mercury 2.5, mô hình ngôn ngữ khuếch tán lớn nhất và thông minh nhất của hãng với hiệu suất tăng 40% so với bản tiền nhiệm, sẵn sàng cạnh tranh với các đối thủ hàng đầu như GPT-5.6 Luna, Gemini 3.5 Flash-Lite và Claude Haiku 4.5.
TFO là giải pháp plug-and-play cho phép tích hợp khả năng hiểu âm thanh vào các mô hình VLM đóng băng mà không cần thay đổi kiến trúc hay huấn luyện lại, giúp bảo toàn nguyên vẹn năng lực suy luận thị giác ban đầu.
Vì sao đáng đọc: Giải pháp đột phá giúp tiết kiệm chi phí tính toán đáng kể khi tích hợp đa phương thức, giải quyết trực tiếp vấn đề 'quên lãng' năng lực cũ của các mô hình VLM hiện nay.
Alibaba Cloud giới thiệu Qwen3.8-Flash, mô hình AI tập trung vào hiệu suất cao với yêu cầu hạ tầng tối giản, mang lại kết quả ấn tượng chỉ trên một node duy nhất.
NeoMME là kiến trúc bộ mã hóa Transformer hai chiều nhỏ gọn, hỗ trợ đa ngôn ngữ và hình ảnh, giúp tối ưu hóa hiệu suất cho các tác vụ truy xuất tài liệu mà không cần dùng đến các mô hình ngôn ngữ tạo sinh cồng kềnh.
Muse Spark 1.3 vừa được phát hành với hiệu năng tiệm cận các mô hình tiên tiến nhất, nhưng sở hữu mức giá vận hành cực kỳ tối ưu, gần như không đáng kể.
Kỹ sư GitHub chia sẻ 4 chiến lược tối ưu hóa, từ việc nén dữ liệu đầu vào đến tinh chỉnh quy trình xử lý tác vụ, giúp giảm đáng kể chi phí suy luận mà vẫn đảm bảo hiệu suất lập trình.
Vì sao đáng đọc: Bài viết cung cấp các giải pháp kỹ thuật thực tế, có tính ứng dụng cao cho các nhà phát triển và doanh nghiệp đang tối ưu hóa chi phí triển khai AI.
Not Diamond just released the methodology behind their model routing which gets Opus xhigh quality w…
DịchNot Diamond giới thiệu phương pháp định tuyến mô hình mới, giúp đạt hiệu suất vượt trội so với Claude 3 Opus nhưng tiết kiệm từ 20-80% chi phí vận hành trên các tiêu chuẩn đánh giá chính.
GLM-5.3 dẫn đầu bảng xếp hạng Featherbench với tỷ lệ chính xác tuyệt đối, đánh bại các mô hình từ Anthropic và OpenAI với chi phí vận hành thấp hơn đáng kể.
DịchGoogle vừa ra mắt Gemini 3.7 Flash, đạt điểm số ấn tượng 95.5% trên ARC-AGI-1 với chi phí chỉ 0.12 USD mỗi tác vụ, vượt trội hoàn toàn về hiệu suất so với các mô hình hiện nay.
Elon Musk chia sẻ Grok 4.6 đã hoàn thành tác vụ tương tự Fable chỉ trong 84 phút với 8,6 triệu token, giúp tiết kiệm chi phí xuống còn 55 USD, chỉ bằng 1/10 so với phương pháp cũ.
 Nathan Lambert@natolambert