Thủ thuật
Artificial Analysis đánh giá GPT-6 Sol và Luna: Chi phí giảm một nửa, hiệu năng biến động
(giờ Việt Nam)
Tóm tắt AI
Artificial Analysis vừa công bố đánh giá về hai model GPT-6 Sol và Luna với mức giá chỉ bằng một nửa so với bản tiền nhiệm, mở ra chuẩn mực mới về hiệu quả chi phí cho người dùng.
Bản dịch AI
GPT-6 Sol và Luna thúc đẩy giới hạn hiệu quả chi phí bằng cách giảm một nửa chi phí so với GPT-5.6 Sol và Luna. Điểm số trên Intelligence Index và Coding Agent Index vẫn ngang bằng với GPT-5.6, với sự tiến bộ ở một số bài đánh giá và sự suy giảm ở một số bài khác.
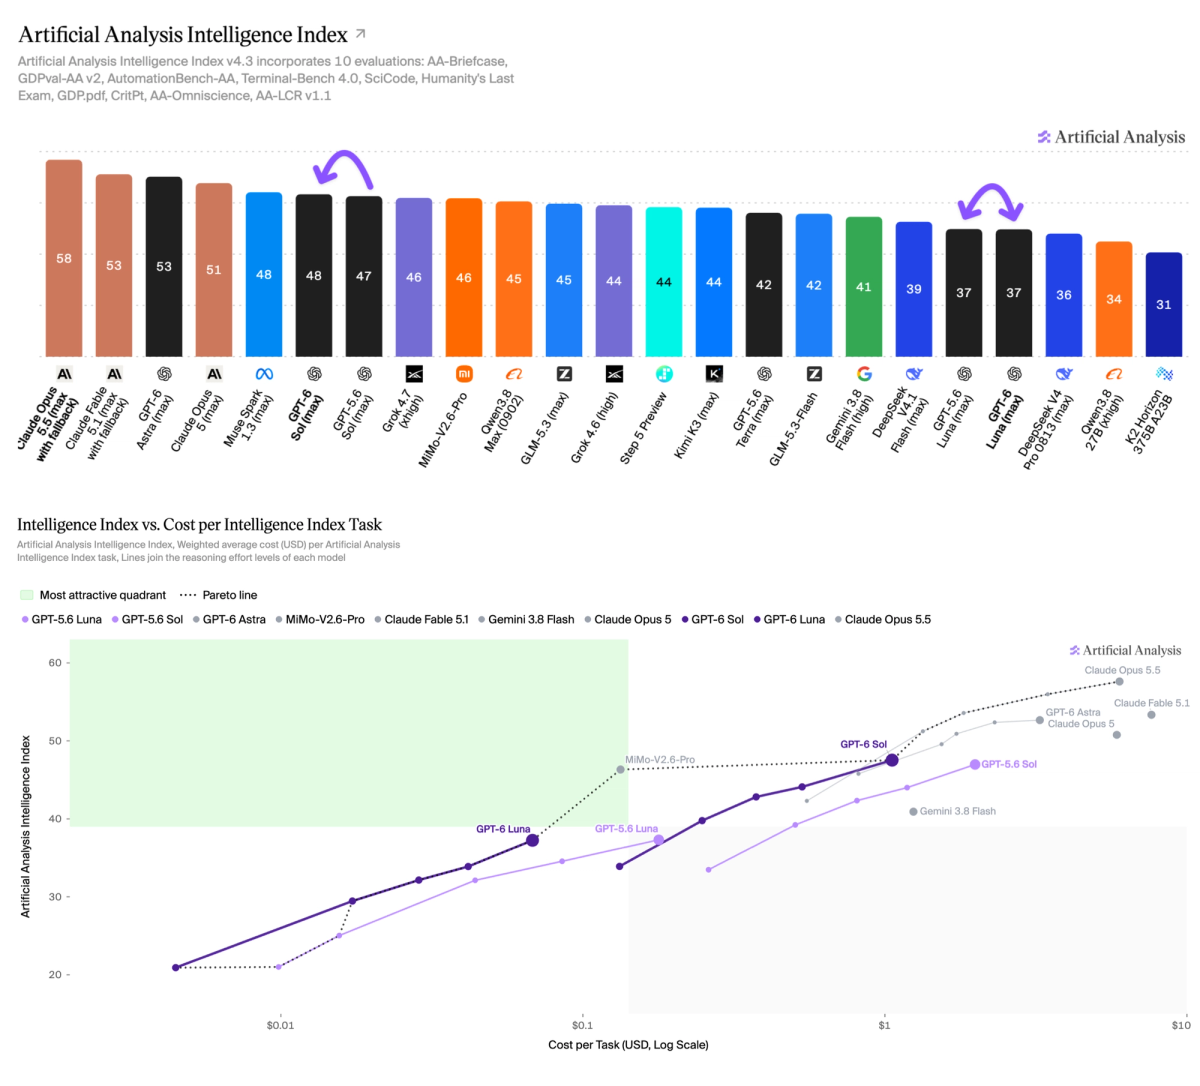
Giá thành thấp hơn khoảng một nửa so với GPT-5.6: Sol giảm từ $4/$20 xuống còn $2/$10 trên mỗi triệu token đầu vào/đầu ra, và Luna giảm từ $0.20/$1.20 xuống còn $0.10/$0.50, với cùng mức chiết khấu 90% cho đọc bộ nhớ đệm (cache reads) và phụ phí 25% cho ghi bộ nhớ đệm (cache writes).
Các điểm chính:
➤ Giảm một nửa chi phí trên mỗi tác vụ: GPT-6 Sol (max) tốn $1.06 mỗi tác vụ để chạy Artificial Analysis Intelligence Index, thấp hơn khoảng 50% so với GPT-5.6 Sol (max) ở mức $1.99. GPT-6 Luna (max) tốn $0.07 mỗi tác vụ, thấp hơn khoảng 60% so với GPT-5.6 Luna (max) ở mức $0.18. Điều này đạt được nhờ việc cắt giảm giá, vì cả hai mô hình đều sử dụng lượng token đầu ra trên mỗi tác vụ nhiều hơn một chút (31k so với 29k đối với Sol, và 51k so với 41k đối với Luna). Hai bản phát hành này cho phép OpenAI chiếm lĩnh một phần đáng kể trên đường biên Pareto về hiệu quả chi phí.
➤ Trong Coding Agent Index, Sol cải thiện nhưng Luna suy giảm: Trong bộ công cụ Codex của OpenAI, GPT-6 Sol (max) đạt 57 điểm trên Artificial Analysis Coding Agent Index, tăng 2 điểm so với GPT-5.6 Sol (max), với những cải thiện ở Terminal-Bench 4.0 (43% so với 37%) và SWE-Atlas-QnA (58% so với 54%). Với mức giá $2.99 mỗi tác vụ, nó rẻ hơn khoảng 50% so với GPT-5.6 Sol (max) và nằm trên đường biên Pareto của Coding Agent Index so với Chi phí trên mỗi tác vụ. GPT-6 Luna (max) đạt 41 điểm, giảm 2 điểm so với GPT-5.6 Luna (max), với điểm số thấp hơn ở SWE-Atlas-QnA (44% so với 49%) và DeepSWE v1.1 (64% so với 66%), với chi phí trên mỗi tác vụ thấp hơn khoảng 60%.
➤ Giảm đáng kể tình trạng ảo tưởng (hallucination): Cả hai mô hình đều ít ảo tưởng hơn trong AA-Omniscience, tiêu chuẩn đánh giá về kiến thức và ảo tưởng của chúng tôi. GPT-6 Sol (max) cắt giảm tỷ lệ ảo tưởng từ 92% xuống 60% và GPT-6 Luna (max) từ 93% xuống 77%. Sol đạt được điều này bằng cách từ chối trả lời thường xuyên hơn: nó cố gắng trả lời 83% câu hỏi so với 99% của GPT-5.6 Sol (max), điều này giúp giảm khoảng 1/4 số câu trả lời sai nhưng cũng làm giảm độ chính xác 5 điểm, từ 59% xuống 54%. Độ chính xác của Luna nhìn chung không thay đổi ở mức 44% so với 43% trong khi nó trả lời ít câu hỏi hơn. Trên AA-Omniscience Index, Sol cải thiện từ 22 lên 27 và Luna từ -10 lên 1.
➤ Sự kết hợp giữa cải thiện và suy giảm trên các bài đánh giá: Ngoài AA-Omniscience, cả hai mô hình đều cải thiện trong AutomationBench-AA (Sol 62% so với 60%, Luna 53% so với 50%) và Terminal-Bench 4.0 (Sol 44% so với 40%, Luna 13% so với 12%). Tuy nhiên, chúng tôi quan sát thấy sự suy giảm trong hai bài đánh giá công việc tri thức quan trọng. Trong GDPval-AA v2.1, tiêu chuẩn đánh giá của chúng tôi được điều chỉnh từ tập dữ liệu của OpenAI về các tác vụ có giá trị kinh tế trên 44 ngành nghề, Sol giảm khoảng 100 điểm Elo và Luna giảm khoảng 75 điểm. Luna cũng giảm khoảng 45 điểm Elo trong AA-Briefcase v1.1, trong khi Sol giữ nguyên. AA-Briefcase v1.1 là một bài đánh giá riêng tư trên các dự án công việc tri thức kéo dài nhiều tuần, với hàng ngàn tệp đầu vào. Nhóm của chúng tôi đã kiểm tra thủ công hàng trăm kết quả đầu ra của mô hình: sự suy giảm có xu hướng bắt nguồn từ chất lượng trình bày bị giảm sút và các sản phẩm bàn giao thiếu các yếu tố theo tiêu chí đánh giá.
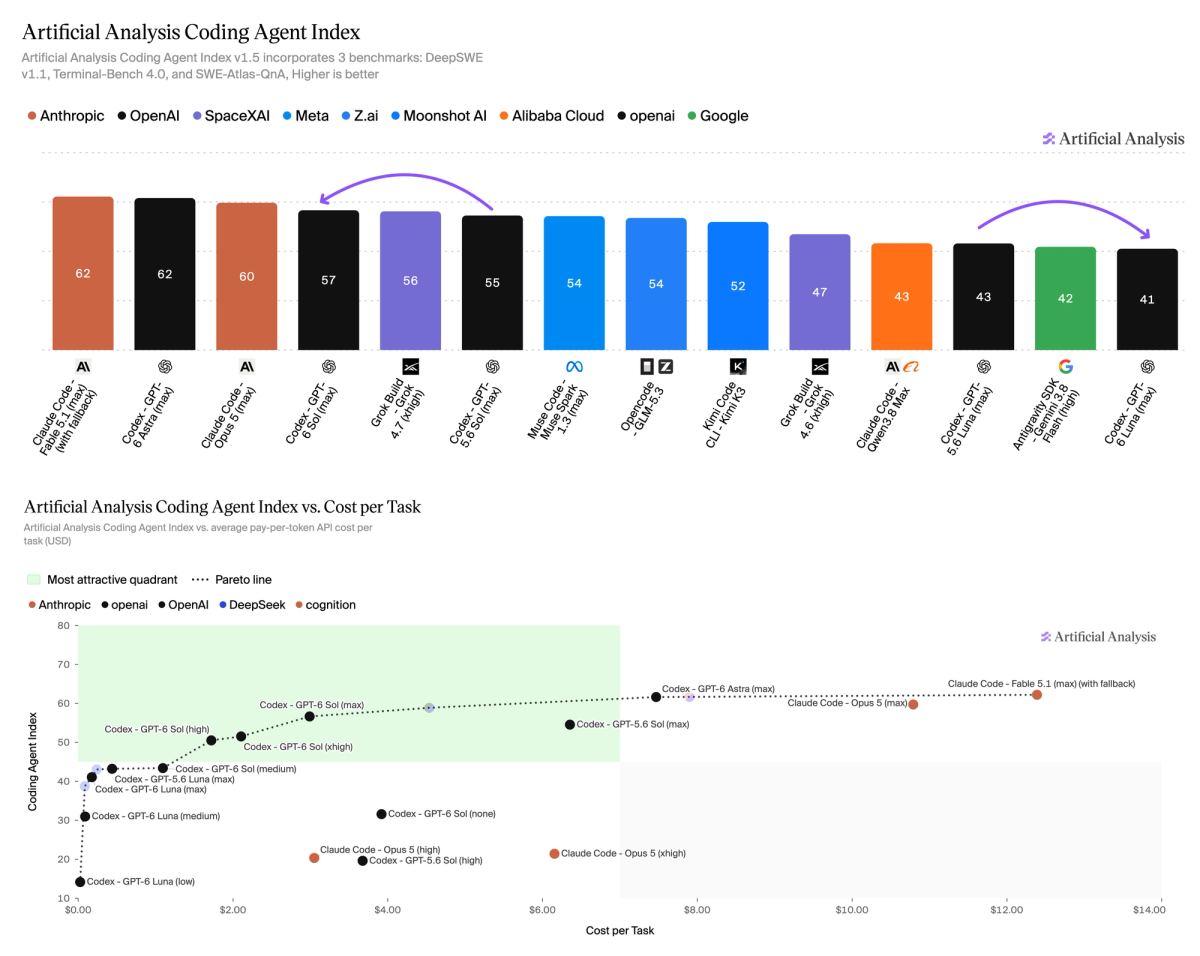
GPT-6 Sol (max) tăng 2 điểm trong Artificial Analysis Coding Agent Index với chi phí trên mỗi tác vụ chỉ bằng một nửa so với phiên bản tiền nhiệm, trong khi GPT-6 Luna (max) giảm 2 điểm.
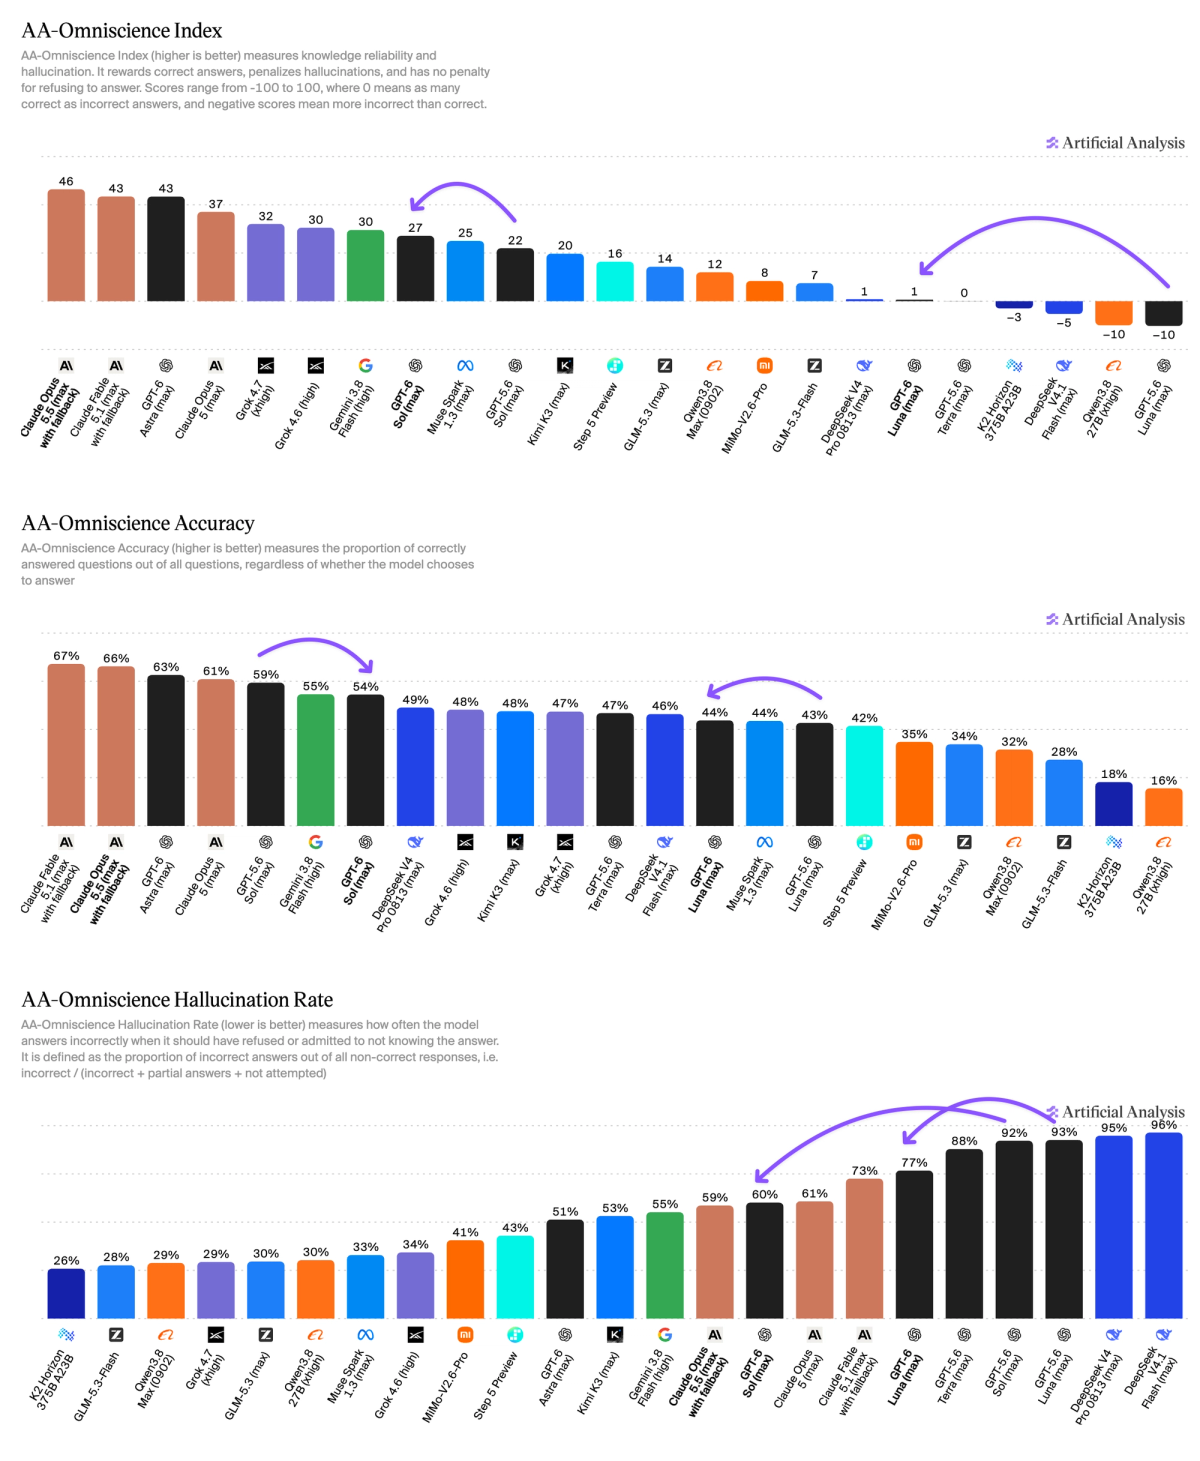
Cả GPT-6 Sol và Luna đều ít ảo tưởng hơn so với các phiên bản tiền nhiệm ở mức nỗ lực tối đa.
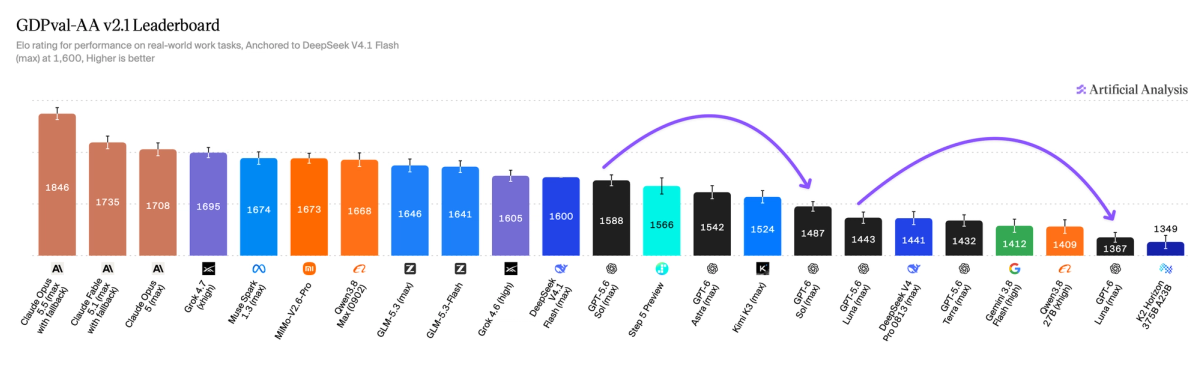
Cả hai mô hình đều suy giảm trong GDPval-AA v2.1 ở mức nỗ lực tối đa, do các sản phẩm bàn giao ngắn hơn và thường xuyên bỏ sót các yếu tố bắt buộc.
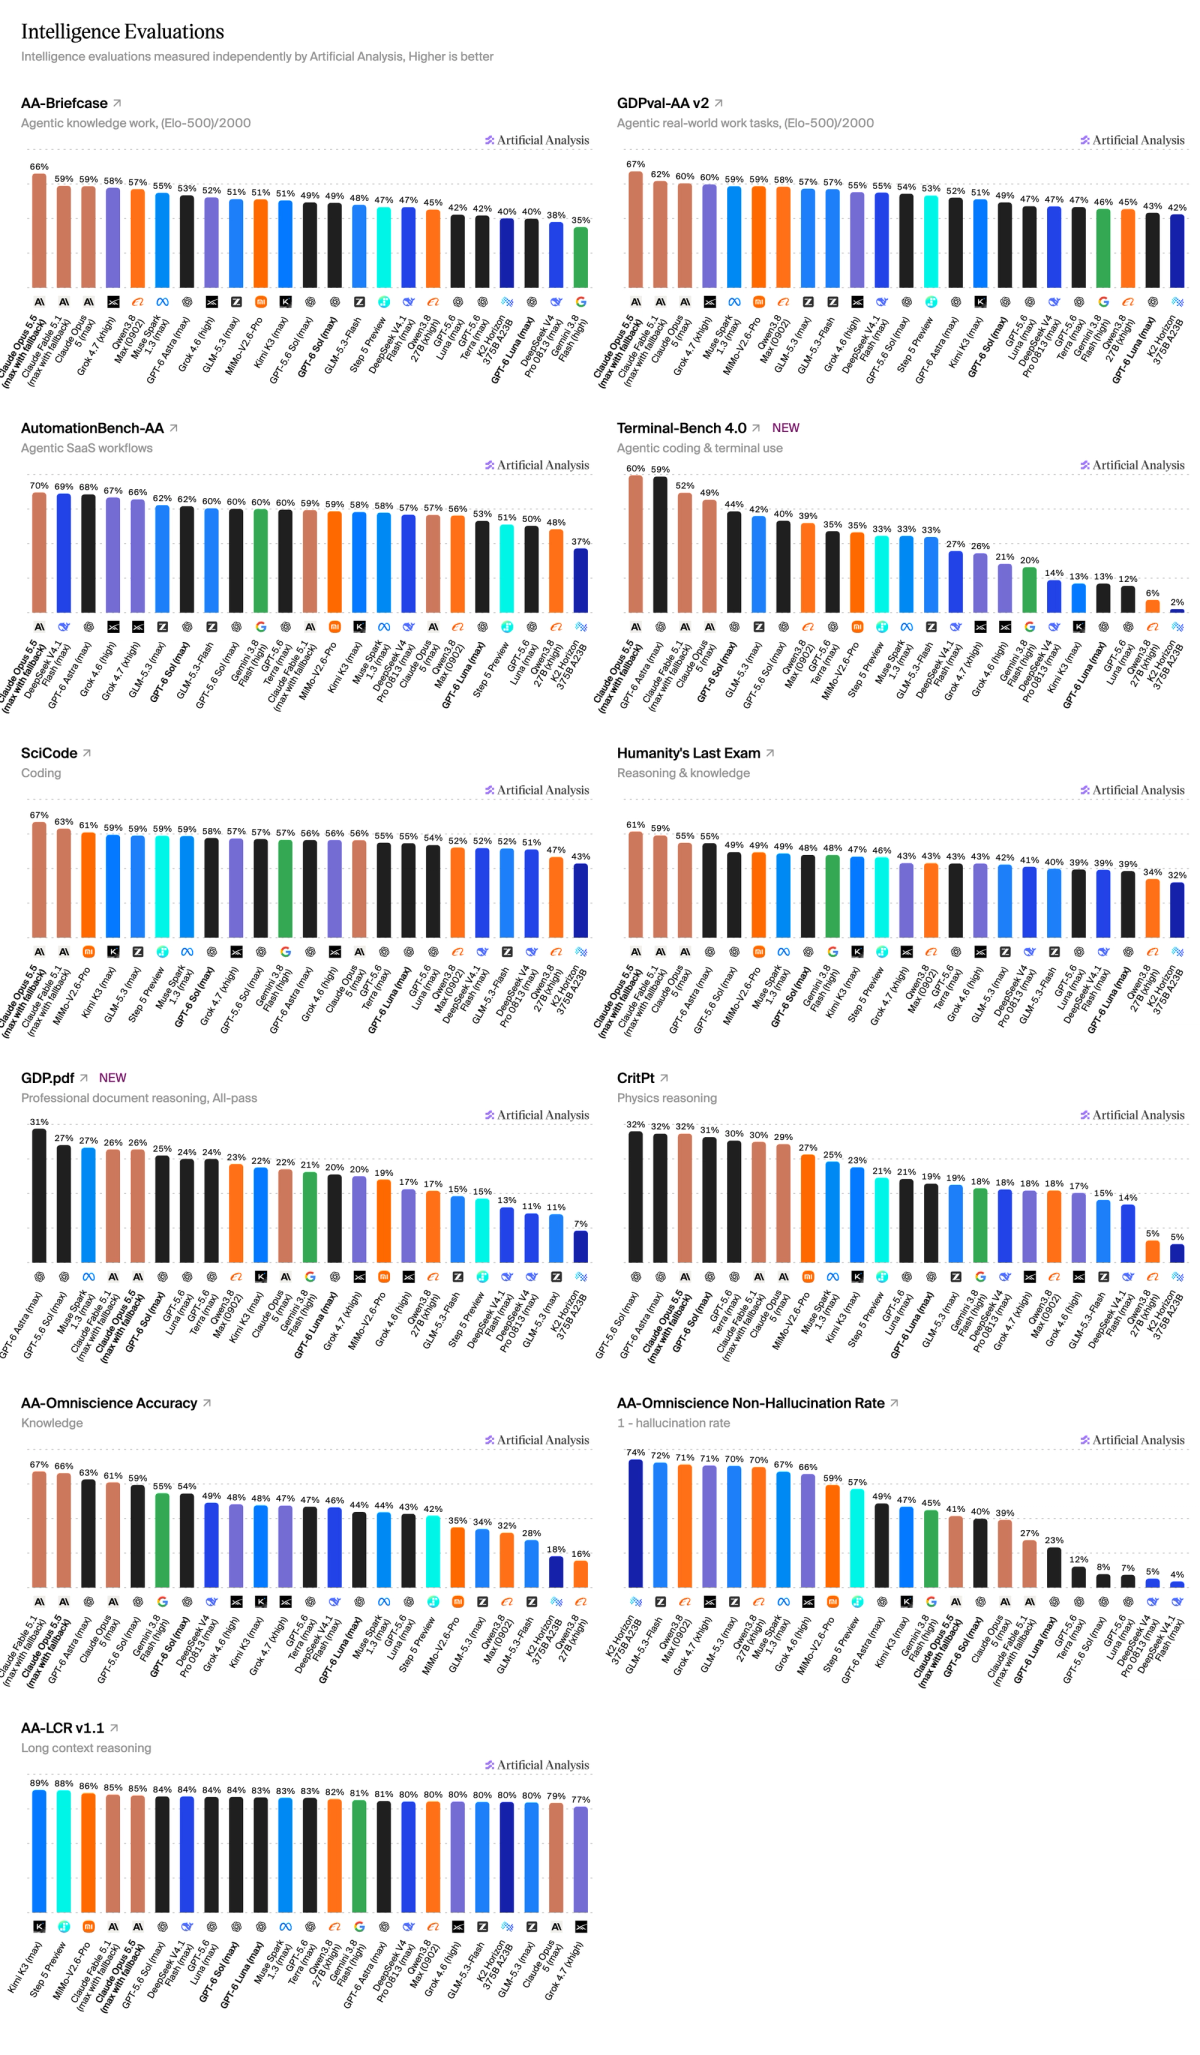
Phân tích chi tiết các bài đánh giá riêng lẻ trong Artificial Analysis Intelligence Index v4.3
So sánh GPT-6 Sol và Luna với các mô hình hàng đầu khác tại: www.artificialanalysis.ai
Bài viết được AI dịch và tổng hợp tự động từ Artificial Analysis (Web). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.