Thủ thuật
Claude Opus 3.5 soán ngôi đầu bảng xếp hạng Artificial Analysis với 58 điểm
(giờ Việt Nam)
Tóm tắt AI
Claude Opus 3.5 chính thức dẫn đầu chỉ số thông minh của Artificial Analysis với 58 điểm, đồng thời đạt hiệu suất ngang ngửa GPT-6 Astra trong bài kiểm tra Terminal-Bench 4.0.
Bản dịch AI
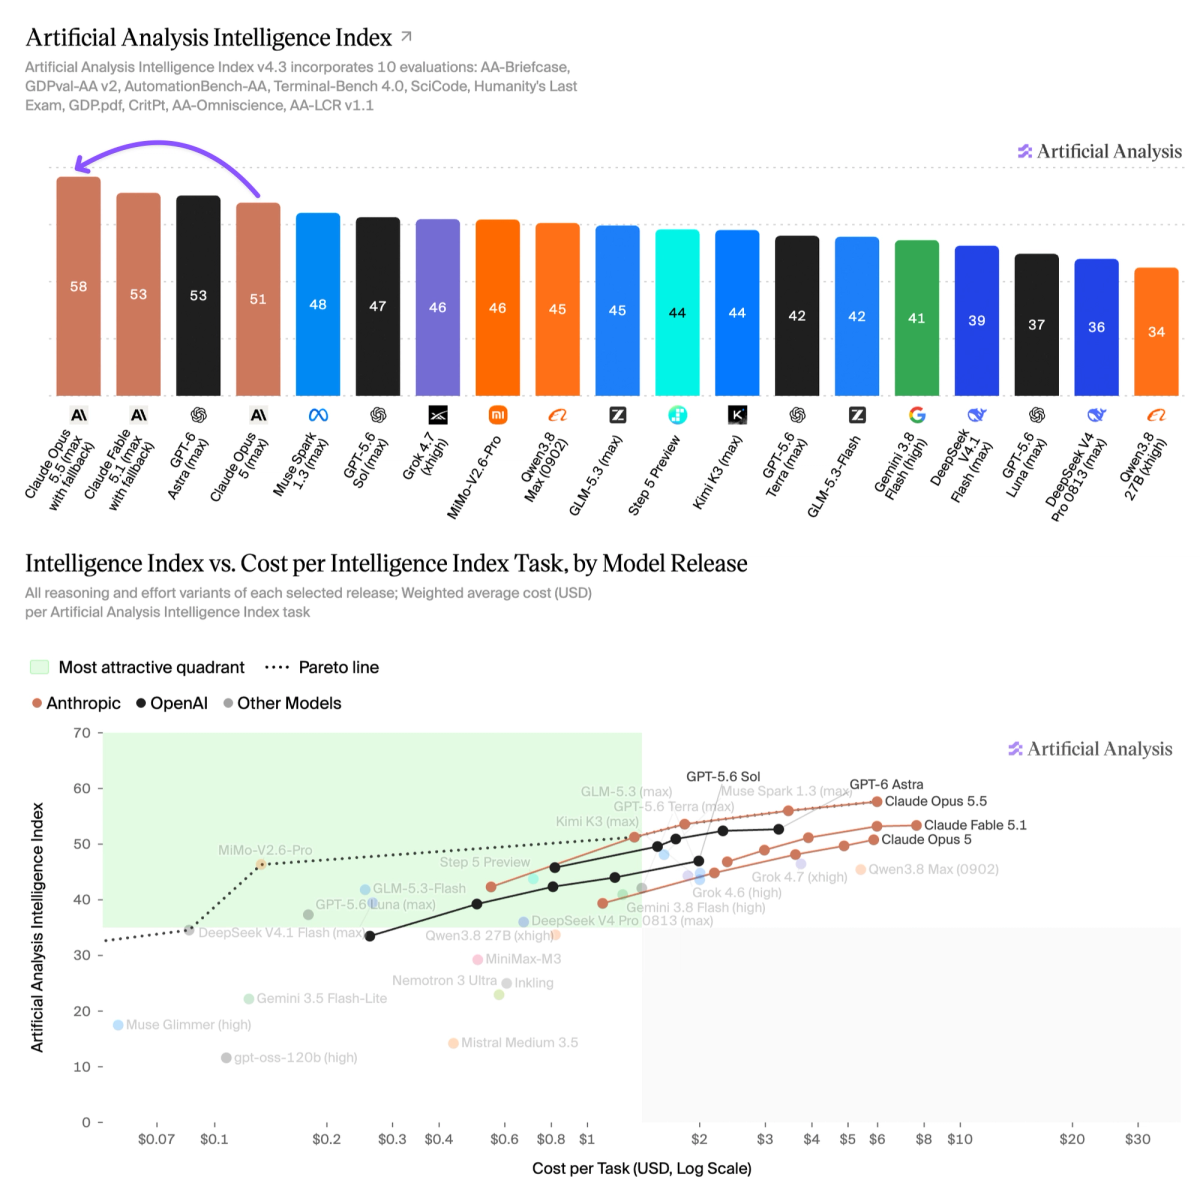
Claude Opus 5.5 vươn lên vị trí dẫn đầu trên bảng xếp hạng Artificial Analysis Intelligence Index, đi kèm với mức giảm giá 20% và ưu đãi lớn hơn cho cache hit.
Claude Opus 5.5 giúp Anthropic đạt thế cân bằng với GPT-6 Astra trên các bài đánh giá như Terminal-Bench 4.0 và AutomationBench-AA, đồng thời nới rộng khoảng cách dẫn đầu của Anthropic trong lĩnh vực tác vụ tri thức mang tính đại lý (agentic knowledge work).
Ở mức nỗ lực tối đa (max effort), mô hình đạt 58 điểm trên Artificial Analysis Intelligence Index, số điểm cao nhất mà chúng tôi từng ghi nhận được, vượt xa các mô hình khác vài điểm. Anthropic đã giảm giá Opus xuống còn 4 USD/20 USD cho mỗi 1 triệu token đầu vào/đầu ra (Opus 5 là 5 USD/25 USD) và giảm giá đọc cache từ 0,50 USD xuống còn 0,20 USD.
Những điểm chính:
➤ Hiệu suất mạnh mẽ ổn định, dẫn đầu về điểm số trên sáu trong số mười bài đánh giá của Intelligence Index: Humanity's Last Exam 61,4% (kỷ lục cũ là 59,1%, thuộc về Claude Fable 5.1), SciCode 66,9% (63,1%, Fable 5.1), GDPval-AA v2.1, AA-Briefcase v1.1, AA-Omniscience và AutomationBench-AA. Trên Terminal-Bench 4.0, mô hình đạt 59,6%, ngang bằng với mô hình dẫn đầu GPT-6 Astra (xhigh) và cao hơn 11 điểm so với Opus 5. Mô hình vẫn xếp sau ở các bài đánh giá CritPt, AA-LCR và GDP.pdf.
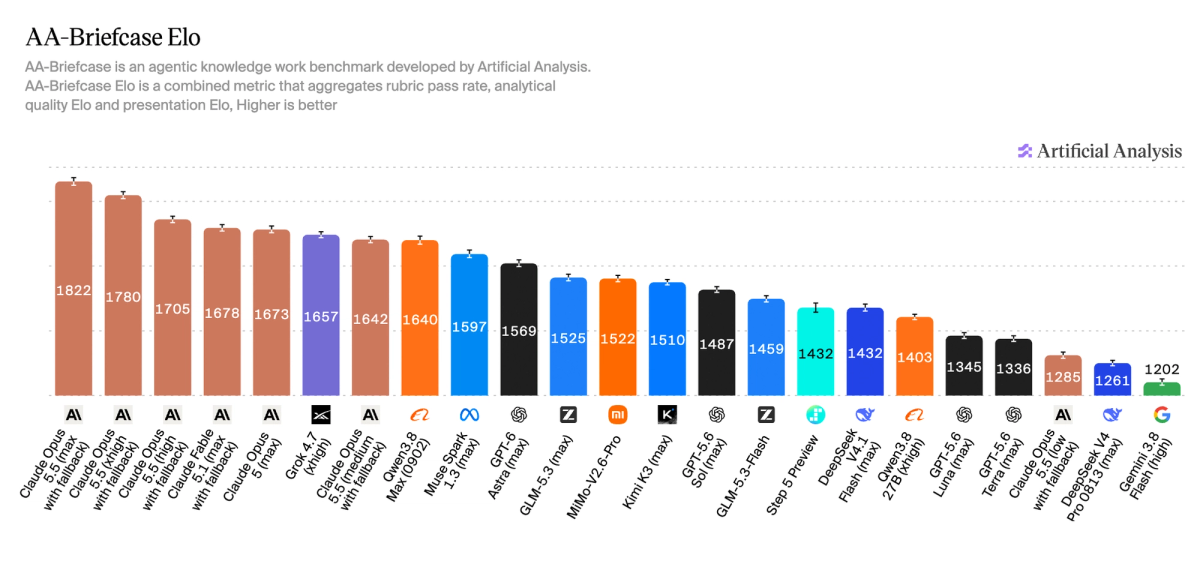
➤ Dẫn đầu trong tác vụ tri thức mang tính đại lý: Trên AA-Briefcase, bài đánh giá nội bộ về tác vụ tri thức tiên phong của chúng tôi, mô hình đạt Elo 1822. Con số này cao hơn 143 điểm so với Fable 5.1, vượt trội cả về chất lượng phân tích lẫn trình bày, và đây là lần đầu tiên Anthropic đạt chất lượng trình bày vượt qua GPT-5.6 Sol. Bài đánh giá này kiểm tra khả năng tạo ra các kết quả chuyên môn chính xác và trình bày tốt của các mô hình thông qua việc sử dụng Stirrup, bộ công cụ đại lý tham chiếu mã nguồn mở của chúng tôi.
➤ Ngang bằng với Opus 5 về chi phí trên mỗi tác vụ mặc dù số lượng token đầu ra gấp 1,6 lần: Opus 5.5 (max) sử dụng khoảng 119 nghìn token đầu ra cho mỗi tác vụ Intelligence Index, so với khoảng 73 nghìn của Opus 5 (max), khoảng 78 nghìn của Fable 5.1 (max) và khoảng 27 nghìn của GPT-6 Astra (max).
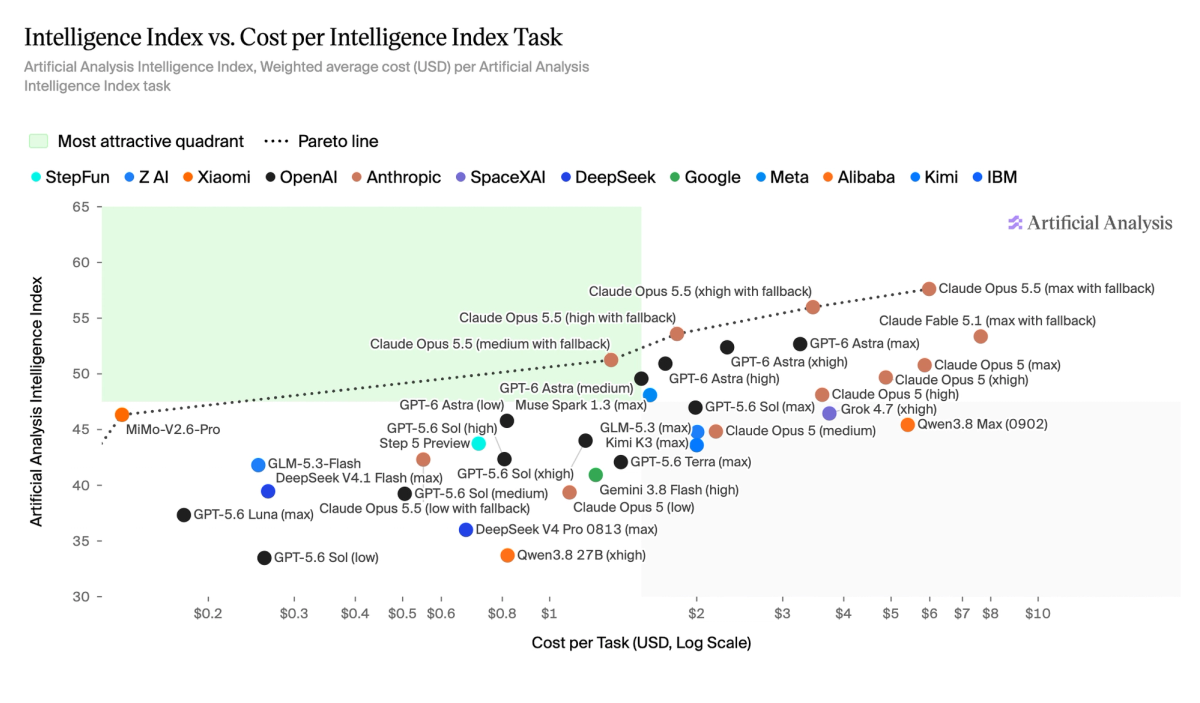
➤ Bốn trong năm mức nỗ lực nằm trên đường biên Intelligence vs Cost per Task: Opus 5.5 các mức max, xhigh, high và medium đều nằm trên đường biên Pareto, có chi phí thấp hơn hoặc hiệu suất vượt trội so với các mô hình khác đạt từ 50 điểm trở lên (GPT-6 Astra, Claude Fable 5.1 và Claude Opus 5).
Các chi tiết khác về mô hình:
➤ Cửa sổ ngữ cảnh: 1 triệu token với khả năng hỗ trợ đầu vào hình ảnh và văn bản, không thay đổi so với Opus 5.
➤ Giá cả: 4 USD/20 USD cho mỗi 1 triệu token đầu vào/đầu ra, giảm 20% so với mức 5 USD/25 USD của Opus 5. Ghi cache có giá 5 USD cho mỗi 1 triệu token với thời gian TTL 5 phút, giảm từ 6,25 USD. Đọc cache đã được giảm giá thêm xuống còn 0,20 USD cho mỗi 1 triệu token, giảm 60% so với mức 0,50 USD của Opus 5. Đây là mức giảm giá 95% so với giá đầu vào không sử dụng cache, tăng từ mức 90% trên các thế hệ Opus trước đó.
➤ Thiết lập mức nỗ lực: Năm thiết lập mức nỗ lực (low, medium, high, xhigh và max). Các bài đánh giá Intelligence Index đã được thực hiện trên cả năm mức với tính năng fallback mặc định của Anthropic được kích hoạt.
Bốn trong năm mức nỗ lực của Claude Opus 5.5 nằm trên đường biên Intelligence vs Cost per Task: Opus 5.5 các mức max, xhigh, high và medium đều nằm trên đường biên Pareto, có chi phí thấp hơn hoặc hiệu suất vượt trội so với các mô hình khác đạt từ 50 điểm trở lên.
Claude Opus 5.5 (max) là mô hình có hiệu suất hàng đầu trong tác vụ tri thức mang tính đại lý. Nó dẫn đầu bài đánh giá AA-Briefcase v1.1 với 1.822 Elo (+143 so với Fable 5.1) và GDPval-AA v2.1 với 1.846 Elo (+111 so với Claude Fable 5.1, +138 so với Claude Opus 5). Trên AA-Briefcase, mô hình dẫn đầu về các điểm thành phần chất lượng phân tích và trình bày, đồng thời chỉ xếp sau Fable 5.1 ở điểm số dựa trên tiêu chí (rubric-based scoring).
Để biết thêm chi tiết và các kết quả benchmark của Claude Opus 5.5, vui lòng xem tại https://artificialanalysis.ai/models/claude-opus-5-5
Bài viết được AI dịch và tổng hợp tự động từ Artificial Analysis (Web). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.