Thủ thuật
Anthropic hướng dẫn cách tính toán và tối ưu chi phí cho tác vụ trên Claude Code với Opus 5.5
(giờ Việt Nam)
Tóm tắt AI
Anthropic chia sẻ cách kiểm soát chi phí khi dùng Claude Code trên Opus 5.5, với mức giảm giá 20% cho token đầu vào/đầu ra và 60% cho cache read, giúp người dùng tối ưu hóa ngân sách hiệu quả hơn.
Bản dịch AI
Chi phí của một tác vụ và chi phí cho việc thực hiện lại
Bạn không đặt mục tiêu mua hàng triệu token. Bạn đặt mục tiêu xây dựng một tính năng, hoàn thành một quá trình di chuyển dữ liệu (migration) hoặc chạy một tác vụ. Số lượng token là bất cứ thứ gì mô hình cần để đạt được mục tiêu đó.
Hai mô hình có cùng chi phí trên mỗi token có thể có mức giá rất khác nhau cho cùng một tác vụ. Một mô hình đọc mã nguồn một lần. Mô hình kia đọc mã, thử sửa lỗi và đọc lại lần nữa. Mỗi bước đó là một lượt (turn), và mỗi lượt sẽ gửi lại toàn bộ nội dung cuộc hội thoại tính đến thời điểm đó. Vì vậy, mô hình cần nhiều lượt hơn sẽ tốn kém hơn, ngay cả khi có cùng mức giá.
Đến cuối bài viết này, bạn sẽ có thể trả lời ba câu hỏi về công việc của chính mình:
Sự đánh đổi mà tôi muốn chia sẻ ngay từ đầu là mọi cách để tiêu tốn ít token hơn cũng có thể khiến bạn phải trả giá bằng một tác vụ chưa hoàn thành. Nỗ lực thấp hơn, một mô hình nhỏ hơn hoặc ít ngữ cảnh hơn chắc chắn có thể tiết kiệm token. Tuy nhiên, một lần thực hiện lại (retry) còn tốn kém hơn cả những khoản tiết kiệm đó. Bài viết này cố gắng định giá cho từng sự đánh đổi.
Một số con số ở đây là giá niêm yết, và một số là các ví dụ minh họa được xây dựng từ đó. Các số liệu có tính tương tác, vì vậy hãy thay đổi dữ liệu đầu vào khi bạn đọc. Đây là những minh họa mang tính nỗ lực tốt nhất, vì vậy hãy nhớ kiểm tra tài liệu của chúng tôi và các phép tính của riêng bạn.
Một tác vụ tốn bao nhiêu chi phí?
Một tác vụ trong Claude Code là một vòng lặp. Mô hình đọc cuộc hội thoại, gọi một công cụ, đọc kết quả và tiếp tục vòng lặp cho đến khi hoàn thành. Mỗi vòng lặp là một yêu cầu (request). Bốn yếu tố quyết định chi phí của vòng lặp đó.
Số lượt (Turns). Mỗi lượt gửi lại toàn bộ cuộc hội thoại tính đến thời điểm đó. Ít lượt hơn đồng nghĩa với việc xử lý ít dữ liệu đầu vào hơn.
Đọc từ bộ nhớ đệm (Cache reads). Phần lớn những gì một lượt gửi lại là văn bản mà mô hình đã thấy ở lượt trước. Nó được tính phí như một lần đọc từ bộ nhớ đệm, với một phần nhỏ giá của dữ liệu đầu vào.
Loại token đầu ra. Đây là loại token đắt nhất, với giá gấp năm lần giá đầu vào. Quá trình suy luận (thinking) được tính phí như đầu ra, vì vậy một mô hình suy luận ít hơn để đưa ra câu trả lời sẽ tốn ít chi phí hơn.
Mô hình. Mỗi mô hình có giá riêng, được liệt kê trên trang bảng giá, vì vậy mô hình bạn chọn sẽ quyết định giá của mỗi token.
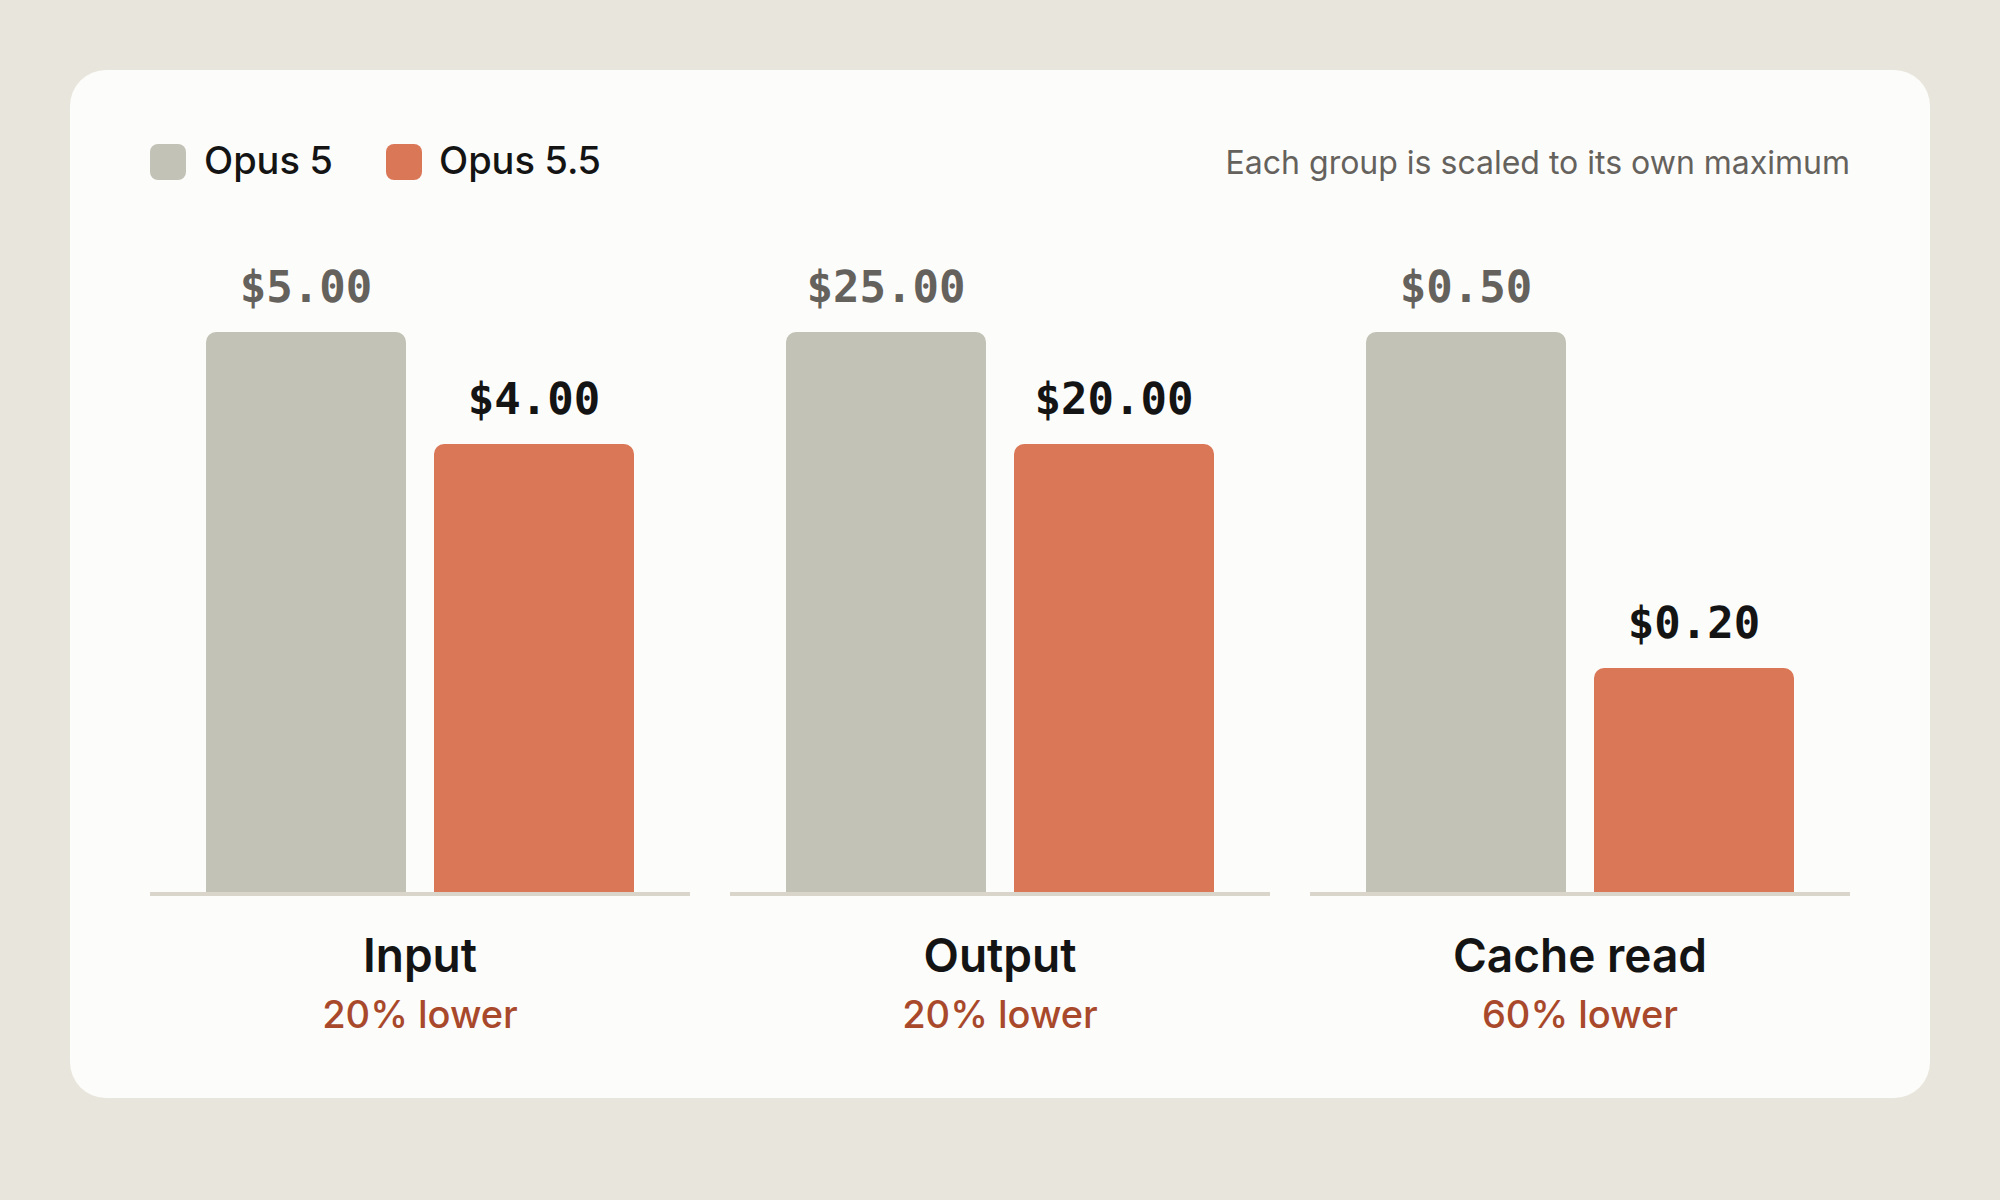
Các ví dụ của chúng tôi sử dụng giá niêm yết API của Opus 5.5: 4 USD cho mỗi triệu token đầu vào, 20 USD cho mỗi triệu token đầu ra và 0,20 USD cho mỗi triệu token đọc từ bộ nhớ đệm. Giống như máy tính ở phần dưới, các ví dụ tính phí đầu vào được lưu trong bộ nhớ đệm theo giá đọc và mọi thứ khác theo giá đầu vào, đồng thời không tính phí ghi vào bộ nhớ đệm. Số lượng token chỉ mang tính minh họa.
Số lượt (Turns)
Giả sử một tác vụ bắt đầu với 20K token ngữ cảnh và tăng lên 120K khi mô hình đọc các tệp và kết quả từ công cụ. Với 40 lượt, trung bình mỗi lượt gửi khoảng 70K token. Đó là khoảng 2,8 triệu token đầu vào cho tác vụ, mặc dù cuộc hội thoại chưa bao giờ vượt quá 120K. Với 90% dữ liệu được đọc từ bộ nhớ đệm, chi phí đầu vào là khoảng 1,62 USD. Tác vụ tương tự trong 25 lượt xử lý khoảng 1,75 triệu token và tốn khoảng 1,02 USD cho đầu vào.
Một lượt tốn kém hơn số token mà nó thêm vào, vì nó gửi lại tất cả những gì đã có trước đó. Vì vậy, lượt rẻ nhất là lượt bạn không cần đến.
Một thói quen có thể cắt giảm số lượt là cung cấp cho mô hình cách để tự kiểm tra công việc của nó. Ví dụ: một bài kiểm tra để chạy, một bản build hoặc một tập lệnh gọi đến endpoint. Một mô hình có thể tự kiểm tra công việc của mình sẽ tìm ra lỗi sớm hơn.
Một mô hình thu thập những gì nó cần trong một lần truyền và gộp các lệnh gọi công cụ của nó lại cũng sẽ tốn ít chi phí gửi lại hơn.
Đọc từ bộ nhớ đệm (Cache reads)
2,8 triệu token đầu vào tương tự sẽ tốn 11,20 USD nếu không có dữ liệu nào được lấy từ bộ nhớ đệm. Với tỷ lệ hit (hit rate) 90%, chúng tốn 1,62 USD và với 96% là khoảng 0,99 USD. Không có thiết lập nào khác làm thay đổi chi phí đầu vào nhiều như vậy. Một phiên làm việc ổn định sẽ tự duy trì tỷ lệ hit cao. Tôi sẽ đề cập đến một số hành động để tránh làm hỏng bộ nhớ đệm của bạn ở phần sau của bài viết này.
Token đầu ra
Trên Opus 5.5, một token đầu ra có giá gấp 100 lần một lần đọc từ bộ nhớ đệm. 60K token đầu ra của một tác vụ điển hình tốn 1,20 USD, bằng với việc đọc 6 triệu token từ bộ nhớ đệm. Đầu ra bao gồm cả quá trình suy luận (thinking). Bạn phải trả phí cho tất cả, ngay cả khi Claude Code chỉ hiển thị cho bạn một bản tóm tắt. Đó là lý do tại sao nỗ lực, thứ chủ yếu thay đổi mức độ suy luận của mô hình, lại ảnh hưởng lớn đến hóa đơn như vậy.
Mô hình
Một mô hình có chi phí đọc bộ nhớ đệm rẻ hơn chủ yếu giúp ích cho các phiên làm việc dài. Một mô hình có chi phí đầu ra rẻ hơn chủ yếu giúp ích cho các tác vụ cần nhiều suy luận.
Những gì đã thay đổi ở Opus 5.5
Hai thứ đã thay đổi: giá cả và khối lượng công việc mà mô hình thực hiện.
Mọi dòng giá đều thấp hơn. Token đầu vào và đầu ra rẻ hơn 20% so với Opus 5. Đọc từ bộ nhớ đệm rẻ hơn 60%. Giá đầu vào giảm, và tỷ lệ đọc cũng giảm theo, từ một phần mười giá đầu vào xuống còn một phần hai mươi. Hình A so sánh hai mô hình trên mỗi triệu token. Đây là giá niêm yết API. Trên gói Pro, Max hoặc Team, mức giá thấp hơn của Opus 5.5 được áp dụng cho các giới hạn của bạn, bao gồm cả ngữ cảnh được lưu trong bộ nhớ đệm, vì vậy chúng giúp bạn đi xa hơn khoảng 25% so với Opus 5. Việc giảm giá thêm trên các lần đọc bộ nhớ đệm là một thay đổi về giá API.
Đối với khóa API, việc cắt giảm giá đọc bộ nhớ đệm quan trọng nhất đối với Claude Code. Một phiên làm việc dài của tác nhân (agentic session) dành phần lớn đầu vào cho việc đọc bộ nhớ đệm. Trong phiên làm việc được định giá ở Hình B bên dưới, dòng chi phí bộ nhớ đệm giảm từ 1,00 USD xuống 0,40 USD, mức giảm lớn nhất trên hóa đơn.
Số tiền bạn tiết kiệm được phụ thuộc vào hình thái công việc của bạn. Một phiên làm việc chủ yếu là đọc bộ nhớ đệm có thể tiết kiệm tới 60% chi phí đầu vào. Một câu hỏi ngắn không có bộ nhớ đệm và câu trả lời dài có thể tiết kiệm tới 20%, vì đầu ra chiếm ưu thế. Hầu hết các tác vụ Claude Code nằm ở giữa hai mức này. Máy tính bên dưới cho thấy vị trí của bạn.
Opus 5.5 có thể sử dụng nhiều token hơn cho một câu trả lời vì nó luôn suy luận trước khi trả lời. Chúng tôi kỳ vọng mọi người sẽ hoàn thành nhiều việc hơn trên Opus 5.5, nhưng điều này thay đổi tùy theo tác vụ, vì vậy hãy đo lường nó trên công việc của chính bạn. Hình C so sánh chi phí trên mỗi tác vụ giữa hai mô hình. Phần này phụ thuộc vào công việc của bạn nhiều hơn là giá cả.
Đối với một tác vụ được xác định rõ phạm vi, cả hai mô hình đều hoàn thành trong khoảng số lượt tương đương nhau và việc giảm giá là tất cả những gì bạn nhận được. Khoảng cách sẽ lớn nhất ở các tác vụ mở, nơi mô hình có thể dành nhiều lượt cho một ý tưởng sai lầm. Không có con số duy nhất nào đúng cho mọi cơ sở mã, vì vậy hãy đo lường nó (xem phần cuối).
Các lần chạy dài kết thúc bằng một báo cáo. Opus 5.5 kết thúc một lần chạy dài với những gì nó đã thay đổi, những gì nó tìm thấy và những gì nó cần từ bạn. Điều đó cũng có thể tiết kiệm tiền, vì bạn sẽ ít phải chạy lại phiên làm việc hơn khi có thể thấy những gì đã xảy ra.
Các tác vụ tương tự đặt cạnh nhau
Hình B định giá một phiên làm việc trên cả hai mô hình với cùng số lượng token. Vì vậy, sự khác biệt chính là thay đổi về giá và không gì khác. Hãy chuyển đổi giữa các mô hình để so sánh. Số lượng token chỉ mang tính minh họa.
3,50 USD
theo giá niêm yết của Opus 5
Hình B. Phiên làm việc minh họa với cùng số lượng token trên cả hai mô hình, vì vậy đây chỉ là thay đổi về giá.
Hình B. Phiên làm việc minh họa với cùng số lượng token trên cả hai mô hình, vì vậy đây chỉ là thay đổi về giá.
Bài viết được AI dịch và tổng hợp tự động từ Claude: Blog (Web). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.