Nghiên cứu
AI có thể phát hiện lỗi lắp ráp IKEA? Epoch AI ra mắt bộ tiêu chuẩn FAB
(giờ Việt Nam)
Tóm tắt AI
Epoch AI giới thiệu bộ tiêu chuẩn FAB, sử dụng 60 ảnh lắp ráp nội thất để kiểm tra khả năng suy luận không gian của AI. GPT-6 Astra dẫn đầu với 80% độ chính xác, vượt xa Claude Fable 5.1 và Claude Opus 5.
Chính văn · Bản dịch AI
Liệu AI có thể tìm ra lỗi sai trong ảnh chụp đồ nội thất IKEA đang lắp ráp dở dang? Chúng tôi cho rằng thử thách này là một đại diện tốt cho nhiều tác vụ quan trọng về mặt kinh tế đòi hỏi khả năng suy luận không gian và thị giác tương tự, chẳng hạn như sửa xe hoặc sửa chữa đồ gia dụng. Nếu các mô hình có thể suy luận đủ nhanh và chính xác trong lĩnh vực này, rất có thể AI sẽ sớm cung cấp sự hướng dẫn đáng tin cậy, theo thời gian thực cho các công việc lắp ráp và sửa chữa vật lý phức tạp.
Mặc dù khả năng này rất quan trọng, nhưng hiện có rất ít tiêu chuẩn đánh giá suy luận thị giác kiểm tra được nó. Chúng tôi đã tạo ra Furniture Assembly Benchmark (FAB) để giúp lấp đầy khoảng trống này. Bộ tiêu chuẩn bao gồm 60 hình ảnh trải dài trên ba mẫu lắp ráp nội thất IKEA khác nhau. Một số hình ảnh cho thấy đồ nội thất đã được lắp ráp đúng, số khác cho thấy các bản lắp ráp có lỗi (cố ý). Ngoài hình ảnh, các mô hình AI còn được cung cấp hướng dẫn lắp ráp và các công cụ để kiểm tra hình ảnh. Để đạt điểm cao trên FAB, các mô hình phải xác định được tất cả các bước có lỗi và đưa ra mô tả hợp lý cho từng lỗi đó.
Những điểm chính cần lưu ý
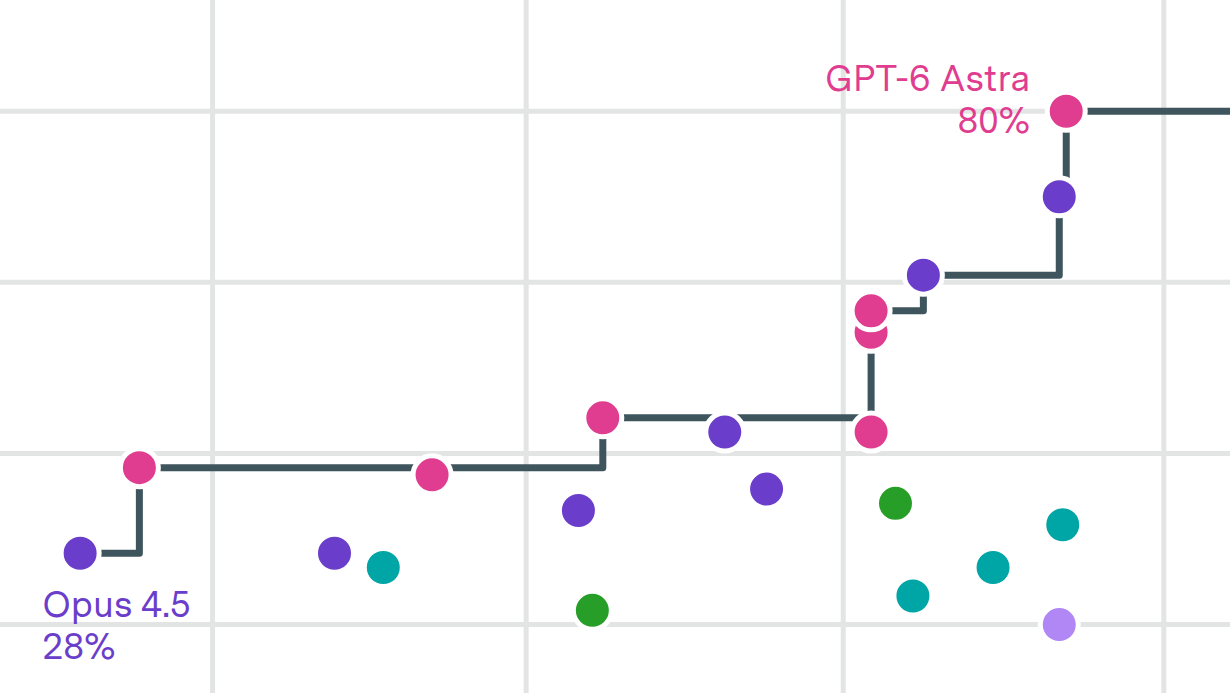
- Các mô hình đã cải thiện đáng kể trong năm qua. Điểm số cao nhất vào tháng 11 năm 2025 là 28%, do Claude Opus 4.5 của Anthropic thiết lập. Chỉ mười tháng sau, GPT-6 Astra của OpenAI hiện đang dẫn đầu bảng xếp hạng với 80%.
- GPT-6 Astra là một bước cải tiến lớn về tốc độ, với thời gian trung bình là 3 phút mỗi ảnh. Đây là mô hình nhanh nhất trong số các mô hình chúng tôi đã đánh giá và nhanh gấp từ hai đến mười lần so với các mô hình dẫn đầu trước đây.
- Mô hình dẫn đầu luôn là mô hình đóng (closed-weight), với các mô hình mở (open-weight) của Trung Quốc tụt hậu so với công nghệ tiên phong ít nhất bảy tháng.
Cách chúng tôi vận hành Furniture Assembly Benchmark
Chúng tôi đã mua ba món đồ nội thất IKEA với độ khó lắp ráp khác nhau, được đo bằng IKEA Complexity Index, chỉ số này tính toán độ phức tạp bằng tích số của số bước và số lượng linh kiện. Điều này cho phép chúng tôi kiểm tra xem các mô hình có gặp khó khăn với các bản lắp ráp lớn hơn, phức tạp hơn hay không.
| Tên sản phẩm | Loại | IKEA Complexity Index | Thời gian lắp ráp dự kiến của con người (giờ) |
|---|---|---|---|
| STÄLL | Kệ giày | 4,032 | 1.5 |
| TONSTAD | Khung giường | 10,878 | 3.5 |
| GULLABERG | Tủ ngăn kéo | 21,320 | 5 |
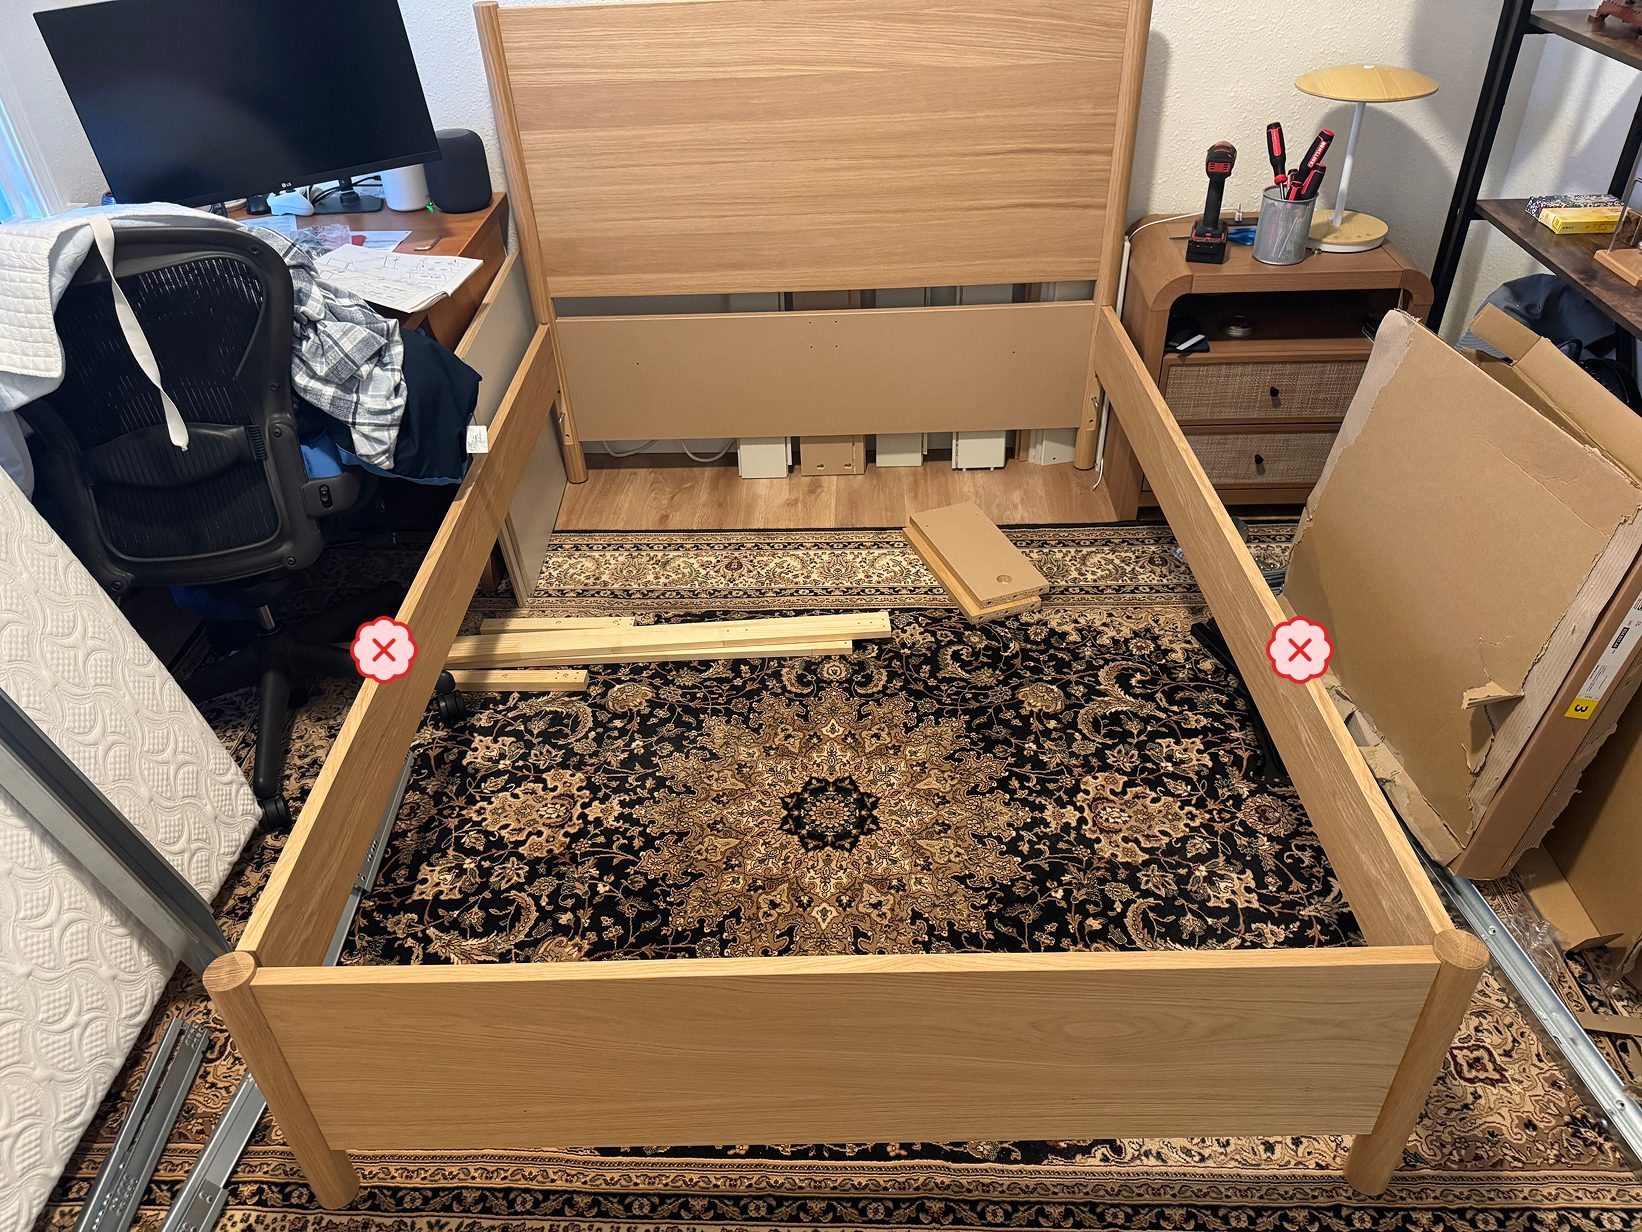
Sau đó, chúng tôi lắp ráp đồ nội thất và chụp ảnh trong quá trình thực hiện. Trong khi lắp ráp, chúng tôi cố tình tạo ra các lỗi. Chúng tôi sử dụng khả năng phán đoán tốt nhất của mình để tạo ra các lỗi một cách thực tế và thường tiếp tục lắp ráp sau khi mắc lỗi để làm cho việc xác định trở nên khó khăn hơn. Đối với mỗi bức ảnh có chứa lỗi, vấn đề đều hiển thị rõ ràng. Một ví dụ về lỗi được hiển thị bên dưới. Mặc dù chúng tôi chưa đo lường hiệu suất của con người trên bộ tiêu chuẩn này, nhưng chúng tôi dự đoán rằng nhiều lỗi trong số này sẽ là thách thức đối với những người không quen với việc lắp ráp.
Chúng tôi đã đánh giá nhiều mô hình do OpenAI, Anthropic, Google, Moonshot và Alibaba phát triển. Trong quá trình đánh giá, chúng tôi yêu cầu mô hình xem một hình ảnh. Nếu xác định được bất kỳ lỗi nào, mô hình phải liệt kê tất cả các bước có lỗi và mô tả các vấn đề; nếu không, nó phải hướng dẫn người dùng đến bước tiếp theo trong quá trình lắp ráp. Mô hình được cung cấp tệp PDF hướng dẫn, công cụ thu phóng để xem các phần của hình ảnh với độ trung thực cao hơn và trình thông dịch Python. Đối với mỗi hình ảnh mẫu, mô hình được cấp ngân sách 80 bước trong môi trường sandbox tác nhân. Nếu tiến gần đến giới hạn ngân sách, mô hình sẽ nhận được cảnh báo và khi đạt đến giới hạn, nó sẽ được yêu cầu đưa ra câu trả lời cuối cùng. Trên thực tế, giới hạn này chỉ đạt tới ở dưới 5% số mẫu.
Việc chấm điểm diễn ra qua nhiều bước. Nếu không có lỗi và mô hình xác định đúng điều này, nó sẽ được đánh dấu là chính xác. Nếu có lỗi, câu trả lời của mô hình sẽ được kiểm tra xem nó có xác định đúng (các) bước xảy ra lỗi hay không. Nếu mô hình vượt qua bước này, mô tả về lỗi của nó cuối cùng phải vượt qua một trình chấm điểm LLM để xác nhận rằng lỗi được xác định là chính xác. Mô hình chấm điểm LLM là GPT-5.6 Sol, và nó được yêu cầu phải rất khoan dung. Miễn là mô hình xác định đúng bước bị lỗi và mô tả sơ bộ vấn đề, nó sẽ được tính điểm.
Kết quả
Để hoàn thiện bảng xếp hạng ban đầu, chúng tôi đã thử nghiệm một số mô hình có khả năng thị giác do các công ty AI hàng đầu phát hành trong năm qua. Mô hình đạt điểm cao nhất là GPT-6 Astra với 80%, các mô hình tốt tiếp theo là Claude Fable 5.1 và Claude Opus 5, lần lượt đạt 70% và 61%.
Sự khác biệt về độ chính xác giữa các mô hình và sản phẩm
Các mô hình AI khác nhau gặp khó khăn ít nhiều với các loại đồ nội thất khác nhau, không có mối quan hệ rõ ràng với IKEA Complexity Index. Vì lý do này, chúng tôi nghi ngờ rằng các yếu tố khác như độ tinh vi của lỗi, góc nhìn và mức độ tiếp tục lắp ráp sau khi xảy ra lỗi đóng góp vào độ khó nhiều hơn là kích thước hoặc số lượng linh kiện được sử dụng trong món đồ nội thất đó.
Sự tiến bộ về năng lực theo thời gian
Bằng cách thử nghiệm các mô hình được phát hành trong năm qua, chúng ta có thể quan sát lại tốc độ tiến bộ của các năng lực. Trong số các mô hình chúng tôi đã thử nghiệm, Opus 4.5 đã thiết lập vị thế tiên phong vào tháng 11 năm 2025 với 28%. Mười tháng sau, vào tháng 9 năm 2026, Astra đạt 80%.
Hiệu suất của mô hình mở Trung Quốc
Mô hình Trung Quốc tốt nhất tính đến thời điểm hiện tại là Kimi K3 (mô hình mở), đã tụt hậu so với công nghệ tiên phong bảy tháng tại thời điểm phát hành. Khoảng cách giữa Kimi K3 và công nghệ tiên phong trong FAB rộng hơn so với các năng lực chung, nơi Kimi K3 chỉ chậm hơn 4,4 tháng, theo đo lường của Epoch Capabilities Index (ECI). Năng lực thị giác vẫn còn hiếm ở các mô hình Trung Quốc — DeepSeek V4 Pro và các mô hình Flash thiếu hỗ trợ hình ảnh, tương tự như GLM 5.3 của Z.ai. Chúng tôi sẽ tiếp tục theo dõi sự tiến bộ ở đây khi các năng lực này trở nên phổ biến hơn.
Các dạng lỗi (Failure Modes)
Các dạng lỗi thường giống nhau trong cùng một dòng mô hình. Chúng tôi thấy các mô hình Gemini của Google và Qwen của Alibaba hầu như luôn giả định rằng có lỗi tồn tại, trong khi các mô hình Anthropic và OpenAI đời đầu lại mắc lỗi theo hướng ngược lại và thường xuyên không tìm thấy lỗi nào cả.
Sự khác biệt về hiệu quả giữa các mô hình
Về hiệu quả, Astra là một cái tên nổi bật rõ rệt. Nó có thể đạt được độ chính xác tốt nhất chỉ với một phần thời gian và token mà các mô hình khác sử dụng. Với thời gian trung bình ba phút mỗi tác vụ, nó vẫn còn hơi chậm để phản hồi theo thời gian thực một cách thực tế, nhưng cũng không còn quá xa.
Kết luận
Kết quả của chúng tôi cho thấy các mô hình tiên phong có thể sử dụng ảnh chụp và hướng dẫn kỹ thuật để suy luận về việc xây dựng vật lý và nhận diện các lỗi lắp ráp. Hiệu suất đã liên tục được cải thiện trong năm qua, với GPT-6 Astra là bước nhảy vọt gần đây nhất về hiệu suất và hiệu quả. Độ chính xác và thời gian phản hồi chậm vẫn là những hạn chế đối với việc sử dụng theo thời gian thực, nhưng lĩnh vực này đang tiến bộ nhanh chóng.
Chúng tôi chỉ thử nghiệm các mô hình trên 60 bức ảnh từ ba mẫu lắp ráp nội thất, vì vậy vẫn chưa rõ kết quả này mở rộng sang các tác vụ vật lý khác tốt đến mức nào. Tuy nhiên, khả năng kết nối sách hướng dẫn với các vật thể thực và xác định lỗi cho thấy các mô hình có kỹ năng suy luận không gian cần thiết cho việc bảo trì và khắc phục sự cố cơ khí. Chúng tôi hy vọng Furniture Assembly Benchmark sẽ khuyến khích các công trình nghiên cứu sâu hơn về việc đo lường năng lực suy luận vật lý của các mô hình và hiểu cách chúng chuyển đổi thành các tác vụ trong thế giới thực.
Ghi chú
- Có khả năng là giới hạn tại thời điểm đó cao hơn mức này một chút. Chúng tôi không có điểm số cho GPT-5 hoặc Gemini 3, tuy nhiên chúng tôi sẽ rất ngạc nhiên nếu bất kỳ hệ thống nào trước đó đạt điểm số cao hơn đáng kể.
- Chúng tôi đã sử dụng các điểm cuối API chính thức của Moonshot và Alibaba, nhưng tốc độ và chất lượng của các mô hình mở có thể thay đổi đáng kể tùy thuộc vào nhà cung cấp.
Bài viết được AI dịch và tổng hợp tự động từ Epoch AI: Nghiên cứu, dữ liệu và đánh giá. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.