Thủ thuật
Artificial Analysis đánh giá Grok 4.7: Bứt phá trong lập trình và tác vụ trí tuệ
(giờ Việt Nam)
Tóm tắt AI
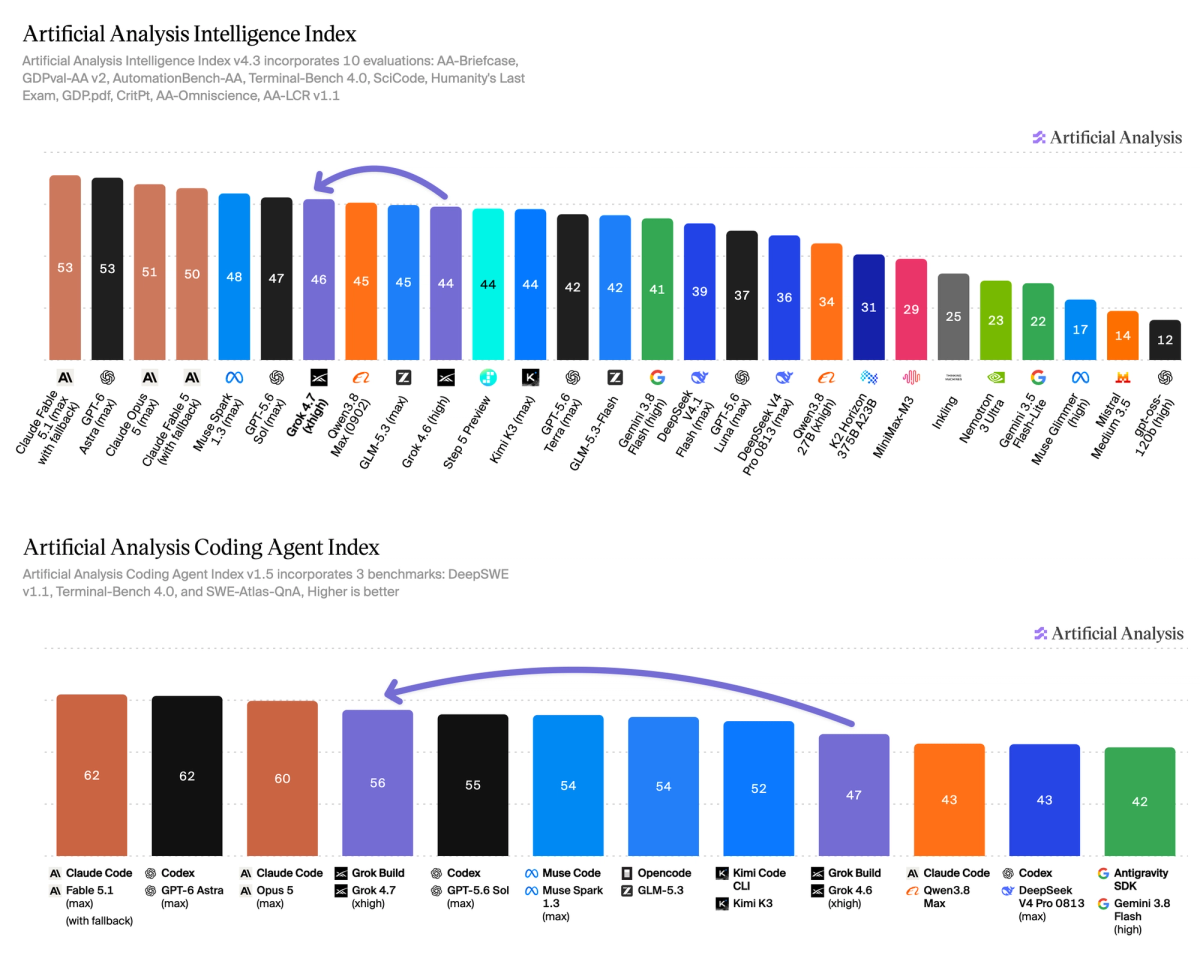
Grok 4.7 đạt 46 điểm trên Intelligence Index và vươn lên vị trí dẫn đầu trong các tác vụ lập trình với 1657 Elo, khẳng định vị thế cạnh tranh mạnh mẽ với các dòng model từ Anthropic.
Bản dịch AI
Grok 4.7 đạt 46 điểm trên Artificial Analysis Intelligence Index, đưa SpaceXAI lọt vào top 4 phòng thí nghiệm AI. Hiệu suất trên Coding Agent Index cũng đã được cải thiện, vượt qua GPT-5.6 Sol.
Grok 4.7 đạt số điểm cao hơn 2 điểm so với Grok 4.6 trên Intelligence Index, với hiệu suất mạnh mẽ trong các tác vụ tri thức mang tính đại diện (agentic knowledge work). Chúng tôi đã đánh giá mô hình mới ở mức nỗ lực suy luận xhigh.
Những điểm chính:
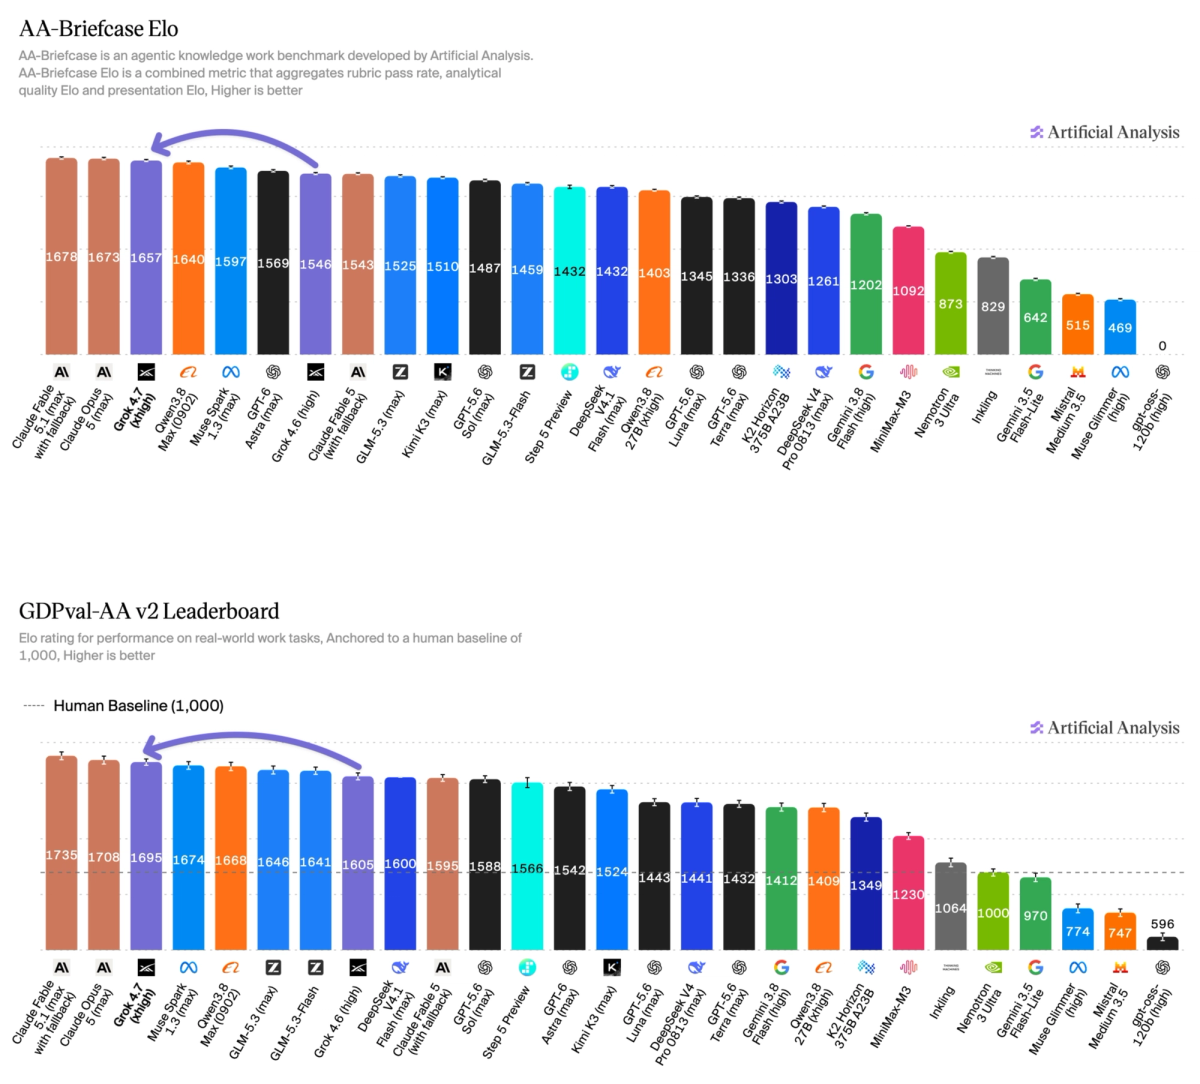
➤ Grok 4.7 gia nhập nhóm tiên phong trong lĩnh vực tri thức đại diện: Grok 4.7 đạt mức tăng +111 Elo so với Grok 4.6 (high) trên AA-Briefcase, bộ tiêu chuẩn đánh giá riêng của chúng tôi dành cho các tác vụ tri thức đại diện dài hạn, với số điểm 1657 Elo, xếp ngay sau Claude Opus 5 và Claude Fable 5.1 ở nhóm dẫn đầu. Trên GDPval-AA, mô hình đạt 1695 Elo, cao hơn +90 so với Grok 4.6 (high).
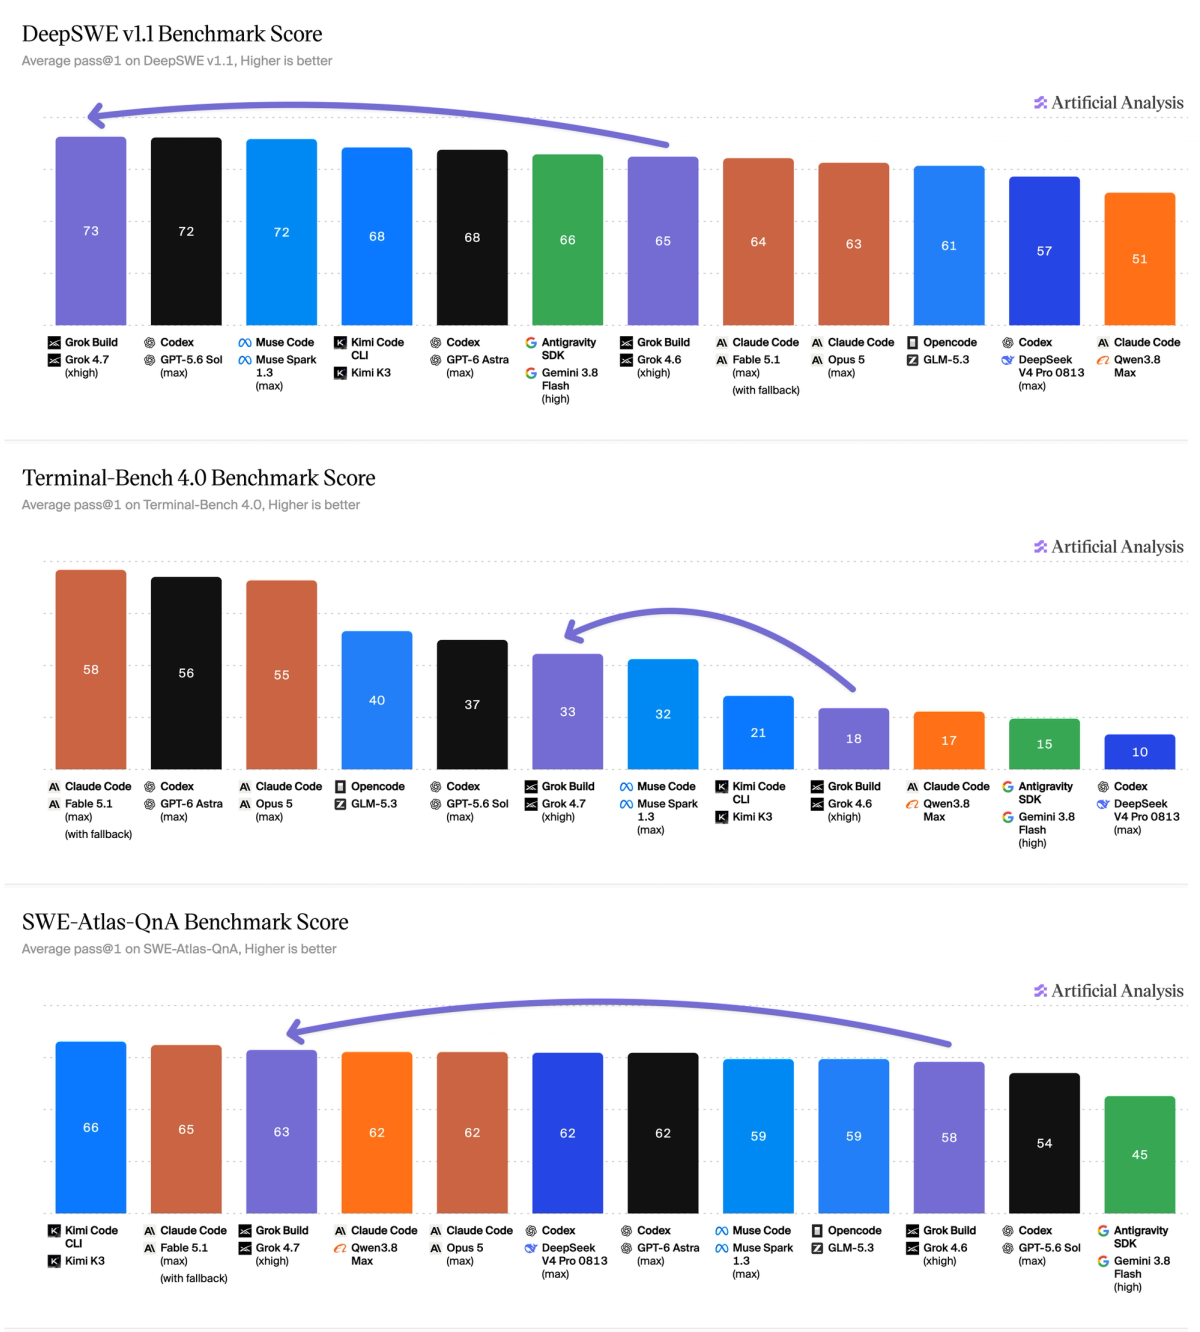
➤ Bước nhảy vọt về hiệu suất của coding agent: Grok 4.7 (xhigh) kết hợp với Grok Build đạt 56 điểm trên Artificial Analysis Coding Agent Index, tăng +9 điểm so với Grok 4.6 (xhigh). Trong số các mô hình sử dụng bộ công cụ gốc, Grok 4.7 + Grok Build hiện xếp thứ 4, chỉ đứng sau Claude Fable 5.1, GPT-6 Astra và Claude Opus 5.
➤ Những thay đổi hiệu suất tăng dần ở các khía cạnh khác: Ngoài lĩnh vực tri thức đại diện, Grok 4.7 nhìn chung tương đương với Grok 4.6 (high) ở các tác vụ khác trên Intelligence Index. Mô hình cải thiện trên Terminal-Bench 4.0 (+4,5 điểm phần trăm) và GDP.pdf (+3,0 điểm phần trăm), trong khi có sự sụt giảm trên AA-LCR (-3,7 điểm phần trăm) và AutomationBench-AA (-1,1 điểm phần trăm).
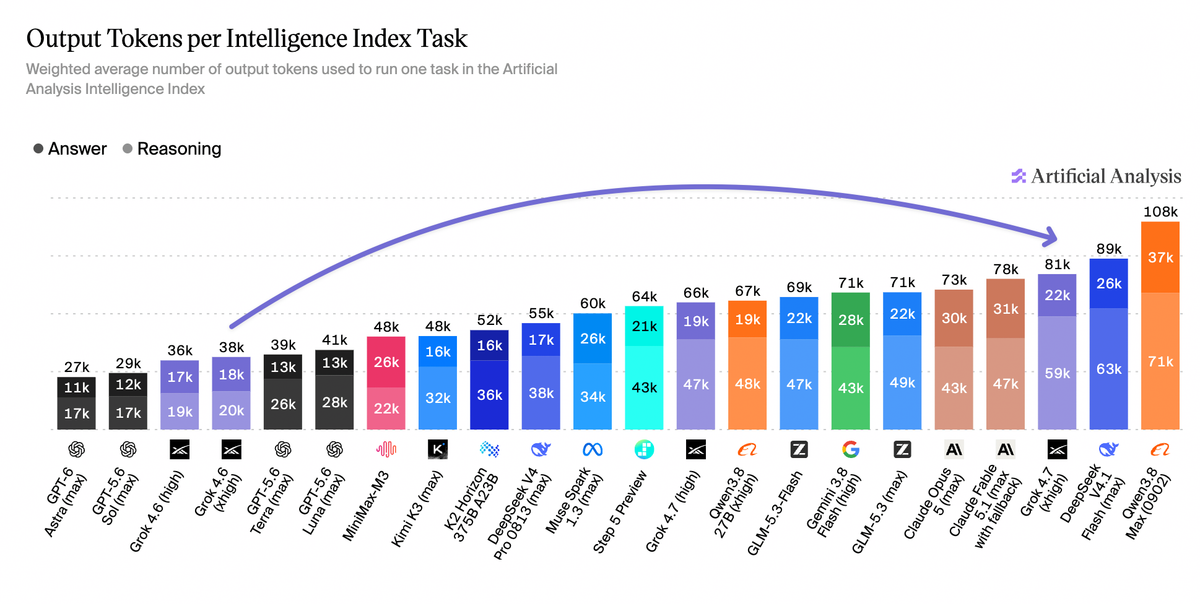
➤ Mức sử dụng token cao trên các tác vụ: Những cải tiến của Grok 4.7 đi kèm với mức sử dụng token cao hơn. Grok 4.7 (xhigh) sử dụng khoảng 81k token đầu ra cho mỗi tác vụ trên Intelligence Index, so với 36k của Grok 4.6 (high) và 27k của GPT-6 Astra (max) - lần lượt cao hơn 125% và 196%.
Các chi tiết khác về mô hình:
➤ Cửa sổ ngữ cảnh (context window) 500k token, không thay đổi so với Grok 4.6.
➤ Giá cước 2 USD/6 USD cho mỗi 1 triệu token đầu vào/đầu ra, với các lượt truy cập bộ nhớ đệm (cache hits) được giảm giá còn 0,50 USD cho mỗi 1 triệu token, tương đương với Grok 4.6.
➤ Nỗ lực suy luận có thể cấu hình từ mức low đến xhigh. Đánh giá của chúng tôi sử dụng mức xhigh.
Grok 4.7 gia nhập nhóm tiên phong trong các tác vụ tri thức đại diện. Trên AA-Briefcase, bộ tiêu chuẩn đánh giá mô hình dựa trên các tác vụ công việc chuyên môn thực tế, Grok 4.7 đạt 1657 Elo, tăng 111 điểm so với Grok 4.6 (high) và xếp ngay sau Claude Opus 5 và Claude Fable 5.1.
Sự cải thiện của Grok 4.7 dẫn đầu bởi chất lượng phân tích: mô hình đạt 1994 Elo về chất lượng phân tích và 1499 về chất lượng trình bày, so với lần lượt 1690 và 1519 của Grok 4.6 (high). AA-Briefcase cũng kiểm tra xem các kết quả đầu ra có đáp ứng yêu cầu của từng tác vụ hay không, từ việc hoàn thành phân tích đến tạo ra các sản phẩm bàn giao theo yêu cầu.
Trên GDPval-AA, Grok 4.7 đạt 1695 Elo, so với 1605 của Grok 4.6 (high). Các tác vụ này yêu cầu mô hình tạo ra các sản phẩm công việc thực tế như tài liệu, bảng tính và slide thuyết trình.
Grok Build với Grok 4.7 (xhigh) đạt 56 điểm trên Artificial Analysis Coding Agent Index, tăng từ 47 điểm với Grok 4.6 (xhigh).
Mô hình cải thiện trên cả ba thành phần: DeepSWE v1.1 tăng từ 65% lên 73%, Terminal-Bench 4.0 từ 18% lên 33% và SWE-Atlas-QnA từ 58% lên 63%.
Những kết quả này đánh giá Grok cùng với Grok Build, coding agent chính chủ của hãng. Chúng tách biệt với các kết quả trên Intelligence Index, vốn chuẩn hóa bộ công cụ đánh giá được sử dụng trên các mô hình.
Những cải tiến của Grok 4.7 đi kèm với mức sử dụng token cao hơn. Grok 4.7 (xhigh) đạt 46 điểm trên Intelligence Index khi sử dụng 81k token đầu ra cho mỗi tác vụ, cao hơn gấp đôi so với 38k token mà Grok 4.6 (xhigh) sử dụng. Con số này so với 60k của Muse Spark 1.3 (max) và 27k của GPT-6 Astra (max).
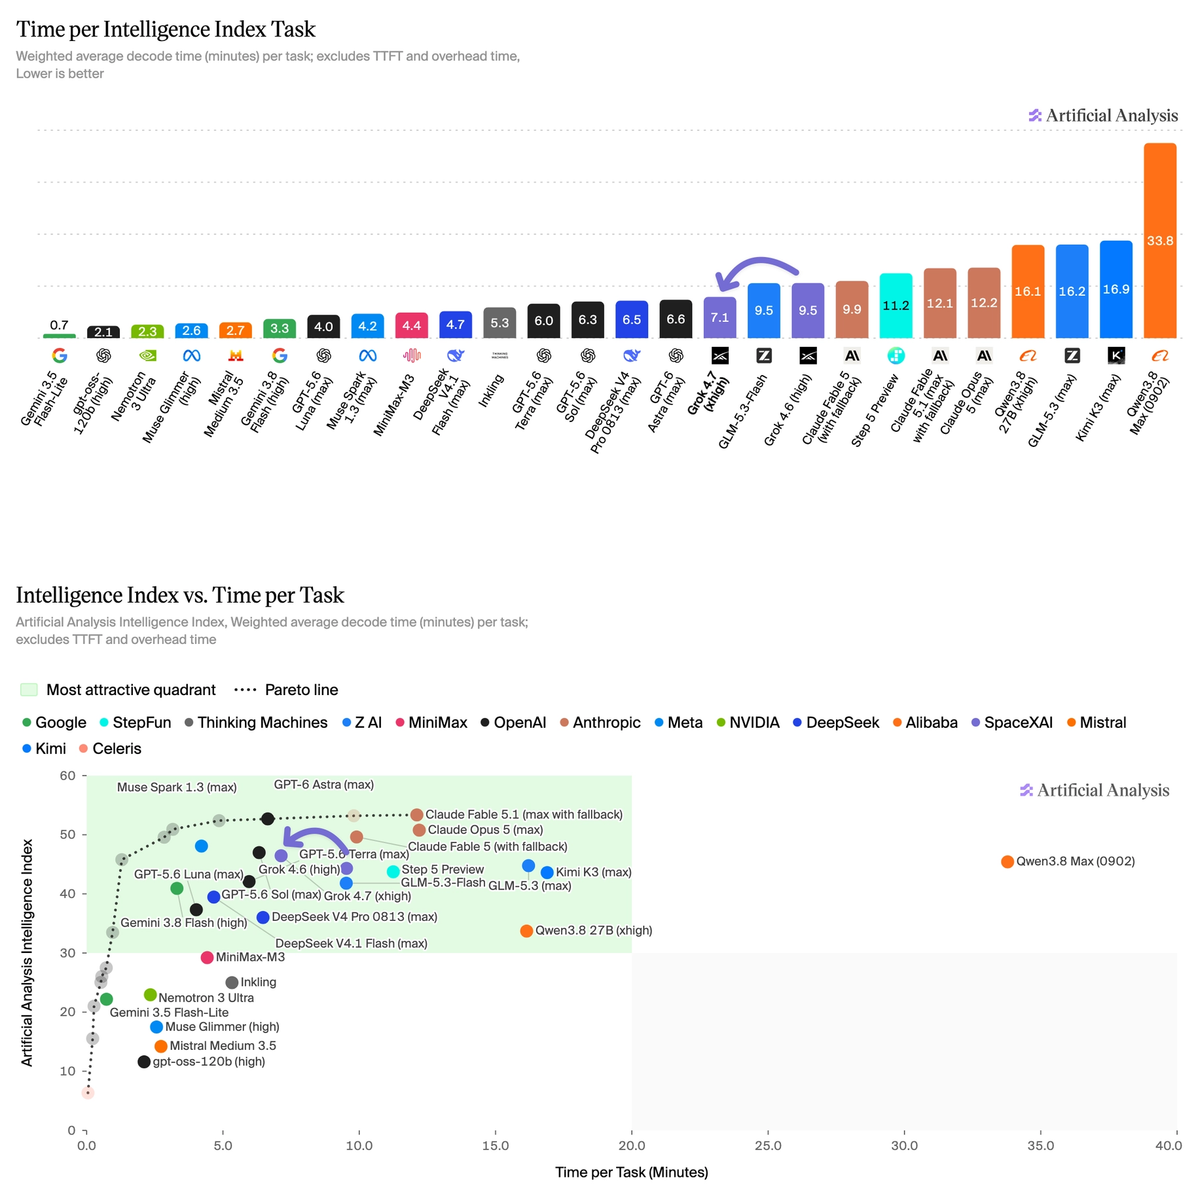
Các phép đo hiệu suất của chúng tôi cho thấy tốc độ xuất câu trả lời của Grok 4.7 đạt khoảng 188 token/giây đối với các câu lệnh dài. Grok 4.7 mất trung bình khoảng 7,1 phút cho mỗi tác vụ trên Intelligence Index.
Grok 4.7 (xhigh) có Tỷ lệ ảo tưởng (Hallucination Rate) trên AA-Omniscience thấp hơn Grok 4.6 (high): 29% so với 34%. Độ chính xác nhìn chung không thay đổi ở mức 47% so với 48%, và chỉ số AA-Omniscience tổng thể cải thiện từ 30 lên 32.
Bảng phân tích đánh giá chi tiết Intelligence Index cho Grok 4.7 (xhigh), cùng với Grok 4.6 (high) và các mô hình hàng đầu khác.
Bài viết được AI dịch và tổng hợp tự động từ Artificial Analysis (Web). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.