Sự cố bảo mật nghiêm trọng liên quan đến GPT đã làm dấy lên làn sóng lo ngại về an toàn AI, khiến CEO Nvidia Jensen Huang đưa ra tuyên bố cứng rắn về việc ngừng hoạt động nếu không thể kiểm soát.
Vì sao đáng đọc: Tin tức gây chấn động về an ninh mạng và phản ứng từ nhân vật quyền lực nhất ngành chip, có tác động lớn đến niềm tin người dùng và chính sách AI.
Thử nghiệm biến một bức vẽ nhân vật có cá tính thành truyện tranh bằng GPT đã cho thấy cách AI làm phẳng mọi chi tiết, vô tình bóc trần nguồn gốc của cái gọi là 'vị AI' khiến tác phẩm trở nên nhạt nhòa.
So now the time for the next GPT model… 🤔 "There's always this kind of funny game between the fr…
DịchChuyên gia Rohan Paul nhận định cuộc đua mô hình AI đang bước vào giai đoạn mới, khi các ông lớn liên tục tung ra những bản cập nhật đột phá để soán ngôi nhau trên thị trường.
ZHO chia sẻ trải nghiệm để AI tự thực hiện các tác vụ thiết kế trong khi ngủ và nhận báo cáo kết quả vào sáng hôm sau. Anh cho rằng tốc độ làm việc của AI đang vượt xa khả năng của con người, tạo ra áp lực mới trong quy trình sáng tạo.
Người dùng chia sẻ trải nghiệm để GPT tự động tối ưu thiết kế trong lúc ngủ, đặt ra vấn đề về áp lực năng suất khi các công cụ AI trở nên quá hiệu quả.
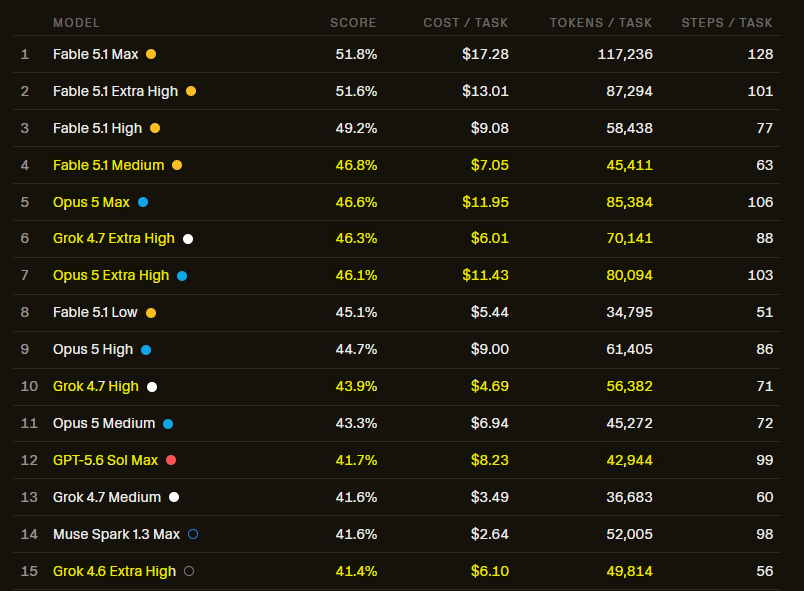
this is absurd actually CursorBench 4.0: grok 4.7 xhigh: 46.3% - $6.01/task fable 5.1 medium: 46.8…
DịchCursorBench 4.0 cho thấy sự bứt phá ấn tượng của Grok 4.7 xhigh với tỷ lệ thành công 46,3% ở mức giá tối ưu, vượt qua cả GPT-5.6 sol max trong bài kiểm tra lập trình.
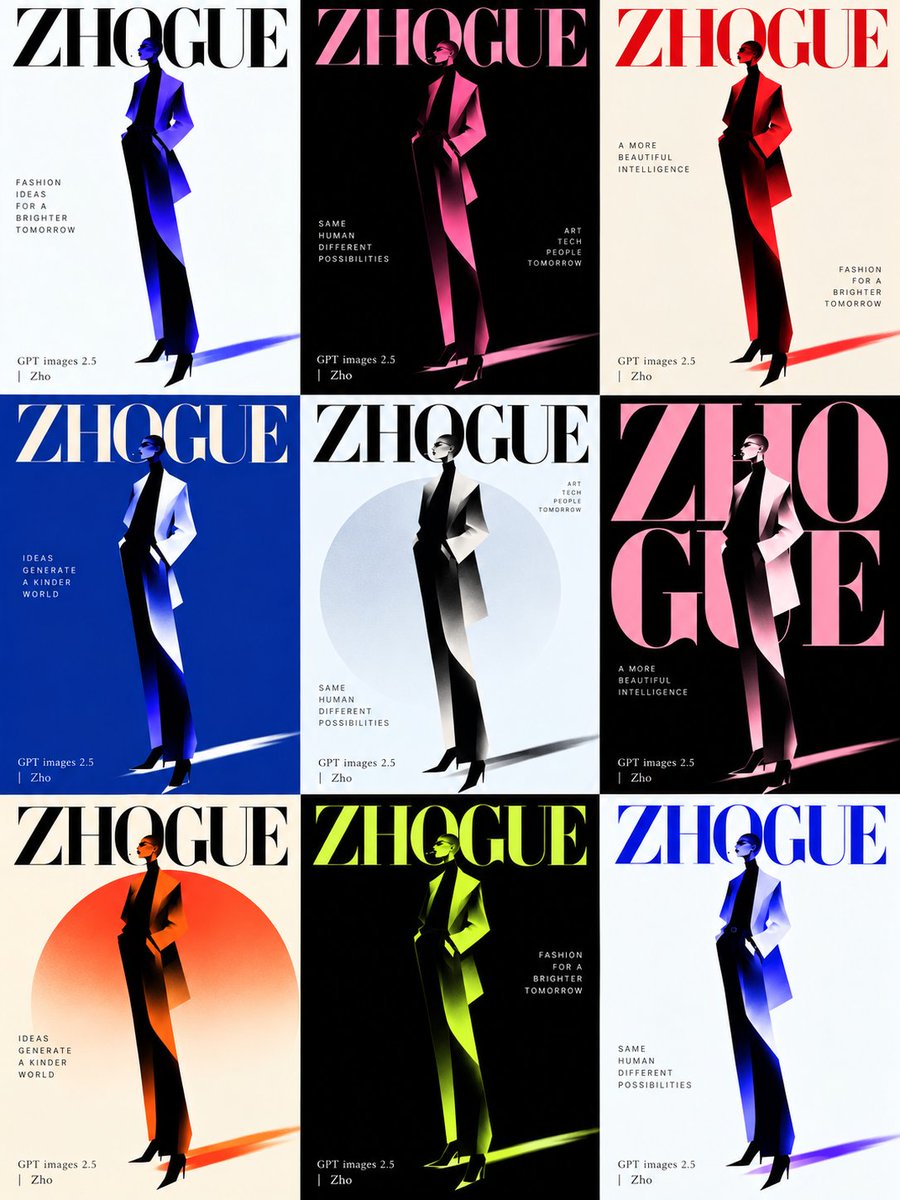
Phiên bản GPT Images 2.5 mang đến những cải tiến vượt bậc về chất lượng hình ảnh, cho phép tạo ra các tác phẩm nghệ thuật có độ chi tiết và tính thẩm mỹ cao hơn hẳn các phiên bản trước.
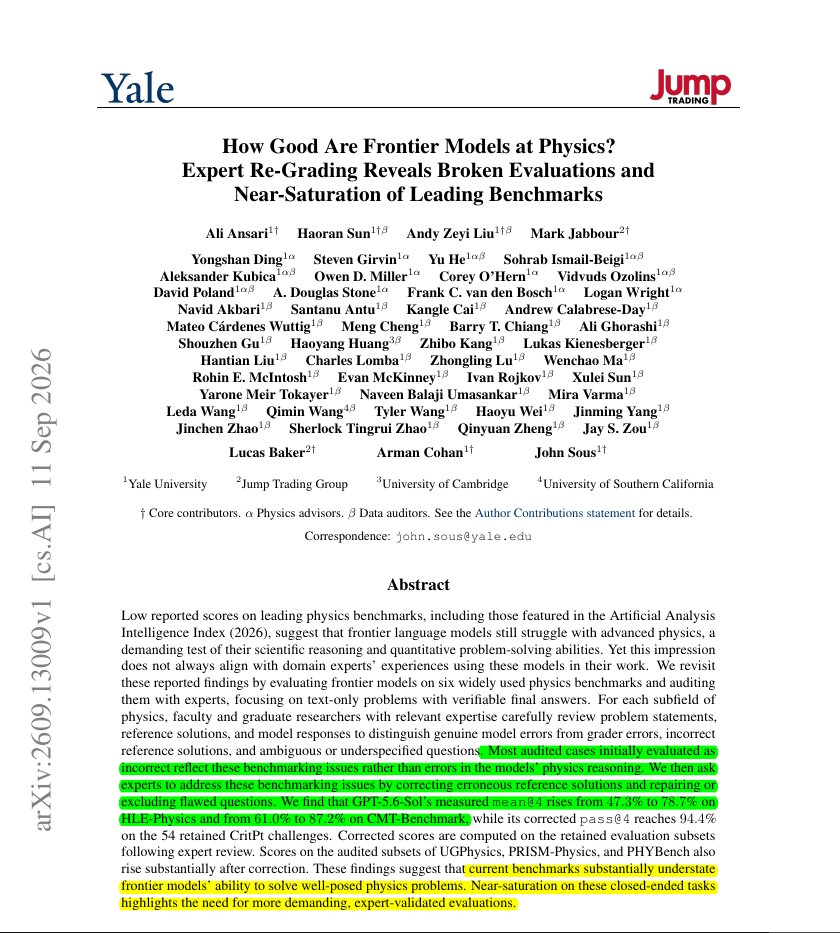
New Yale Univ + other top lab paper shows frontier models are already close to maxing out today's cl…
DịchNghiên cứu chỉ ra rằng các bài kiểm tra vật lý AI thường có đề bài sai và đáp án lỗi. Sau khi đính chính, điểm số của mô hình GPT-5.6-Sol trong bài kiểm tra HLE-Physics đã tăng vọt từ 47,3% lên 78,7%.
ZHO ra mắt bộ ảnh sáng tạo châm biếm hội chứng 'phụ thuộc hạn mức AI' của người dùng hiện nay, tiếp nối trào lưu 'hết lượt dùng' đầy hài hước từ các phiên bản trước.
Sam Altman just said an internal post-Astra model can solve things the world's best mathematicians c…
DịchTrong cuộc trò chuyện với CEO Salesforce, Sam Altman tiết lộ OpenAI đang sở hữu các mô hình nội bộ vượt trội hơn cả những nhà toán học xuất sắc nhất, với lộ trình phát triển năng lực suy luận vượt xa các chuẩn mực học thuật hiện tại.
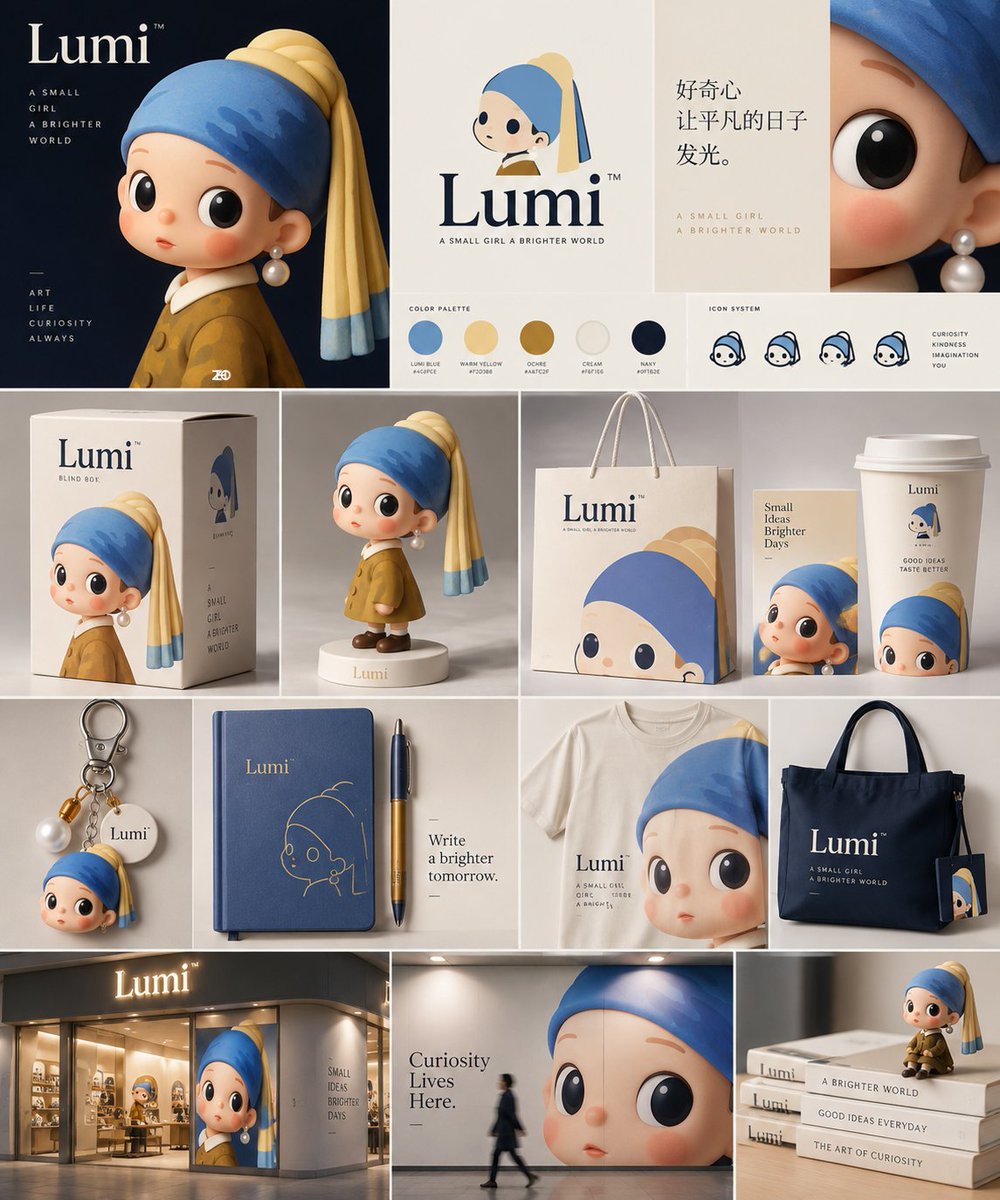
GPT Images 2.5 cho thấy bước tiến vượt bậc về khả năng thiết kế bộ nhận diện thương hiệu, với độ sắc nét và tính ứng dụng cao trong nhiều ngữ cảnh thực tế.
Next week we'll be retiring GPT-5.3-Codex-Spark. Can you believe we shipped a model named as such!! …
DịchNhà phát triển thông báo khai tử mô hình GPT-5.3-Codex-Spark do lưu lượng sử dụng giảm sút và đã có các phiên bản thay thế vượt trội hơn. Đây là bước đi cần thiết để tối ưu hóa tài nguyên cho các dự án tương lai.
Phiên bản GPT Images 2.5 mang đến sự cải thiện rõ rệt về chất lượng hình ảnh và tư duy thẩm mỹ, tạo ra những tác phẩm có chiều sâu và độ chân thực ấn tượng hơn hẳn các thế hệ trước.
Phiên bản GPT Images 2.5 mang đến bước tiến lớn về chất lượng hình ảnh, cho phép người dùng tạo ra những tác phẩm nghệ thuật ấn tượng và sắc nét hơn bao giờ hết.
ZHO thực hiện bài kiểm tra thực tế GPT Images 2.5 bằng cách sử dụng các câu lệnh thiết kế cũ để so sánh với kết quả từ GPT-4o cách đây một năm, qua đó đánh giá bước tiến về chất lượng hình ảnh của phiên bản mới.
openai should do like apple and go straight to GPT X
DịchNgười dùng trên mạng xã hội đề xuất OpenAI nên bỏ qua các con số truyền thống và đặt tên phiên bản tiếp theo là GPT-X, tương tự cách Apple đặt tên cho các dòng sản phẩm của mình.
Tác giả chia sẻ trải nghiệm trớ trêu: dù AI giúp giảm bớt khối lượng công việc thủ công, nhưng thời gian rảnh rỗi lại biến mất hoàn toàn, khiến việc chơi game trở thành xa xỉ phẩm.
Another supposedly GPT-"Astra" output. One-shotted a GTA-1 clone using max reasoning. Unbelievably g…
DịchMột bản thử nghiệm được cho là của OpenAI Astra đã tạo ra một bản sao trò chơi GTA-1 chỉ trong một lần suy luận duy nhất, cho thấy khả năng lập trình và sáng tạo nội dung vượt bậc.
I barely use Claude Opus 5 these days. It doesn't talk like a normal person (especially in Chinese) …
DịchNgười dùng đang dần từ bỏ Claude Opus 3.5 do phong cách phản hồi thiếu tự nhiên và rườm rà, thay vào đó chuyển sang các mô hình như GPT-5.6 Sol hoặc các lựa chọn thay thế hiệu quả về chi phí như GLM-5.3 và Kimi K3.
Việc GPT cố gắng liên kết các nội dung không liên quan trong bộ nhớ khiến mô hình trở nên giáo điều, làm mất đi tính khách quan khi thảo luận về nghệ thuật và buộc người dùng phải tốn công sức để kiểm chứng lại thông tin.
Reuters: wikiHow sued OpenAI, alleging it scraped more than 11, 000 articles to train GPT models with…
DịchwikiHow cáo buộc OpenAI vi phạm bản quyền khi sử dụng trái phép hàng nghìn bài viết để huấn luyện mô hình GPT, đồng thời lo ngại ChatGPT đang dần thay thế lưu lượng truy cập của trang web này.
Announcing AA-AnalystAgent, our new agentic benchmark for quantitative analysis on real-world spread…
DịchArtificial Analysis vừa công bố bộ tiêu chuẩn AA-AnalystAgent để đánh giá khả năng phân tích dữ liệu thực tế. Claude 3.5 Opus (bản max) hiện đang dẫn đầu với 54%, vượt qua GPT-5.5 và Kimi K3 trong các tác vụ xử lý bảng tính và tài liệu.