Hôm qua · 27/09

Chủ Nhật · 1 tin

26/09

Thứ Bảy · 1 tin

25/09

Thứ Sáu · 1 tin

24/09

Thứ Năm · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 52/100

Virtio-nvgpu: Giải pháp mã nguồn mở giúp máy ảo KVM đạt hiệu năng GPU NVIDIA gần như máy thật

Dự án virtio-nvgpu vừa ra mắt, cho phép máy ảo KVM truy cập GPU NVIDIA với hiệu năng đạt 98-100% so với máy vật lý nhờ cơ chế chuyển tiếp ioctl trực tiếp, giúp tối ưu hóa đáng kể cho các tác vụ AI và đồ họa trên môi trường ảo hóa.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 79/100

Cùng sự kiệnAnthropic chia sẻ cách tối ưu hóa giúp claude.ai và ứng dụng desktop nhanh gấp 3 lần

Đội ngũ kỹ thuật Anthropic đã thực hiện đợt chạy nước rút 2 tuần để tăng tốc trải nghiệm người dùng, giảm thời gian phản hồi ban đầu trên claude.ai từ 3,1 giây xuống còn 0,55 giây và cải thiện đáng kể tốc độ khởi chạy của Claude Code cũng như Claude Cowork.

Cùng sự kiện, tinh chọn hiển thị «Đội ngũ Claude chia sẻ cách tăng tốc claude.ai gấp 3 lần chỉ trong hai tuần»

23/09

Thứ Tư · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 75/100

Cùng sự kiệnArtificial Analysis đánh giá hiệu năng và giá thành của Claude Opus 5.5

Anthropic vừa ra mắt Claude Opus 5.5 với khả năng suy luận vượt trội, đạt 58 điểm trên bảng xếp hạng Artificial Analysis, cao hơn gấp đôi so với mức trung bình của các mô hình cùng phân khúc.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»

22/09

Thứ Ba · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 63/100

Đánh giá MiMo-V2.6-Pro từ Xiaomi: Hiệu năng vượt trội với 124.5 tokens/giây

Artificial Analysis vừa công bố kết quả kiểm định MiMo-V2.6-Pro của Xiaomi. Với chỉ số thông minh 46 điểm và tốc độ xử lý ấn tượng, đây là mô hình mã nguồn mở đáng chú ý với mức giá cạnh tranh.

Diễn biến sự kiện · 15 bài →Thêm 4 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)X: karminski (@karminski3)X: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)Latent Space
Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 36/100

Cùng sự kiệnGrok 4.7 bám đuổi sát nút Opus 5 với chi phí chỉ bằng một nửa

Grok 4.7 is behind only Anthropic models on AA-Briefcase, ranking just behind Opus 5 at ~50% of its …

DịchGrok 4.7 đạt bước tiến lớn trên bảng xếp hạng AA-Briefcase, chỉ đứng sau các mô hình của Anthropic với hiệu suất phân tích vượt trội và chi phí vận hành tối ưu hơn 50% so với Opus 5.

Cùng sự kiện, tinh chọn hiển thị «Elon Musk: Grok 4.7 đưa xAI lên vị trí thứ 3 trong lĩnh vực lập trình AI»

21/09

Thứ Hai · 3 tin
Lauren Tan@poteto
Mô hìnhĐiểm AI 54/100

Cùng sự kiệnGrok 4.7 ra mắt: Hiệu suất vượt trội, giữ nguyên giá và tốc độ

happy 4.7 day to those whose celebrate

DịchGrok 4.7 vừa được phát hành với những cải tiến đáng kể về hiệu năng trên các bộ tiêu chuẩn đánh giá như EEBench và CursorBench, trong khi vẫn duy trì mức giá và tốc độ xử lý tương đương phiên bản 4.6.

Cùng sự kiện, bài đại diện «xAI ra mắt Grok 4.7: Cải tiến vượt trội với cùng mức giá và tốc độ»
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 37/100

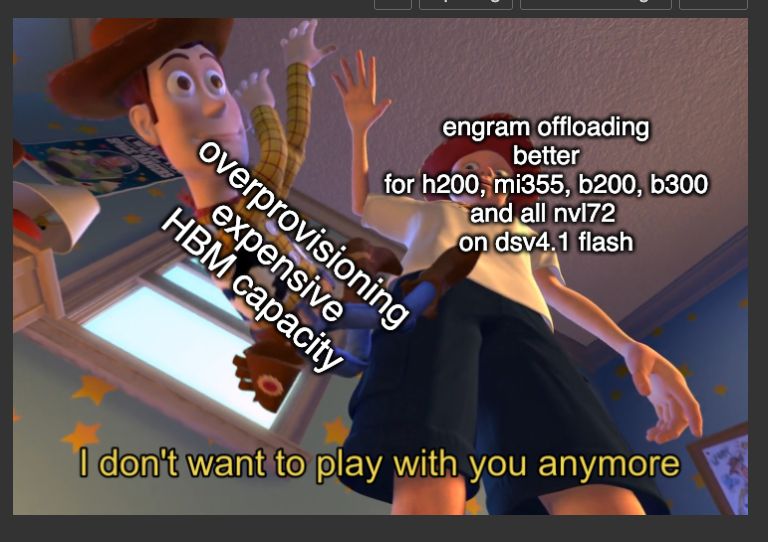
Công nghệ Engram trên DRAM giúp tăng 50% hiệu năng cho dòng chip H200, B200, B300 và GB300

Experiments have shown that offloading Engram to DRAM results in up to 50% better performance on H20…

DịchViệc chuyển tải dữ liệu Engram sang DRAM mang lại bước tiến lớn về tốc độ xử lý, giúp tối ưu hóa hiệu suất cho các dòng GPU thế hệ mới của NVIDIA như H200, B200 và GB300.

20/09

Chủ Nhật · 2 tin

19/09

Thứ Bảy · 2 tin
NVIDIA Technical Blog: Agentic AI / Generative AI
Hướng dẫnĐiểm AI 58/100

NVIDIA ra mắt AIPerf: Công cụ đo lường hiệu năng suy luận LLM quy mô lớn trên vLLM

NVIDIA giới thiệu AIPerf, phiên bản nâng cấp của GenAI-Perf với kiến trúc đa tiến trình giúp loại bỏ nút thắt cổ chai khi đo lường hiệu năng. Công cụ hỗ trợ đa dạng mô hình truy vấn và các kịch bản tải thực tế, tối ưu cho việc kiểm thử hệ thống LLM quy mô lớn.

18/09

Thứ Sáu · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 43/100

Thách thức khi giả lập x86 trên kiến trúc ARM: Bài toán về mô hình bộ nhớ TSO

Việc giả lập mô hình bộ nhớ x86-TSO trên ARM gây ra chi phí hiệu năng lớn do sự khác biệt về tính nhất quán. Các giải pháp ban đầu sử dụng lệnh acquire/release quá nghiêm ngặt, dẫn đến hiệu suất thấp trong các ứng dụng giả lập.

Hacker News: AI bài nổi bật
Sản phẩmĐiểm AI 67/100

Ra mắt ngôn ngữ lập trình Bend: Kiểm soát lỗi AI bằng toán học, hiệu năng tiệm cận C trên GPU

Bend là ngôn ngữ lập trình mới cho phép con người thiết lập các quy tắc nghiêm ngặt để AI tuân thủ khi viết code. Nhờ cơ chế chứng minh toán học, mọi đoạn mã vi phạm quy tắc sẽ bị loại bỏ, đồng thời tối ưu hóa hiệu suất cực cao trên cả CPU và GPU.

16/09

Thứ Tư · 3 tin
NVIDIA Blog
Mô hìnhĐiểm AI 51/100

Cùng sự kiệnNVIDIA Vera Rubin NVL72 ra mắt ấn tượng tại MLPerf v6.1: Hiệu năng vượt trội gấp 3.7 lần

Hệ thống Vera Rubin NVL72 lần đầu xuất hiện tại MLPerf Inference v6.1, đạt tốc độ xử lý nhanh gấp 3.7 lần so với GB300 NVL72 trên mô hình Qwen3-VL và 2.5 lần trên DeepSeek-R1.

Cùng sự kiện, bài đại diện «NVIDIA công bố bước tiến về hiệu suất năng lượng trên nền tảng Vera Rubin và DSX»

15/09

Thứ Ba · 1 tin

14/09

Thứ Hai · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SAS: Tối ưu hóa trực tiếp việc chọn lọc ngữ cảnh để tinh giản cơ chế Attention trong Transformer

SAS là phương pháp mới giúp tinh giản cơ chế Attention bằng cách tối ưu hóa trực tiếp việc chọn lọc token quan trọng, thay vì chỉ bắt chước phân phối trọng số của mô hình gốc, giúp sử dụng hiệu quả hơn ngân sách tính toán hạn chế.

11/09

Thứ Sáu · 1 tin

09/09

Thứ Tư · 2 tin

05/09

Thứ Bảy · 4 tin
Kim@kimmonismus
Hướng dẫnĐiểm AI 33/100

KOL đánh giá GPT-6 Astra: Hiệu năng vượt trội với chi phí chỉ bằng 1/3

You know whats the real magic with GPT-6-astra? Price performance. Its so freaking damn efficient in…

DịchTheo trải nghiệm thực tế, phiên bản Astra-Medium mang lại trí tuệ tương đương GPT-5.6 xhigh nhưng với chi phí tối ưu hơn nhiều, khẳng định vị thế dẫn đầu về hiệu suất trên giá thành.

Kim@kimmonismus
Mô hìnhĐiểm AI 61/100

Microsoft ra mắt MAI-Image-2.6-Flash: Tốc độ vượt trội, chi phí tối ưu

Crazy. Microsoft somehow develop er d the best text to image model at much better pricing.

DịchMicrosoft vừa giới thiệu mô hình tạo ảnh MAI-Image-2.6-Flash với tốc độ nhanh gấp đôi GPT-Image-2 và hiệu suất GPU tăng 72%, hứa hẹn mang lại giải pháp tạo ảnh chất lượng cao với chi phí cạnh tranh nhất hiện nay.

Thêm 1 nguồn khác đưa tinIT Home

04/09

Thứ Sáu · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

Random Attention: Tối ưu hóa KV Cache bằng cơ chế loại bỏ ngẫu nhiên giúp tăng tốc suy luận LLM

Salesforce giới thiệu Random Attention, phương pháp thay thế việc đánh giá token bằng cách loại bỏ ngẫu nhiên trong KV cache. Kỹ thuật này giúp tăng 32-43% lưu lượng xử lý trên vLLM mà vẫn duy trì độ chính xác tương đương các phương pháp tiên tiến nhất.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 50/100

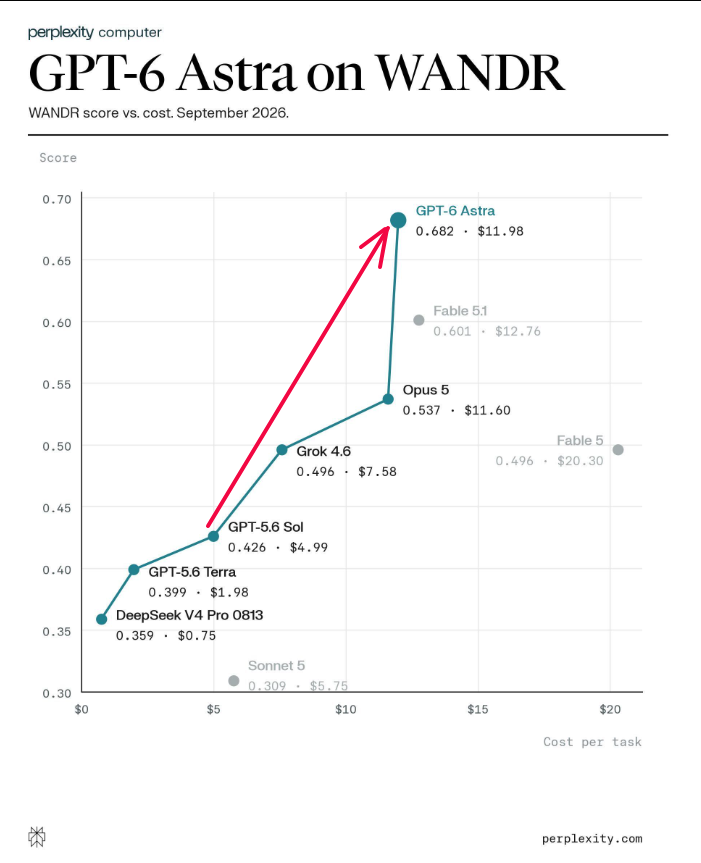
Perplexity đánh giá GPT-6 Astra: Đạt điểm kỷ lục 0.682 trên WANDR

GPT-6 Astra delivered Perplexity's strongest WANDR result yet 13.5% above Fable 5.1 while costing 6…

DịchPerplexity vừa thử nghiệm GPT-6 Astra trên bộ tiêu chuẩn WANDR, đạt số điểm cao nhất 0.682 với chi phí 11.98 USD/tác vụ. Kết quả này vượt trội hơn hẳn so với Fable 5.1 và Opus 5 về cả hiệu suất lẫn tối ưu chi phí.

02/09

Thứ Tư · 5 tin
Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 64/100

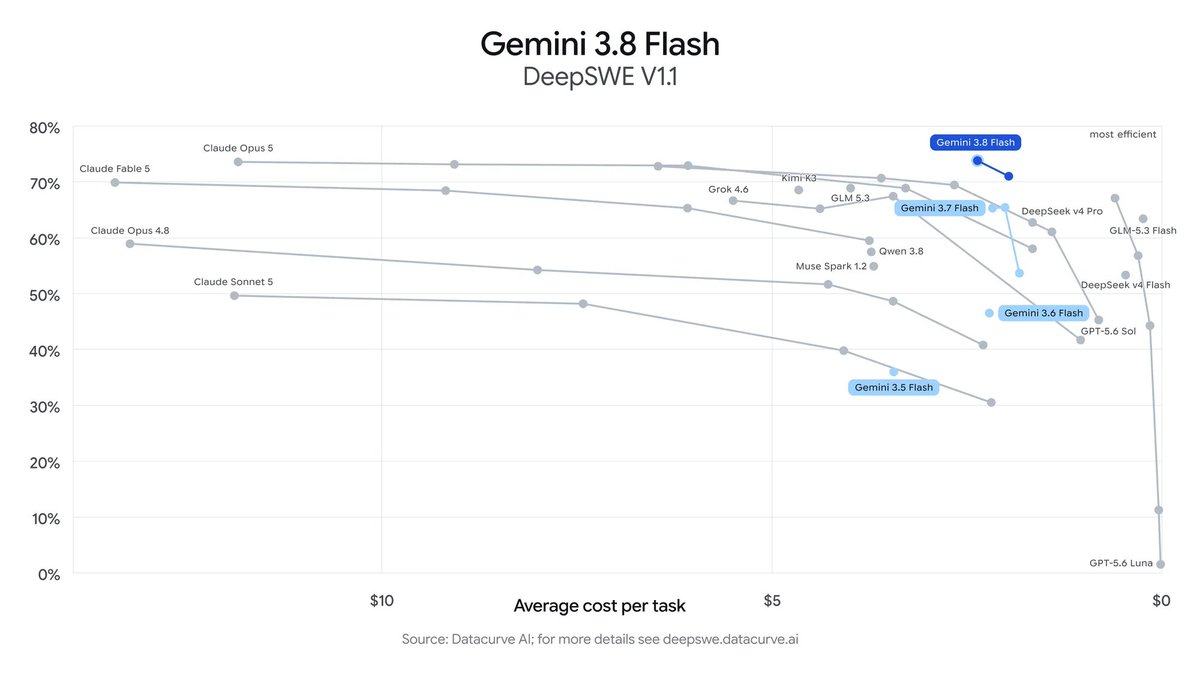
Cùng sự kiệnGoogle ra mắt Gemini 3.8 Flash: Hiệu suất ấn tượng, dẫn đầu về tỷ lệ hiệu năng trên giá thành

Google has released Gemini 3.8 Flash, its fourth Flash model in under four months - it scores 59 on …

DịchGoogle DeepMind vừa trình làng Gemini 3.8 Flash, mẫu model thứ tư thuộc dòng Flash trong vòng bốn tháng qua, đạt 59 điểm trên bảng xếp hạng Artificial Analysis và thiết lập chuẩn mực mới về chi phí tối ưu.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt bộ đôi mô hình mới: Gemini 3.8 Flash và 3.8 Flash Cyber»
Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 78/100

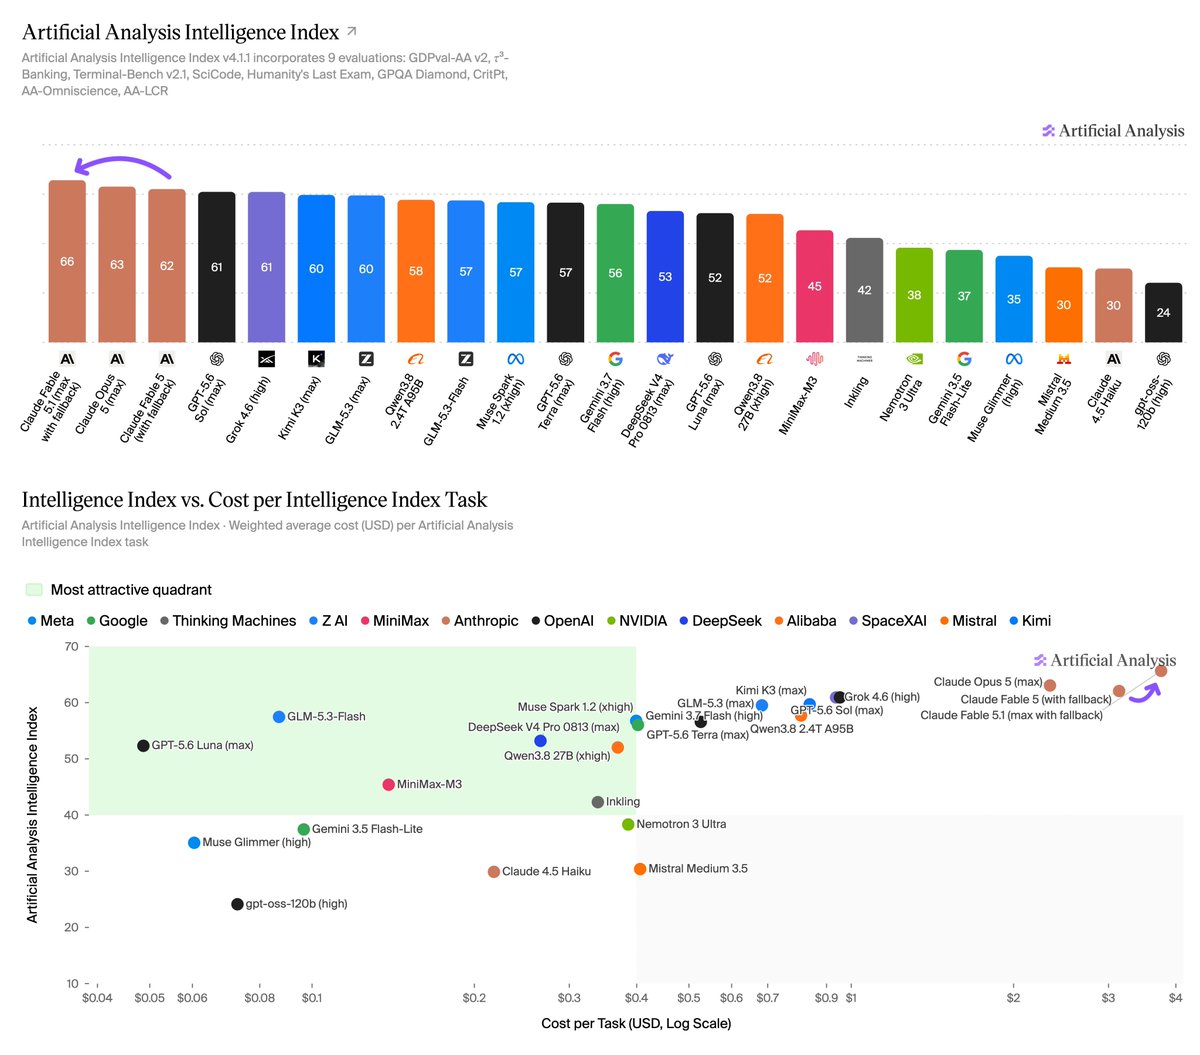
Claude 3.5 Sonnet (Fable 5.1) dẫn đầu bảng xếp hạng AI, nhưng chi phí tăng 20%

Claude Fable 5.1 tops the Artificial Analysis Intelligence Index but costs 20% more per task than Fa…

DịchClaude 3.5 Sonnet (phiên bản Fable 5.1) vừa chiếm lĩnh vị trí số 1 trên bảng xếp hạng Artificial Analysis với 66 điểm, tuy nhiên mức phí cho mỗi tác vụ lại cao hơn 20% so với thế hệ tiền nhiệm.

Kim@kimmonismus
Hướng dẫnĐiểm AI 24/100

Đánh giá hiệu năng Fable 5.1: Bước tiến lớn về sức mạnh và giá thành

Looking solely at benchmarks and considering the price-performance ratio, Fable 5.1 represents a sig…

DịchFable 5.1 cho thấy hiệu suất vượt trội so với Sol 5.6 Max trong các bài kiểm tra Cursor Bench với mức giá cạnh tranh hơn. Đây là bản nâng cấp đáng chú ý về chỉ số AI, hứa hẹn mang lại trải nghiệm tối ưu và ít lỗi hơn cho người dùng.

SemiAnalysis@SemiAnalysis_
Hướng dẫnĐiểm AI 28/100

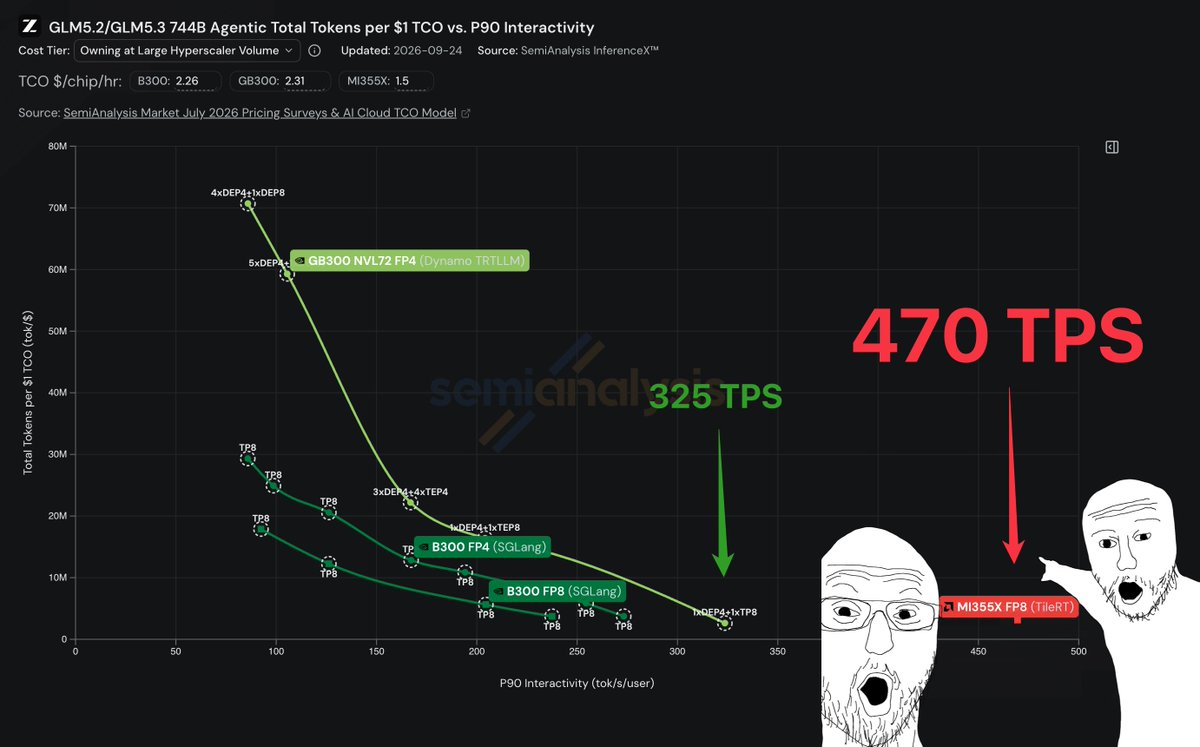
Cùng sự kiệnAMD MI355X cải thiện vượt bậc hiệu suất xử lý tác vụ AI chỉ trong vài tuần

Shoutout to @AMD team for quick improvements to MI355X performance on agentic workloads! In just a …

DịchSemiAnalysis ghi nhận AMD đã tối ưu hóa đáng kể hiệu suất MI355X cho các mô hình lớn như Qwen3.5 397B. Kết quả cho thấy chi phí vận hành (TCO) của MI355X hiện chỉ còn 1,5 USD/chip/giờ, vượt trội hơn so với các giải pháp cạnh tranh.

Cùng sự kiện, bài đại diện «SemiAnalysis: AMD MI355X vượt mặt Nvidia B300 về hiệu quả chi phí trong tác vụ AI ít tương tác»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (46 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Hiệu năng” | AIHOT.vn