Tin ngành
NVIDIA công bố bước tiến về hiệu suất năng lượng trên nền tảng Vera Rubin và DSX
(giờ Việt Nam)
Tóm tắt AI
Tại hội nghị AI Infra Summit, NVIDIA giới thiệu nền tảng DSX MaxLPS giúp tăng 40% công suất GPU và 35% lưu lượng token trên cùng một mức tiêu thụ điện năng, tối ưu hóa hiệu quả cho các trung tâm dữ liệu AI.
Bản dịch AI
Ian Buck, Phó chủ tịch phụ trách điện toán hiệu năng cao và hyperscale tại NVIDIA, đã có bài phát biểu về hiệu suất của AI factory tại AI Infra Summit, sự kiện diễn ra tại Trung tâm Hội nghị Santa Clara, nơi đã trở thành một "Coachella" của giới công nghệ hạ tầng.
Trước một khán phòng chật kín — với hơn 8.000 người tham dự năm nay, tăng từ 3.500 người vào năm ngoái — Buck đã thảo luận về các quan hệ hợp tác mới trên các nền tảng của NVIDIA và nhiều nội dung khác.
NVIDIA và các đối tác cũng đã công bố những kết quả mới:
Tin tức này xuất hiện trong bối cảnh agentic AI đang thúc đẩy một lớp khối lượng công việc mới, đòi hỏi hiệu suất, hiệu quả và quy mô lớn hơn từ hạ tầng AI.
NVIDIA giải quyết thách thức đó bằng một nền tảng AI factory full-stack bao gồm các hệ thống Vera Rubin, phần mềm suy luận Dynamo, các thư viện NeMo và hệ thống mạng NVIDIA — bao gồm NVIDIA NVLink cho điện toán quy mô lớn, Spectrum-X Ethernet và các SuperNIC ConnectX để kết nối hàng ngàn node, bộ lưu trữ context-memory được hỗ trợ bởi BlueField và các DPU BlueField phục vụ bảo mật hạ tầng.
Thước đo cho hạ tầng AI đang nhanh chóng chuyển dịch từ hiệu suất đỉnh sang số lượng agentic token trên mỗi megawatt được xác thực. Các AI factory hiện nay phải được đồng thiết kế từ silicon cho đến lưới điện. NVIDIA DSX MaxLPS có thể mang lại hiệu suất cao hơn tới 1,4 lần số token trên mỗi megawatt thông qua việc tối ưu hóa năng lượng toàn nhà máy, trong khi NVLink giúp hợp nhất điện toán tăng tốc quy mô lớn thành một hệ thống hiệu năng cao duy nhất.
Kết quả là hạ tầng AI được thiết kế để tạo ra nhiều token hơn, cải thiện hiệu quả và giúp khách hàng nhận được nhiều giá trị hơn từ mỗi megawatt điện năng.
Thứ Ba, ngày 15 tháng 9, 9:55 sáng giờ PT 🔗
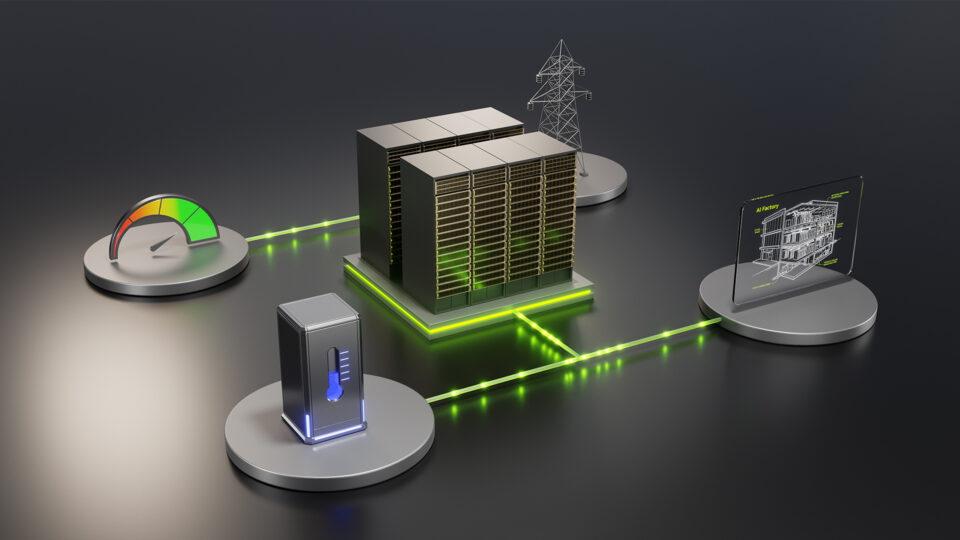
Chương trình Tải linh hoạt (Flexible-Load) của AI Factory giúp giải phóng thêm công suất lưới điện
Silicon Valley Power vận hành một chương trình kết nối tải linh hoạt cho phép các AI factory hỗ trợ sự linh hoạt của lưới điện.
Thông qua chương trình này, Emerald AI đã hợp tác với NVIDIA để trình diễn khả năng giảm tải tự động tại Silicon Valley Power. Hệ thống đã phản hồi thành công hàng trăm tín hiệu nhu cầu từ Silicon Valley Power trong khi vẫn bảo vệ được hiệu suất của khối lượng công việc AI.
Đối tác của NVIDIA là Emerald AI đang có kế hoạch sử dụng NVIDIA DSX Flex cho phần mềm quản lý năng lượng phản hồi lưới điện Conductor của mình, giúp điều chỉnh linh hoạt mức tiêu thụ năng lượng của AI factory dựa trên các tín hiệu thời gian thực từ lưới điện và các nguồn năng lượng hỗn hợp.
Bằng cách sử dụng DSX Flex để cân bằng tải tự động, Emerald AI có thể chứng minh khả năng tự động giảm công suất đối với các tác vụ AI ưu tiên thấp và sau đó trở lại bình thường.
DSX Flex có thể nhận các tín hiệu từ lưới điện — yêu cầu cắt giảm tải, sự kiện đáp ứng nhu cầu và tín hiệu giá — và tự động hành động trong một hệ thống phân cấp khối lượng công việc đã được xác định trước. Các tác vụ quan trọng nhất vẫn tiếp tục chạy, trong khi mọi thứ khác tạm dừng và sau đó tiếp tục. Bằng cách này, các cơ sở có thể tham gia vào việc tiết kiệm năng lượng cho lưới điện.
Khả năng này cho phép các AI factory vận hành như những nguồn tài nguyên lưới điện linh hoạt, giúp chúng giảm nhu cầu khi lưới điện cần hỗ trợ, bảo vệ các khối lượng công việc AI ưu tiên và chứng minh rằng tải AI có thể kiểm soát được sẽ giúp giải phóng thêm công suất lưới điện để tăng trưởng.
Tìm hiểu thêm về quan hệ đối tác giữa Emerald AI và Silicon Valley Power.
Thứ Ba, ngày 15 tháng 9, 9:55 sáng giờ PT 🔗
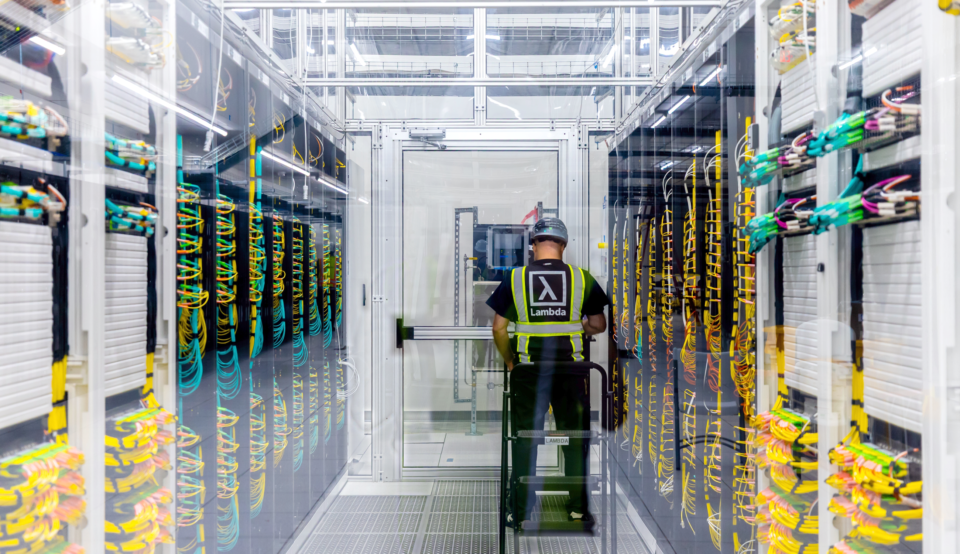
Lambda tối đa hóa hiệu suất trên mỗi Watt với NVIDIA DSX MaxLPS
Nhà cung cấp AI cloud Lambda đã công bố kết quả tại AI Infra Summit, cung cấp sự xác thực đầu tiên về NVIDIA DSX MaxLPS trên các máy chủ NVIDIA Blackwell.
DSX MaxLPS liên tục giám sát mức tiêu thụ điện năng trên các GPU và rack, chuyển dịch linh hoạt nguồn điện sẵn có đến nơi cần thiết nhất và thu hồi công suất mà việc cấp phát tĩnh thường bỏ phí. Vì khối lượng công việc huấn luyện và suy luận có các cấu hình năng lượng khác nhau, MaxLPS tối ưu hóa việc phân bổ năng lượng trên các AI factory có khối lượng công việc hỗn hợp.
Kết quả rất đáng kể: Lambda đã chạy 19 node trong cùng một ngân sách năng lượng thường chỉ cấp cho 16 node chạy toàn tải, giúp tăng lưu lượng token toàn cụm lên 24% — từ khoảng 4 triệu lên 5 triệu token mỗi giây — đồng thời cải thiện hiệu suất trên mỗi watt thêm 23%. Đối với các AI factory NVIDIA Vera Rubin NVL72 thế hệ tiếp theo, DSX MaxLPS có thể cho phép tăng tới 40% công suất GPU trong cùng một ngân sách megawatt tại các môi trường triển khai phù hợp.
Điều này có nghĩa là các nhà vận hành AI factory có thể tăng công suất AI và lưu lượng token trong cùng một hạn mức năng lượng, giúp tối đa hóa năng suất và giá trị kinh tế của mỗi megawatt.
Tìm hiểu thêm về kết quả của Lambda.
Thứ Ba, ngày 15 tháng 9, 9:55 sáng giờ PT 🔗
Vera Rubin và Groq 3 LPX chuyển hóa nhiều điện năng hơn thành token
Trong các AI factory, điện năng là yếu tố hạn chế. Mỗi watt đều quan trọng, vì vậy việc chắt lọc nhiều token hơn từ mỗi megawatt là điều quan trọng nhất đối với hạ tầng AI.
NVIDIA thực hiện điều này với một AI factory full-stack được xây dựng trên Vera Rubin NVL72 — hệ thống, mạng, phần mềm và quản lý năng lượng hoạt động như một thể thống nhất. Ở cấp độ nhà máy, NVIDIA DSX MaxLPS chuyển dịch năng lượng linh hoạt giữa các rack khi nhu cầu tăng hoặc giảm.
Lợi ích mang lại rất đáng kể:
Bên trong mỗi rack, phần mềm Intelligent Power Smoothing và bộ đệm năng lượng mở rộng giúp hấp thụ các xung đột biến ngắn, cho phép các hệ thống chạy gần với nhu cầu duy trì. Phần công suất dư thừa bị lãng phí nay trở thành năng lực tính toán hiệu quả.
Đối với agentic AI — nơi các tác nhân (agent) liên kết các bước suy luận và gọi công cụ — độ trễ và độ dài ngữ cảnh (context length) tăng lên rất nhanh. Đó là lúc NVIDIA Groq 3 LPX phát huy tác dụng, bổ sung khả năng suy luận độ trễ cực thấp mang tính xác định cho Vera Rubin và bổ trợ cho DSX MaxLPS. Nền tảng kết hợp này mang lại lưu lượng token trên mỗi megawatt cao gấp 35 lần so với GB200 NVL72 đối với các mô hình hơn 2 nghìn tỷ tham số ở ngữ cảnh dài.
Những con số đã nói lên tất cả. Trên khối lượng công việc Qwen 3.8 27B với ngữ cảnh 100K, Groq 3 LPX đạt 2.529 token đầu ra mỗi giây cho mỗi người dùng. Khoảng dư thừa đó cho phép các tác nhân thực hiện nhiều bước suy luận và gọi công cụ hơn trong cùng một ngân sách phản hồi, ngay cả khi khối lượng công việc tăng lên.
Tìm hiểu thêm về cách NVIDIA Vera Rubin NVL72 và Groq 3 LPX có thể tạo ra nhiều token hơn với ít điện năng hơn.
Thứ Ba, ngày 15 tháng 9, 9:55 sáng giờ PT 🔗
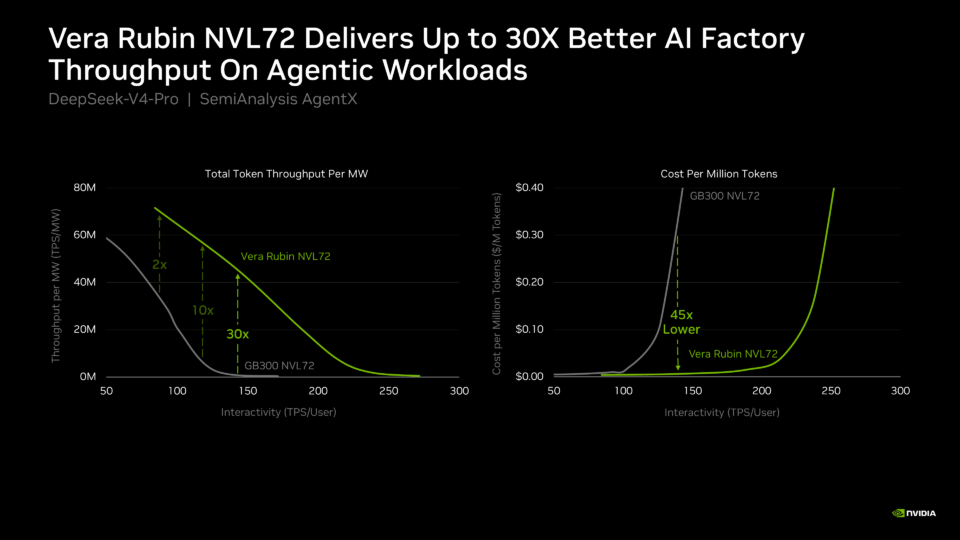
Vera Rubin NVL72 mang lại lưu lượng AI factory tốt hơn 30 lần trên SemiAnalysis AgentX
SemiAnalysis AgentX đo lường khả năng suy luận trên các phiên lập trình agentic thực tế đã được ghi lại, với sự tăng trưởng ngữ cảnh, độ trễ gọi công cụ và việc tạo ra các tác nhân phụ (sub-agent) được bảo toàn, thay vì dựa trên các bài kiểm tra đơn lẻ. Kết quả hiệu suất agentic của NVIDIA Vera Rubin NVL72 hiện đã có trên bảng điều khiển SemiAnalysis AgentX. Trên mô hình DeepSeek V4 Pro, Vera Rubin NVL72 mang lại lưu lượng trên mỗi megawatt cao gấp 30 lần so với NVIDIA GB300 NVL72.
Bài viết được AI dịch và tổng hợp tự động từ NVIDIA Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.