Hôm nay · 28/09

Thứ Hai · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnCấu trúc mHC trên DeepSeek-V4-Flash: Các luồng dư thừa có thực sự hiệu quả?

Nghiên cứu chỉ ra rằng các luồng dư (residual streams) trong kiến trúc mHC của DeepSeek-V4-Flash không được sử dụng đồng đều, với các tầng sâu gần như trở thành ma trận đơn vị, cho thấy sự lãng phí tài nguyên tính toán đáng kể.


Vì sao đáng đọc: Phân tích kỹ thuật chuyên sâu về kiến trúc mô hình AI hiện đại, cung cấp bằng chứng thực nghiệm giá trị cho cộng đồng nghiên cứu về tối ưu hóa Transformer.

26/09

Thứ Bảy · 1 tin
Ma Dongxi NLP@dongxi_nlp
Sản phẩmĐiểm AI 40/100

Cùng sự kiệnClaude Code kết hợp Opus 5.5 tạo video giải thích Transformer cực đỉnh

Chuyên gia NLP Ma Dongxi cho biết Claude Code và Opus 5.5 đã tạo ra video giải thích về Transformer chỉ với một câu lệnh, vượt xa hiệu quả so với việc kết hợp GPT-6 cùng các công cụ chuyên dụng như Manim hay Excalidraw.

Cùng sự kiện, bài đại diện «Claude Opus 5.5 tạo video giải thích về đệ quy đầy sáng tạo»

25/09

Thứ Sáu · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Transformer có thể chứa hai luồng tư duy cùng lúc: Bằng chứng về sự chồng chất tuyến tính trong LLM

Nghiên cứu chứng minh Transformer có khả năng xử lý đồng thời hai luồng văn bản thông qua sự chồng chất tuyến tính, cho phép giải mã song song hai kết quả từ một lần chạy duy nhất.

24/09

Thứ Năm · 1 tin

22/09

Thứ Ba · 2 tin

21/09

Thứ Hai · 1 tin
Kim@kimmonismus
Quan điểmĐiểm AI 26/100

Từ dự ngôn của Nick Bostrom đến kỷ nguyên siêu trí tuệ: 9 năm thay đổi thế giới

Reading the opening pages of Bostrom's *Superintelligence*, it is remarkable to think that as recent…

DịchNhìn lại cuốn 'Superintelligence' năm 2015, sự ra đời của kiến trúc Transformer năm 2017 đã đẩy nhanh tiến trình phát triển, biến viễn cảnh siêu trí tuệ trở thành hiện thực ngay trong năm nay.

18/09

Thứ Sáu · 2 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnTPAMI 2026: PolaFormer++ nâng tầm cơ chế chú ý tuyến tính với tính toán phân cực và độ nhọn cấp kênh

PolaFormer++ cải tiến cơ chế chú ý tuyến tính bằng cách tối ưu hóa ánh xạ đặc trưng thông qua tính toán phân cực và độ nhọn cấp kênh, giúp đạt hiệu suất vượt trội trên nhiều tác vụ thị giác máy tính.


Vì sao đáng đọc: Nghiên cứu được đăng trên tạp chí uy tín TPAMI, giải quyết bài toán cốt lõi về hiệu suất của Transformer, có mã nguồn mở và tính ứng dụng cao trong xử lý dữ liệu lớn.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 36/100

FAMOS: Mô hình dự đoán khớp nối vật thể 3D từ dữ liệu quan sát thưa thớt

FAMOS là mô hình Transformer tiên phong giúp dự đoán phân đoạn bộ phận và tham số khớp nối của vật thể 3D từ các đám mây điểm rời rạc, hỗ trợ linh hoạt ngay cả với dữ liệu đầu vào từ một góc nhìn duy nhất.

16/09

Thứ Tư · 1 tin

15/09

Thứ Ba · 4 tin
IBM Research: AI
NgànhĐiểm AI 45/100

IBM Research chứng minh ưu thế vượt trội của mạch lượng tử nông so với mô hình ngôn ngữ lớn

Nghiên cứu mới từ IBM chỉ ra rằng các mạch lượng tử độ sâu thấp có thể giải quyết những bài toán tính toán phức tạp mà các mô hình Transformer như GPT hay Llama cần nguồn lực khổng lồ mới xử lý được, khẳng định ranh giới lý thuyết giữa hai công nghệ.

JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnGiải mã GPT-6 Astra: Sebastian Raschka phân tích sâu về kiến trúc Transformer vòng lặp và tư duy ẩn

Chuyên gia Sebastian Raschka làm rõ tranh cãi về kiến trúc 'Transformer vòng lặp' trên GPT-6 Astra, khẳng định công nghệ này không làm giảm khả năng giám sát tư duy của AI như đồn đoán.


Vì sao đáng đọc: Bài viết phân tích kỹ thuật chuyên sâu từ chuyên gia uy tín, giải tỏa các tin đồn gây hoang mang về an toàn AI, rất giá trị cho cộng đồng kỹ thuật.

14/09

Thứ Hai · 4 tin
AK@_akhaliq
NgànhĐiểm AI 22/100

SAS: Tối ưu hóa end-to-end cho việc xếp hạng ngữ cảnh trong cơ chế Sparse Attention

SAS Simple Attention Sparsification via End-to-End Optimization of Context Ranking paper: https://...

DịchNghiên cứu giới thiệu SAS, một phương pháp mới giúp tối ưu hóa hiệu quả tính toán của cơ chế chú ý (attention) thông qua việc xếp hạng ngữ cảnh end-to-end, giúp mô hình xử lý dữ liệu nhanh và tinh gọn hơn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SAS: Tối ưu hóa trực tiếp việc chọn lọc ngữ cảnh để tinh giản cơ chế Attention trong Transformer

SAS là phương pháp mới giúp tinh giản cơ chế Attention bằng cách tối ưu hóa trực tiếp việc chọn lọc token quan trọng, thay vì chỉ bắt chước phân phối trọng số của mô hình gốc, giúp sử dụng hiệu quả hơn ngân sách tính toán hạn chế.

MarkTechPost
NgànhĐiểm AI 33/100

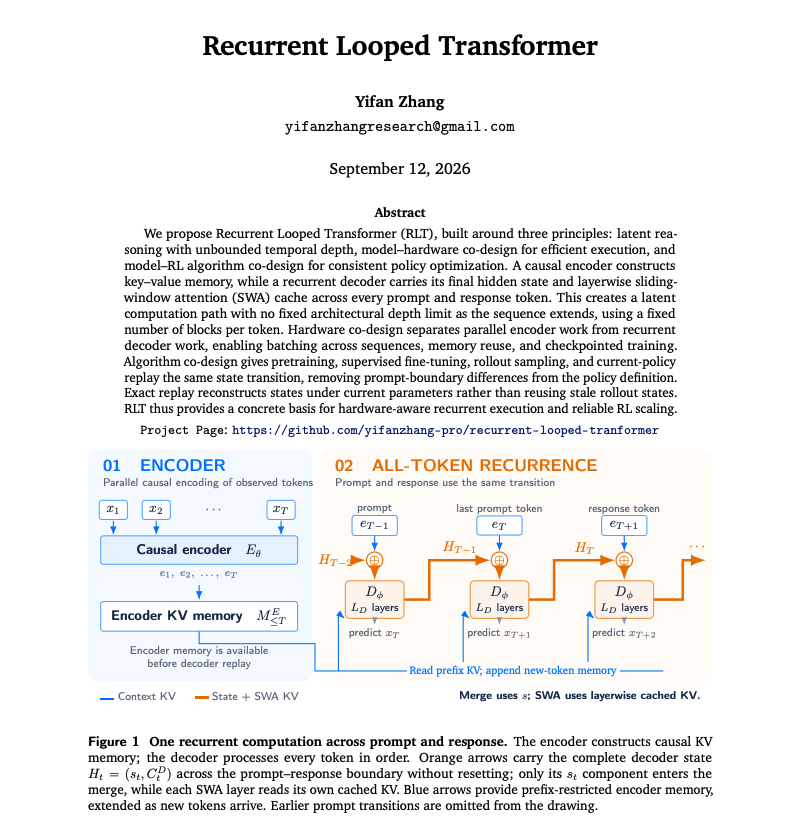
Đại học Princeton giới thiệu Recurrent Looped Transformer (RLT): Đột phá kiến trúc với cơ chế truyền trạng thái liên tục

Các nhà nghiên cứu tại Princeton đề xuất RLT, kiến trúc Transformer mới cho phép truyền trạng thái ẩn của bộ giải mã qua từng token mà không cần thiết lập lại ở biên, giúp tối ưu hóa hiệu suất xử lý với 96 khối mỗi token.

Elvis Saravia@omarsar0
NgànhĐiểm AI 33/100

RLT: Đề xuất kiến trúc Transformer với cơ chế lặp qua từng token

Looped transformers are a popular architecture topic right now. This new technical report extends t…

DịchRLT (Recurrent Looped Transformer) đề xuất tái sử dụng bộ giải mã cho từng token, giúp duy trì chi phí tính toán ổn định bất kể độ dài chuỗi. Dù hứa hẹn về hiệu suất, đây hiện mới chỉ là ý tưởng thiết kế chưa qua thực nghiệm.

13/09

Chủ Nhật · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 33/100

Khung toán học cho mạch Transformer (2021): Nền tảng của khả năng diễn giải AI

Nghiên cứu kinh điển này thiết lập khung toán học để phân tích cơ chế bên trong của Transformer, giúp giải mã cách các đầu chú ý (attention heads) và luồng dư (residual streams) vận hành. Đây là tài liệu nền tảng quan trọng cho lĩnh vực nghiên cứu khả năng diễn giải mô hình AI.

SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 43/100

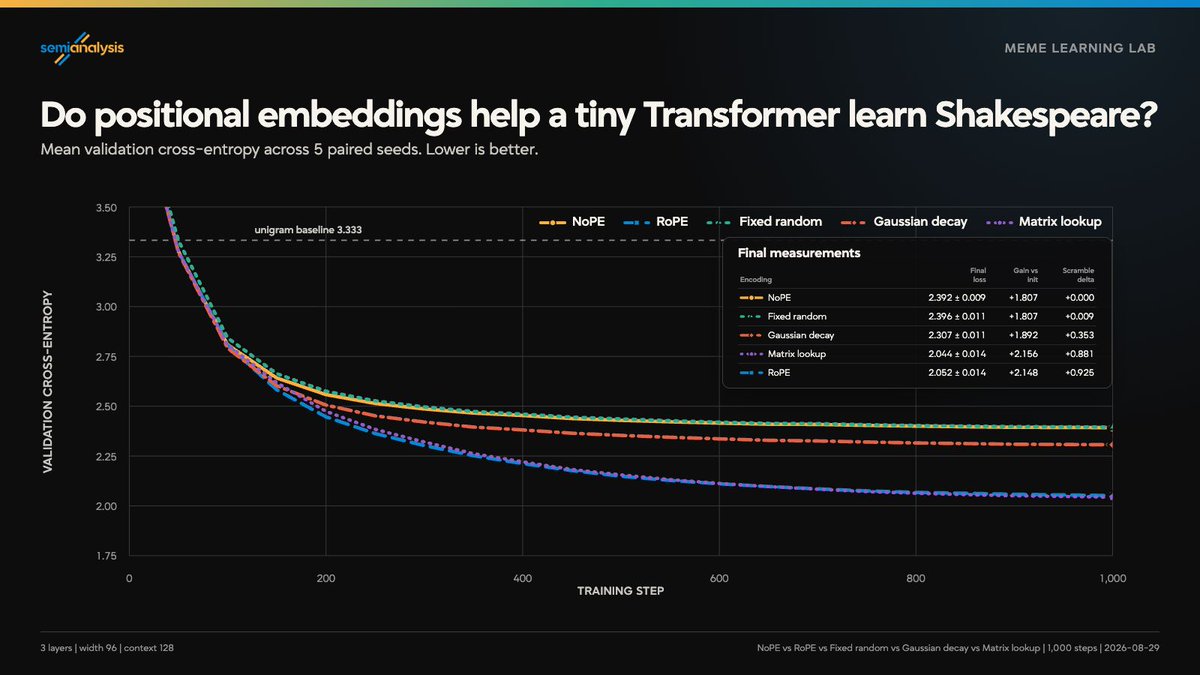
Khám phá các ràng buộc toán học và khả năng tổng quát hóa của cơ chế nhúng vị trí (Position Embedding)

Attention has no innate notion of time. Positional embeddings are how language models tell how far a…

DịchBài viết phân tích cách các mô hình ngôn ngữ sử dụng nhúng vị trí để hiểu khoảng cách giữa các token, đồng thời đặt câu hỏi liệu việc nới lỏng các ràng buộc toán học truyền thống có mở ra không gian hàm mới hiệu quả hơn hay không.

11/09

Thứ Sáu · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 48/100

FreeFlow: Transformer phân cấp đột phá, thiết lập kỷ lục mới cho bài toán ước tính luồng quang học

Nhóm nghiên cứu từ ĐH Quốc gia Moscow giới thiệu FreeFlow, kiến trúc Transformer tinh gọn không cần các thành phần chuyên dụng như warping hay volume tương quan, đạt hiệu suất dẫn đầu trên các bộ dữ liệu Sintel, KITTI-2015 và Spring.

10/09

Thứ Năm · 5 tin
Cohere@cohere
NgànhĐiểm AI 27/100

Cohere ra mắt North Small Translate: Mô hình dịch thuật mã nguồn mở hiệu năng cao

Originally, the Transformer paper was proposed to improve Google Translate. 9 years later, as the AI…

DịchSau 9 năm kể từ khi kiến trúc Transformer ra đời, Cohere giới thiệu North Small Translate, mô hình dịch thuật máy tiên tiến hướng tới cộng đồng mã nguồn mở.

Thêm 1 nguồn khác đưa tinMarkTechPost
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGraph Machine: Đột phá kiến trúc mới giúp tối ưu hóa tiền huấn luyện mô hình ngôn ngữ

Graph Machine (GM) là kiến trúc mới sử dụng các 'cạnh' (edges) linh hoạt để truy xuất dữ liệu, giúp duy trì độ phức tạp O(n) mà vẫn đảm bảo tính thưa thớt hiệu quả. Phương pháp này cho phép thay thế phần lớn các lớp Transformer truyền thống với hiệu suất vượt trội và chi phí tính toán thấp.


Vì sao đáng đọc: Đây là một nghiên cứu kỹ thuật chuyên sâu có tiềm năng thay đổi cách thiết kế kiến trúc mô hình ngôn ngữ, giúp giảm tài nguyên tính toán mà vẫn giữ được độ chính xác.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RenderFormer-V2: Mô hình kết xuất thần kinh dựa trên Transformer với các nguyên mẫu cảnh đa dạng

RenderFormer-V2 là mô hình kết xuất thần kinh thống nhất, xử lý hiệu quả các hiệu ứng ánh sáng phức tạp như khúc xạ và tán xạ mà không cần huấn luyện riêng cho từng cảnh, nhờ cơ chế chú ý cải tiến giúp tăng khả năng mở rộng.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 38/100

NOAH: Mô hình AI đa phương thức dự báo toàn diện lộ trình điều trị bệnh nhân

NOAH là mô hình Transformer thế hệ mới có khả năng xử lý đồng thời hình ảnh y tế, dữ liệu thời gian và hồ sơ bệnh án để dự báo chính xác lộ trình điều trị của bệnh nhân dựa trên dữ liệu từ hàng trăm nghìn ca lâm sàng.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 78/100

Giải mã GPT-6 Astra: Kiến trúc Transformer vòng lặp và khả năng suy luận ẩn

GPT-6 Astra thiết lập chuẩn mực mới với hiệu suất vượt trội trong dựng hình 3D, hoạt họa và điều khiển máy tính, đạt điểm số gần như tuyệt đối 99,9% trong bài kiểm tra ARC-AGI-3.

Diễn biến sự kiện · 2 bài →

09/09

Thứ Tư · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnRelightFormer: Transformer tạo ảnh thế hệ mới cho kỹ thuật chiếu sáng vật thể đa góc nhìn

RelightFormer là mô hình Transformer đột phá giúp tái chiếu sáng vật thể từ một hoặc nhiều góc nhìn mà không cần ước tính các thuộc tính vật lý phức tạp. Bằng cách tận dụng dữ liệu từ bộ dataset LOD khổng lồ, mô hình đạt độ chính xác cao trong việc mô phỏng tương tác ánh sáng 3D.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong lĩnh vực đồ họa máy tính và AI tạo sinh, giải quyết bài toán khó về chiếu sáng 3D bằng cách bỏ qua các quy trình render truyền thống.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Giải mã tư duy Transformer: Khi nào mô hình thực sự hiểu trình độ của đối phương?

Nghiên cứu khám phá khoảng cách giữa việc mô hình nhận diện thông tin và thời điểm sử dụng chúng. Kết quả cho thấy dù mô hình sớm nhận diện được trình độ chuyên môn của đối tác, nhưng phải đến các lớp sâu hơn thông tin này mới thực sự tác động đến phản hồi.

08/09

Thứ Ba · 2 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 85/100

Looped Transformer có thực sự mạnh hơn? Câu trả lời từ nghiên cứu của Thanh Hoa và ByteDance

Nghiên cứu SMELT từ Đại học Thanh Hoa và ByteDance giải mã hiệu năng của Looped Transformer bằng cách so sánh công bằng về chi phí tính toán, tham số và KV cache, khẳng định tiềm năng của việc tái sử dụng các lớp mạng thay vì chỉ tăng quy mô mô hình.

Elvis Saravia@omarsar0
NgànhĐiểm AI 34/100

Trải nghiệm tương tác với các bài báo khoa học AI thông qua GPT-6 Astra

Testing GPT-6 Astra on visualizing popular AI papers. Started with this beautifully generated inte…

DịchKhám phá cách thức mới để tiếp cận nghiên cứu AI thông qua phiên bản tương tác của các bài báo Transformer trên GPT-6 Astra, giúp việc đọc và hiểu tài liệu chuyên sâu trở nên trực quan hơn.

07/09

Thứ Hai · 2 tin

05/09

Thứ Bảy · 1 tin

04/09

Thứ Sáu · 2 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Google DeepMind và KAIST giới thiệu Declarative Attention: Cho phép mô hình tự kiểm soát phạm vi chú ý

Banger paper from Google DeepMind and colleagues. (bookmark it) A model reads its entire KV cache …

DịchNghiên cứu mới từ Google DeepMind và KAIST đề xuất phương pháp Declarative Attention, giúp các mô hình ngôn ngữ tự điều chỉnh cơ chế chú ý trong quá trình suy luận chuỗi, từ đó cải thiện độ chính xác.

02/09

Thứ Tư · 3 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 71/100

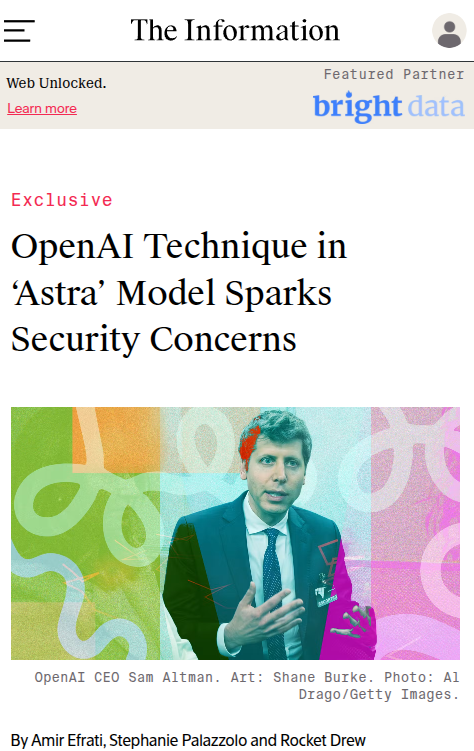
OpenAI Astra được cho là sử dụng kiến trúc 'vòng lặp', làm dấy lên lo ngại về tính minh bạch và an toàn

The information reports Astra reportedly uses "recurrent depth, " or a "looped transformer, " which he…

DịchTheo The Information, mô hình Astra của OpenAI áp dụng kiến trúc recurrent depth (transformer lặp), cho phép xử lý thông tin nhiều lần qua cùng một lớp để tăng hiệu suất tính toán mà không cần thêm tham số, gây khó khăn cho việc kiểm soát và giải mã logic suy luận.

Cohere@cohere
Hướng dẫnĐiểm AI 32/100

Nhìn lại hành trình của Transformer: Từ kỳ vọng khiêm tốn đến cột mốc hơn 280.000 trích dẫn

In 2017, the team who submitted the Transformer architecture was hoping for "hundreds of citations" …

DịchCohere vừa chia sẻ về sự ra đời của kiến trúc Transformer năm 2017, khi đội ngũ tác giả chỉ kỳ vọng vài trăm trích dẫn nhưng nay đã đạt con số kỷ lục 281.654, đánh dấu bước ngoặt lịch sử cho cuộc cách mạng AI.

01/09

Thứ Ba · 1 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (68 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Transformer” | AIHOT.vn