Mô hình
BottleCap AI ra mắt ThinkingCap-Qwen3.8-27B: Giảm 37,2% token suy luận với độ chính xác tối ưu
(giờ Việt Nam)
Tóm tắt AI
BottleCap AI giới thiệu ThinkingCap-Qwen3.8-27B, phiên bản tinh chỉnh từ Qwen3.8-27B giúp cắt giảm 37,2% token suy luận trên 12 bộ tiêu chuẩn, trong khi độ chính xác chỉ giảm nhẹ 0,86 điểm phần trăm.
Chính văn · Bản dịch AI
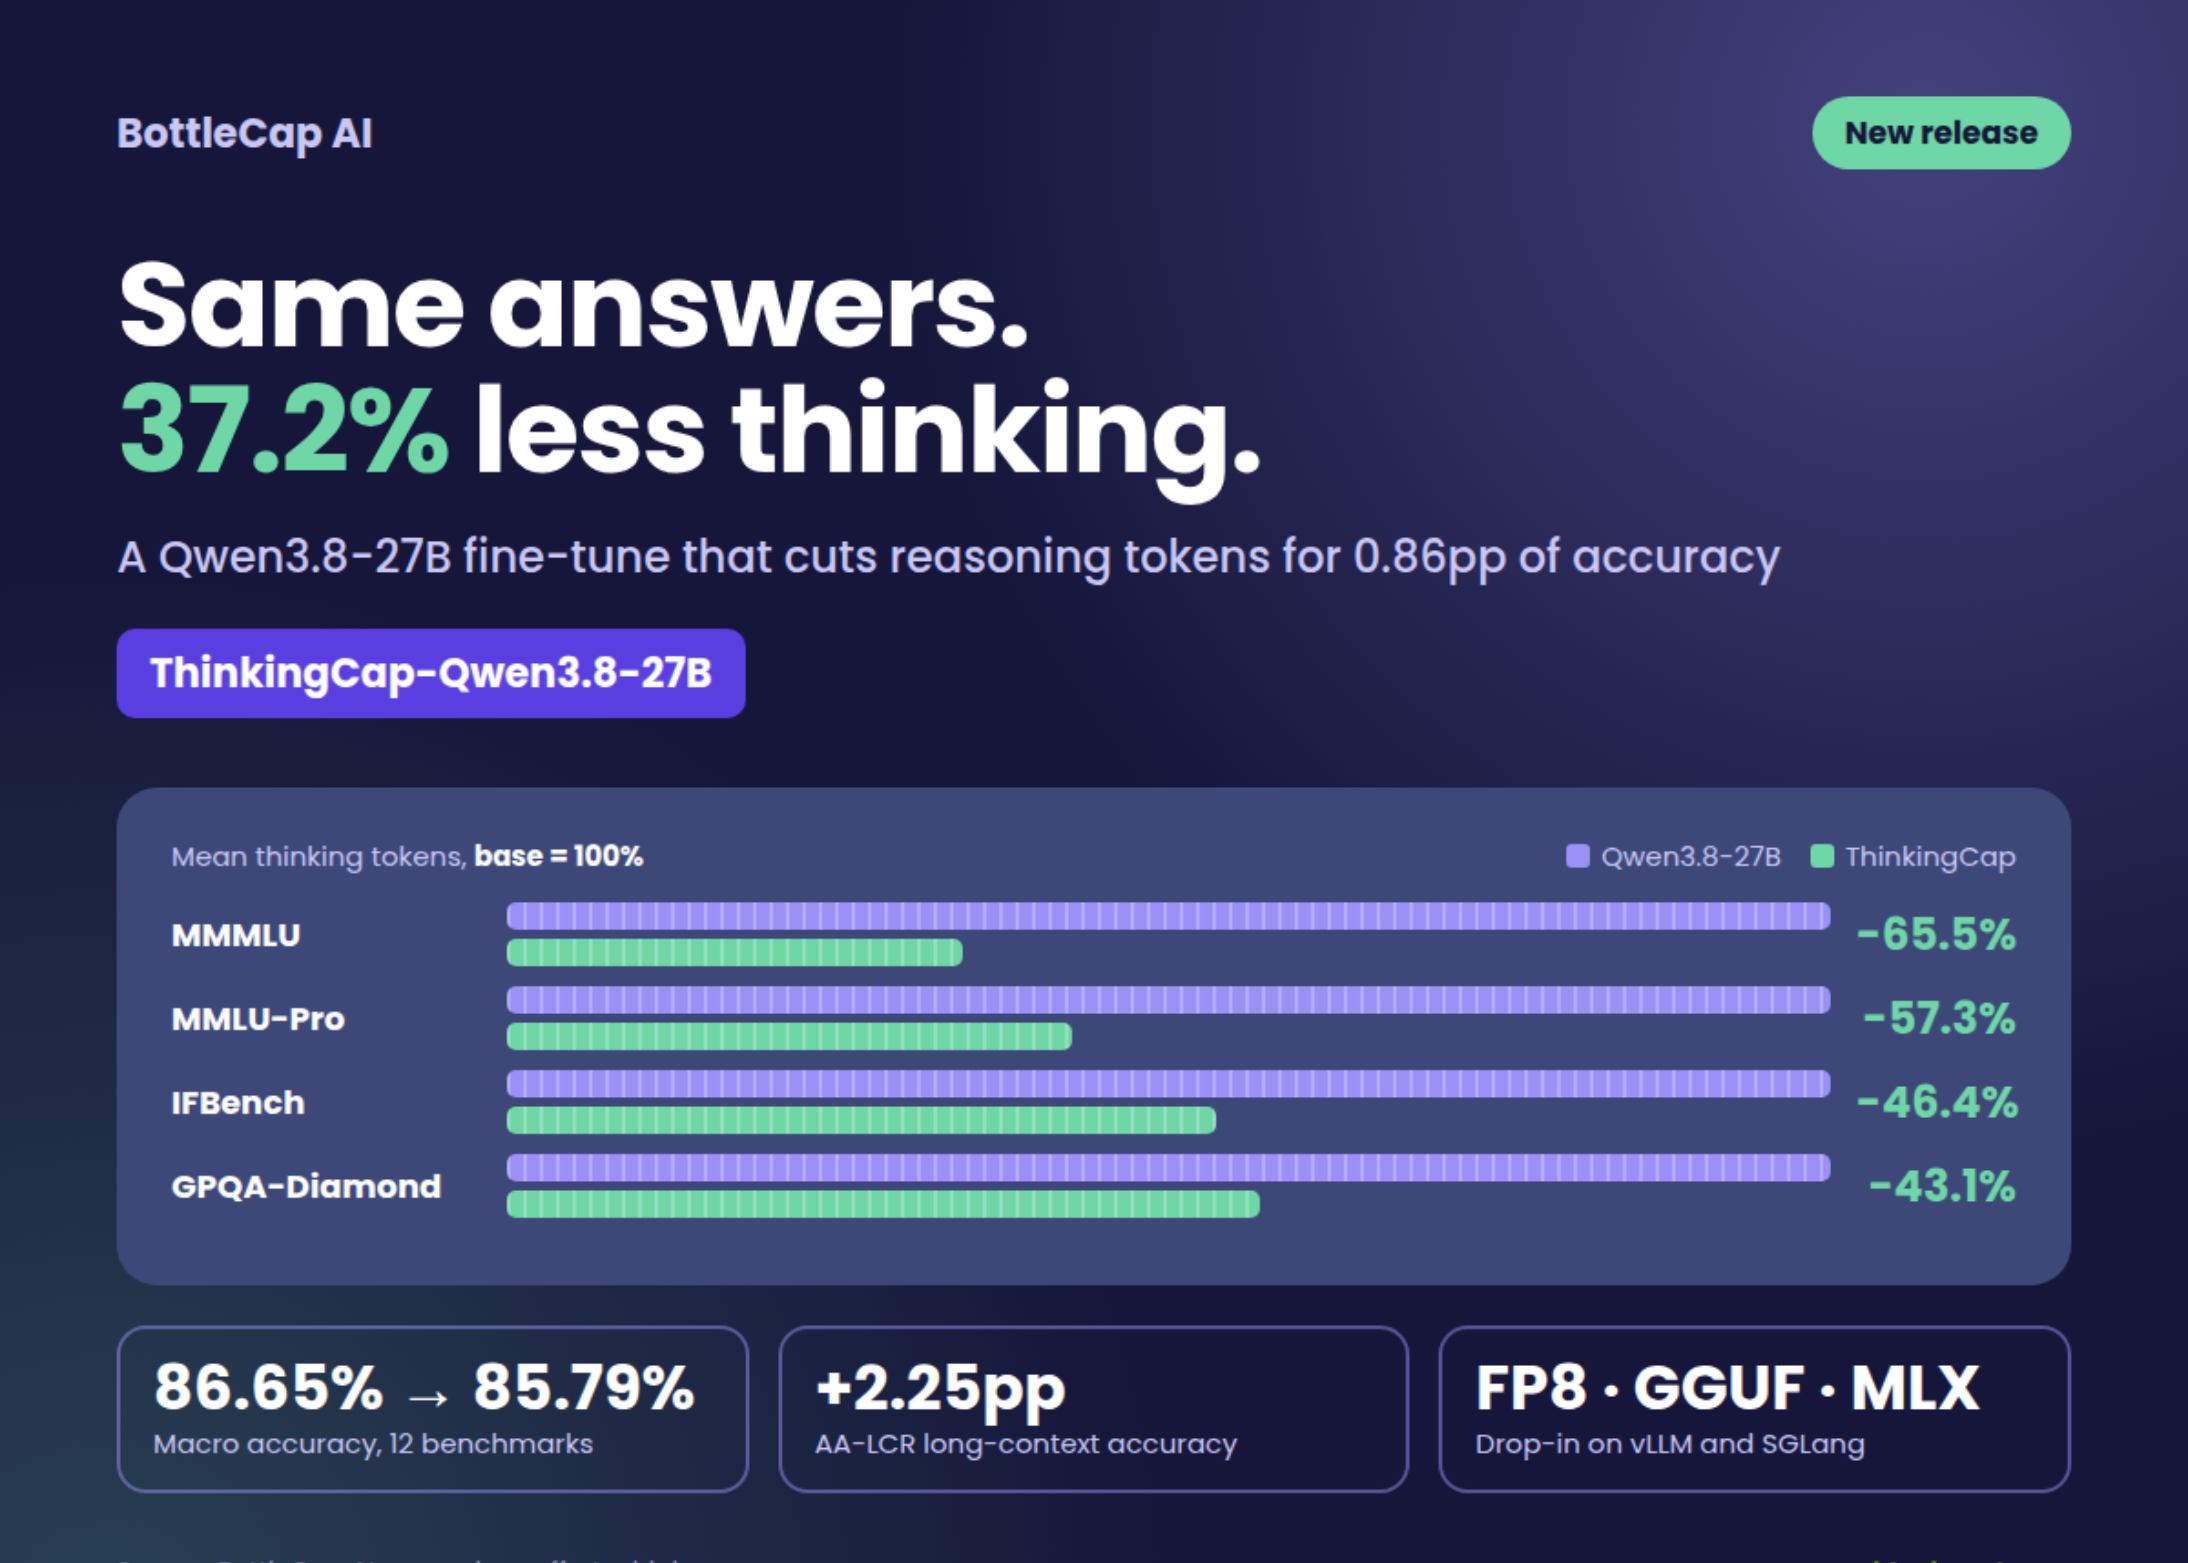
BottleCap AI vừa phát hành ThinkingCap-Qwen3.8-27B, mô hình thứ hai trong dòng ThinkingCap. Đây là phiên bản tinh chỉnh (fine-tune) của Qwen3.8-27B từ đội ngũ Qwen với một mục tiêu duy nhất: rút ngắn các bước suy luận. Trên 12 bộ tiêu chuẩn đánh giá (benchmark), mô hình tiêu tốn trung bình ít hơn 37,2% token suy luận. Độ chính xác trung bình vĩ mô giảm từ 86,65% xuống 85,79%, tương đương mức giảm 0,86 điểm phần trăm (pp).
Có thể triển khai được không? Có. Nó có thể thay thế trực tiếp cho Qwen3.8-27B trên vLLM hoặc SGLang, với các bản dựng FP8, NVFP4, GGUF và MLX. Kho lưu trữ (repo) được kiểm soát quyền truy cập, và việc sử dụng thương mại ngoài giấy phép doanh nghiệp nhỏ cần có thỏa thuận với BottleCap.
ThinkingCap nhắm đến vấn đề gì?
Các mô hình suy luận thường tiêu tốn nhiều token suy luận hơn mức cần thiết cho một câu hỏi. Quan điểm của BottleCap là nhiều token dư thừa đó không làm thay đổi câu trả lời cuối cùng. Bản phát hành đầu tiên trong dòng đã áp dụng ý tưởng này cho Qwen3.6-27B.
Mục tiêu lần này được đặt ra một cách thận trọng. BottleCap không cố gắng bổ sung kiến thức hay thay đổi phong cách trả lời. Khả năng suy luận, tuân thủ chỉ dẫn và hành vi an toàn được giữ nguyên. Đội ngũ nghiên cứu cũng tập trung mạnh hơn vào các tiêu chuẩn đánh giá về toán học, suy luận, ngữ cảnh dài và tác nhân (agentic).
Kết quả Benchmark ở mức nỗ lực xhigh
Tất cả các con số chính đều sử dụng reasoning_effort=xhigh, thiết lập mặc định của chat template. Mọi tiêu chuẩn đánh giá đều có độ dài ngắn hơn, với mức cắt giảm từ 10,7% đến 65,5%.
Các tác vụ kiến thức và đa ngôn ngữ giảm nhiều nhất. MMMLU giảm 65,5% (từ 1.656 xuống 571 token) và MMLU-Pro giảm 57,3%. GPQA-Diamond giảm từ 12.772 xuống 7.267 token, mức cắt giảm 43,1%. IFBench suy luận ít hơn 46,4% với độ chính xác gần như không đổi (từ 79,75% xuống 79,71%).
Khả năng truy xuất ngữ cảnh dài được cải thiện. Độ chính xác AA-LCR tăng 2,25pp, từ 81,75% lên 84,00%, với số token suy luận ít hơn 38,6%. LiveCodeBench v6 tăng nhẹ 0,07pp trong khi suy luận ít hơn 20,3%.
Kết quả về tác nhân (agentic) vẫn sát với mô hình gốc. τ²-bench giảm 1,01pp với mức cắt giảm 30,9%. Terminal-Bench 2.1 giảm 0,56pp, nằm trong khoảng sai số ±4,26, với mức cắt giảm 10,7%.
Sự đánh đổi đắt giá nhất là AIME 2026. Độ chính xác giảm 3,85pp, từ 98,13% xuống 94,27%, đổi lại việc suy luận ít hơn 30,2%.
Lưu ý rằng con số 37,2% là giá trị trung bình của mức giảm trên 12 tiêu chuẩn đánh giá. Tổng số token suy luận trung bình giảm từ 15.735 xuống 12.144.
BottleCap cũng báo cáo về đường cong ngân sách. Với giới hạn 16K token mỗi phản hồi, ThinkingCap đạt điểm cao hơn mô hình gốc. Các bước suy luận bị cắt ngắn giảm từ 0,51% xuống 0,34%, và hiện tượng lặp lại giảm từ 0,06% xuống 0,05%.
Cách thức tương tác với thanh điều chỉnh nỗ lực (Effort Dial)
Qwen3.8-27B cung cấp thiết lập reasoning-effort, và khả năng nén hoạt động cộng hưởng với thiết lập này. Tất cả các thay đổi (delta) dưới đây so sánh với mô hình gốc ở mức xhigh, tính trung bình trên 11 tiêu chuẩn đánh giá.
Ở mức medium, mô hình gốc cắt giảm 52,1% suy luận với -9,16pp. ThinkingCap cắt giảm 60,2% với -9,90pp. Ở mức low, các con số là -55,4% và -9,71pp cho mô hình gốc, so với -62,3% và -10,79pp cho ThinkingCap. Khi tắt tính năng suy luận, ThinkingCap thấp hơn mô hình gốc 5,7pp.
Đội ngũ BottleCap khuyến nghị dùng xhigh để có sự cân bằng tốt nhất giữa độ chính xác và số lượng token. Họ cho biết các chế độ suy luận riêng lẻ sẽ được chú trọng trong bản phát hành tương lai.
Cách thức thực hiện đánh giá
Cả hai mô hình đều chạy qua cùng một bộ công cụ trên một máy NVIDIA H200 với vLLM 0.29.0. Các tham số lấy mẫu (sampling) giống hệt nhau: temperature 1.0, top_p 0.95, top_k 20, min_p 0.0. Độ chính xác đa hạt giống (multi-seed) là giá trị trung bình với khoảng tin cậy 95%. Số lượng hạt giống dao động từ 32 trên AIME 2026 đến 1 trên MMLU-Pro và MMMLU. MMMLU sử dụng tập mẫu cố định 10.000 câu hỏi; 11 tiêu chuẩn còn lại chạy toàn bộ tập dữ liệu.
Giải mã suy đoán MTP (3 token dự thảo) được đo lường là trung tính về độ chính xác trên AIME 2026. Nó chấp nhận 53% token dự thảo, khoảng 2,6 token mỗi bước, tương đương với mô hình gốc.
Triển khai: Các bản dựng, Phục vụ và Giấy phép
Checkpoint bf16 có 28 tỷ tham số và chấp nhận đầu vào là hình ảnh và văn bản. BottleCap xuất bản 5 bản dựng đã lượng tử hóa:
- FP8: 31 GB, vLLM, Hopper và Blackwell.
- NVFP4 weight-only: 21 GB, vLLM, Hopper (nhân Marlin) và Blackwell.
- NVFP4 W4A4 (AWQ): 23 GB, chỉ dành cho Blackwell.
- GGUF: 16 đến 55 GB, cho llama.cpp, LM Studio và Ollama.
- MLX 4-bit DWQ: 21 GB, cho máy Mac Apple Silicon với 32 GB RAM.
Việc phục vụ sử dụng công thức của mô hình gốc: --reasoning-parser qwen3 với trình phân tích cú pháp qwen3_xml tool-call trên vLLM. Suy luận được trả về trong một trường reasoning riêng biệt.
Giấy phép là PolyForm Small Business 1.0.0 cộng với quyền sử dụng cá nhân từ BottleCap. Các tài liệu Qwen gốc vẫn tuân theo Apache-2.0. Hugging Face hiện chưa liệt kê nhà cung cấp dịch vụ suy luận nào lưu trữ mô hình này.
Các điểm chính
- Trung bình ít hơn 37,2% token suy luận trên 12 tiêu chuẩn đánh giá.
- Độ chính xác vĩ mô giảm 0,86pp, từ 86,65% xuống 85,79%.
- Độ chính xác ngữ cảnh dài AA-LCR tăng 2,25pp; AIME 2026 giảm 3,85pp.
- Thay thế trực tiếp cho Qwen3.8-27B: cùng cách lấy mẫu, cùng cờ vLLM hoặc SGLang.
- Trọng số được kiểm soát quyền truy cập theo PolyForm Small Business; sử dụng thương mại cần có giấy phép.
Xem blog kỹ thuật và trọng số mô hình. Mọi công lao thuộc về nhà nghiên cứu của dự án này. Ngoài ra, hãy theo dõi chúng tôi trên Twitter, tham gia SubReddit 150k+ ML và đăng ký bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá GitHub Repo, Trang Hugging Face, Phát hành sản phẩm hoặc Hội thảo trực tuyến của bạn? Kết nối với chúng tôi

Michal Sutter
Michal Sutter là một chuyên gia khoa học dữ liệu với bằng Thạc sĩ Khoa học Dữ liệu từ Đại học Padova. Với nền tảng vững chắc về phân tích thống kê, học máy và kỹ thuật dữ liệu, Michal xuất sắc trong việc chuyển đổi các tập dữ liệu phức tạp thành những thông tin chi tiết có thể hành động.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.