Nghiên cứu
Perplexity huấn luyện AI Agent tự học từ sai lầm thực tế bằng phương pháp OPSD
(giờ Việt Nam)
Tóm tắt AI
Perplexity giới thiệu kỹ thuật OPSD kết hợp tinh chỉnh từ chối lấy mẫu, sử dụng dữ liệu từ các phiên làm việc thực tế của Perplexity Computer (chạy trên GLM 5.2) để giúp AI tự rút kinh nghiệm từ những lỗi sai.
Chính văn · Bản dịch AI
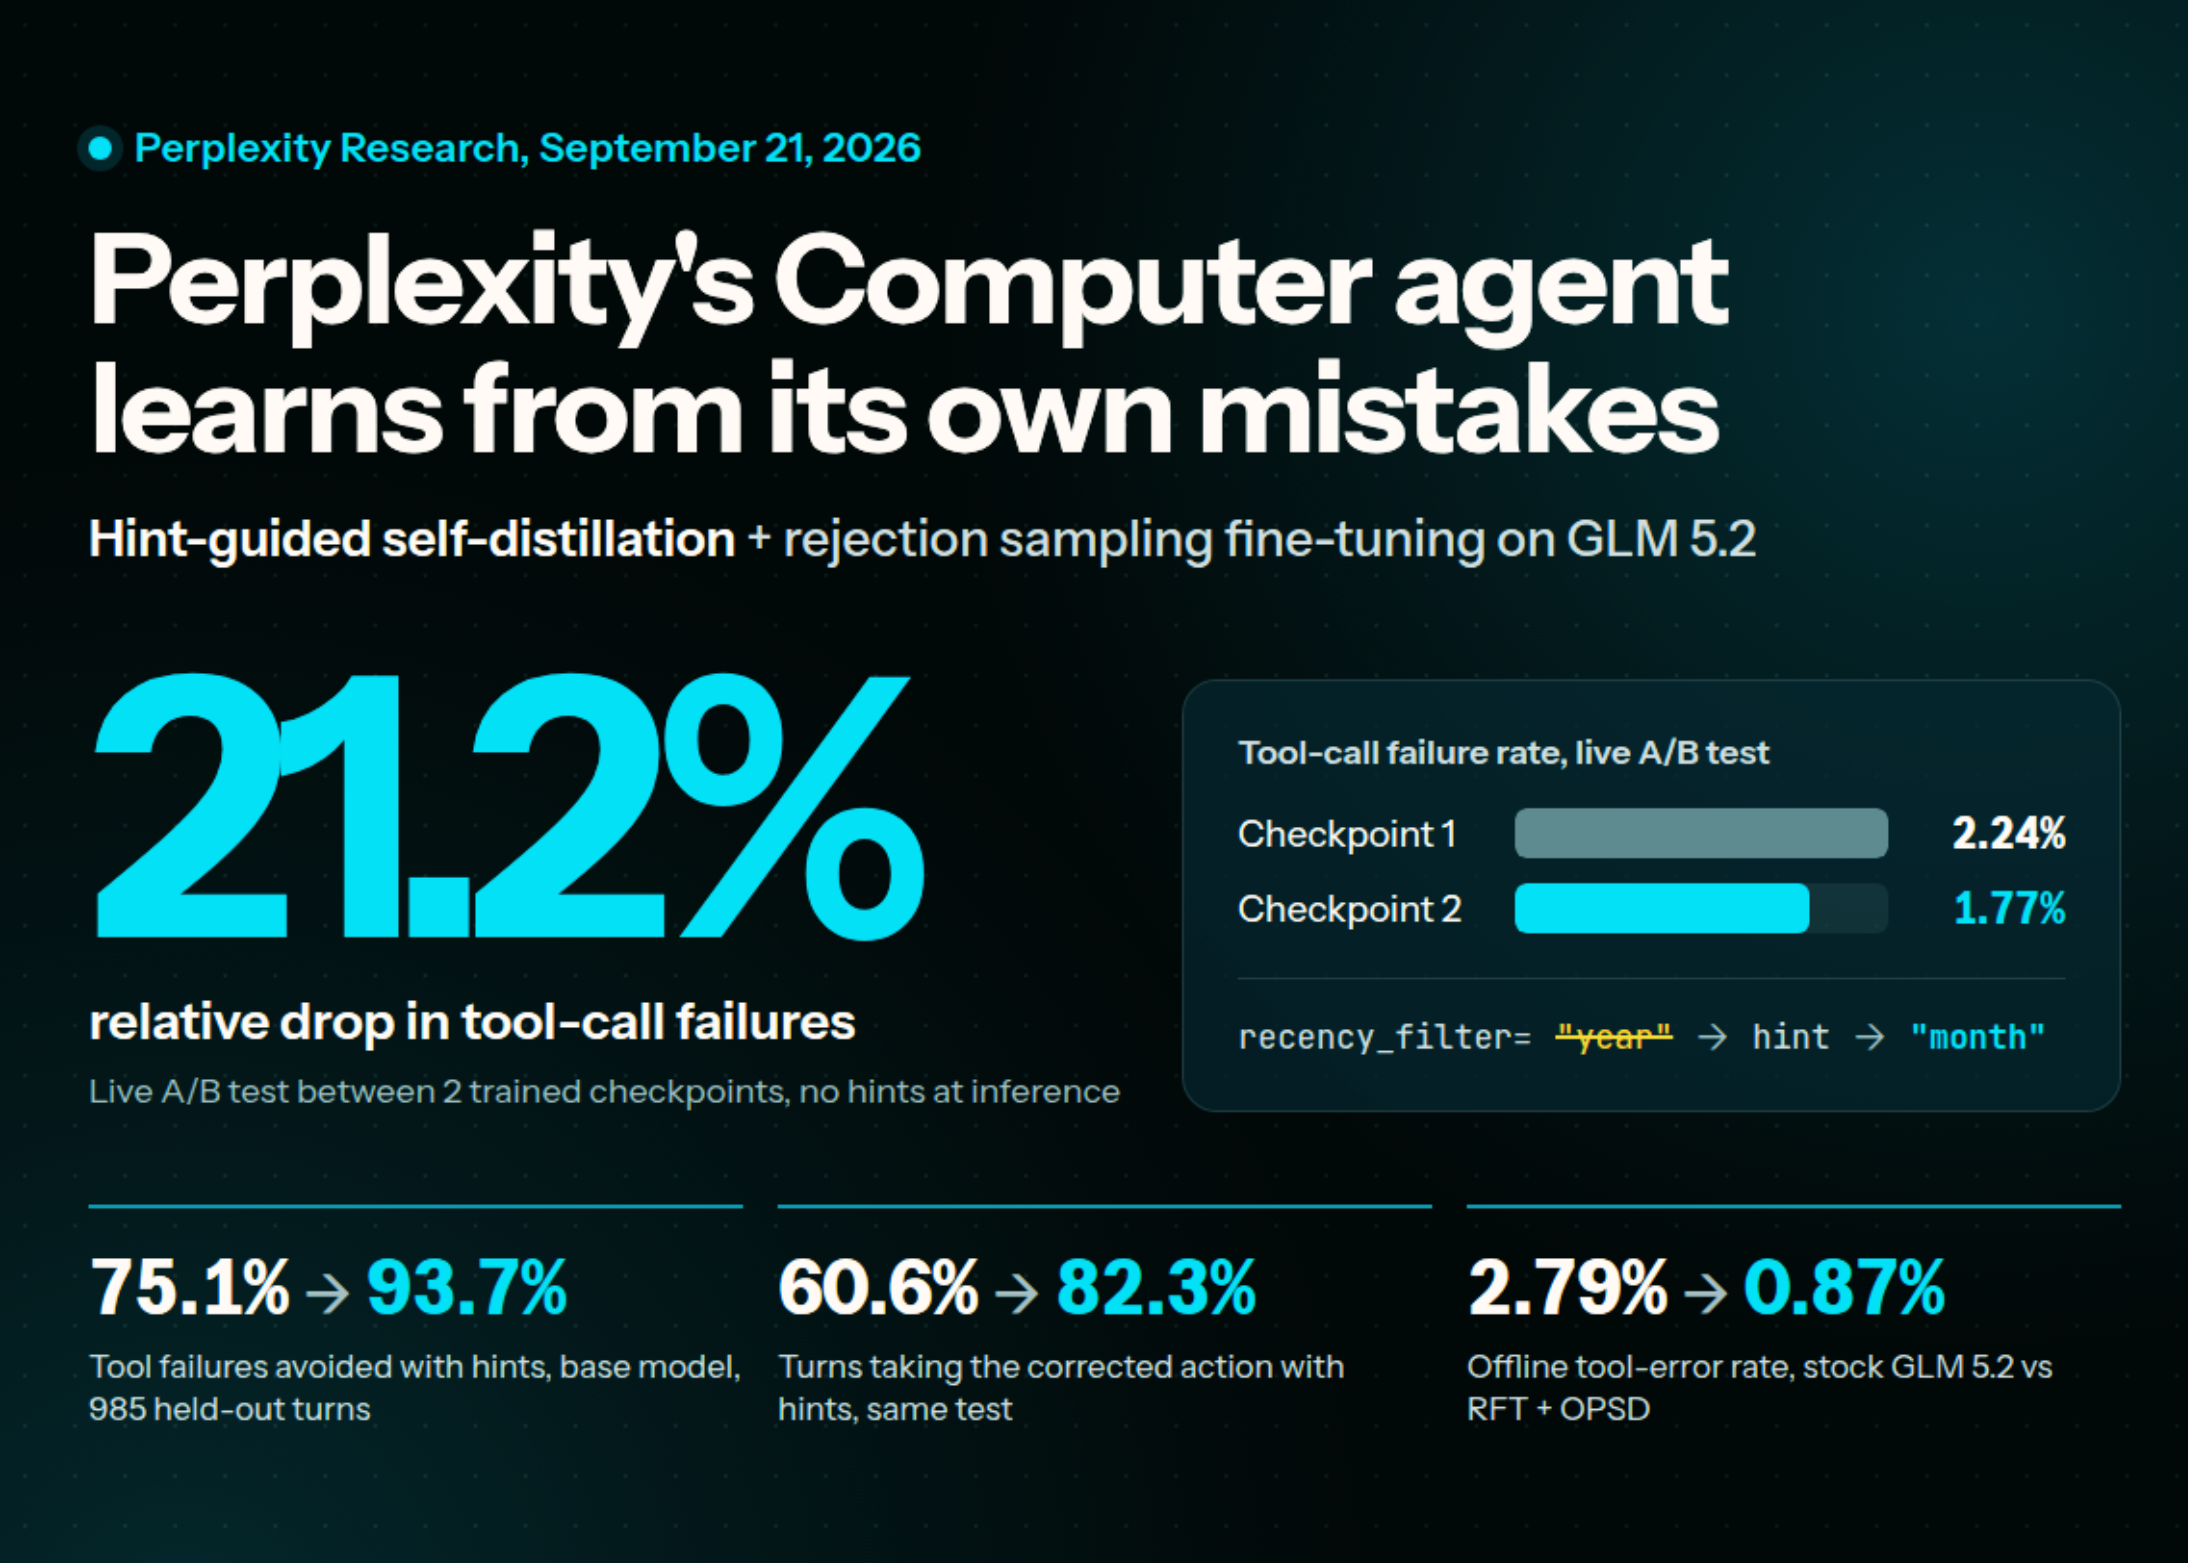
Perplexity Research vừa công bố một nghiên cứu mới về hậu huấn luyện (post-training). Họ huấn luyện một mô hình bên trong Perplexity Computer dựa trên các phiên làm việc thực tế của người dùng, bao gồm cả những phiên thất bại. Phương pháp này kết hợp giữa tinh chỉnh bằng lấy mẫu từ chối (rejection sampling fine-tuning) và tự chưng cất có hướng dẫn bằng gợi ý (hint-guided self-distillation). Trong một thử nghiệm A/B trực tiếp, tỷ lệ lỗi gọi công cụ (tool-call) đã giảm từ 2,24% xuống 1,77% giữa 2 điểm kiểm tra (checkpoint) đã được huấn luyện. Nhóm Perplexity báo cáo đây là mức giảm tương đối 21,2%, có ý nghĩa thống kê.
Liệu nó có thể triển khai được không? Không trực tiếp. Perplexity chưa phát hành trọng số sau huấn luyện hoặc mã nguồn huấn luyện. Mô hình chỉ chạy như một tùy chọn mô hình bên trong Perplexity Computer. Mô hình cơ sở, GLM 5.2, được cung cấp công khai trên Hugging Face.
Tại sao việc lọc chỉ dựa trên kết quả đầu ra là chưa đủ
Tinh chỉnh bằng lấy mẫu từ chối (RFT) tiêu chuẩn đánh giá từng phiên và chỉ bắt chước những phiên thành công. Một kết quả thành công không có nghĩa là mọi bước đều đúng. Một tác nhân (agent) có thể phục hồi sau một lần gọi công cụ sai và vẫn đưa ra câu trả lời đúng. Việc bắt chước toàn bộ quỹ đạo đó có thể củng cố lỗi sai. Việc loại bỏ các phiên thất bại cũng làm mất đi bằng chứng rõ ràng về những sai lầm có thể tránh được.
Bắt chước, Sửa lỗi hoặc Giữ làm ngữ cảnh
Nhóm Perplexity tách biệt 2 quyết định: phiên nào chứa hành vi đáng để bắt chước, và lượt (turn) nào chứa lỗi sai đáng để sửa.
Mỗi lượt của trợ lý nhận 1 trong 3 cách xử lý:
- Bắt chước: các lượt không có lỗi trong các phiên thành công sẽ nhận hàm mất mát cross-entropy (CE).
- Sửa lỗi: các lượt có lỗi kèm theo gợi ý đã được xác thực sẽ nhận hàm mất mát phân kỳ Kullback-Leibler (KL), trong bất kỳ phiên nào.
- Giữ làm ngữ cảnh: các lượt còn lại vẫn nằm trong đầu vào nhưng không nhận hàm mất mát nào.
Các phiên thành công có thể cung cấp cả mục tiêu bắt chước và sửa lỗi. Các phiên không thành công chỉ cung cấp mục tiêu sửa lỗi.
Cách một gợi ý trở thành tín hiệu huấn luyện
Gợi ý là một hướng dẫn sửa lỗi ngắn gọn dựa trên thông tin mà mô hình đã có. Trong một ví dụ, một lệnh tìm kiếm đặt recency_filter là ‘year’. Lược đồ (schema) chỉ cho phép ‘day’, ‘week’ hoặc ‘month’. Gợi ý nêu tên lệnh gọi bị lỗi, bao gồm lỗi xác thực và đề xuất một giá trị được phép hoặc bỏ qua trường tùy chọn đó.
Phần sửa lỗi sử dụng Tự chưng cất theo chính sách (On-Policy Self-Distillation) (OPSD). Trình huấn luyện chạy cùng một checkpoint GLM 5.2 hai lần trên lượt được ghi lại. Lượt giáo viên (teacher pass) nhìn thấy gợi ý; lượt học sinh (student pass) thì không. Cả hai đều sử dụng teacher forcing, vì vậy không có câu trả lời thay thế nào được tạo ra. Xác suất token tiếp theo của giáo viên được tách rời và đóng vai trò là mục tiêu mềm (soft target) thông qua KL tiến.
Hàm mất mát kết hợp là (CE + λ × KL), chia cho số lượng token được bắt chước. Việc đặt λ bằng 0 sẽ khôi phục SFT tiêu chuẩn. Thành phần CE rất quan trọng. Huấn luyện chỉ dựa trên sửa lỗi có thể khiến giáo viên và học sinh đồng ý với nhau bằng cách bỏ qua ngữ cảnh.
Truy vết khiếu nại đến lỗi thực sự
Đường ống (pipeline) lấy dữ liệu từ các phiên Computer đủ điều kiện huấn luyện được phục vụ bởi GLM 5.2. Các phiên có thông tin nhận dạng cá nhân và người dùng chọn không tham gia đều bị loại trừ. Một LLM đóng vai trò giám khảo giữ lại các tác vụ được đánh giá 4 hoặc 5 trên thang độ khó 5 điểm. Hai LLM giám khảo phải cùng phê duyệt kết quả cuối cùng để một phiên được tính là thành công.
Đối với phản hồi của người dùng, ba LLM giám khảo xác định lượt gây ra lỗi và ít nhất 2 giám khảo phải đồng ý. Điều này rất quan trọng vì lượt trợ lý cuối cùng trước khi có khiếu nại chỉ là nguyên nhân gốc rễ trong khoảng một nửa số trường hợp. Mỗi gợi ý cũng được kiểm tra dựa trên thông tin có sẵn trước khi xảy ra lỗi. Việc kiểm tra đó giúp giảm bớt thiên kiến nhìn lại (hindsight bias).
Một ví dụ: người dùng hỏi về ‘w3’ của họ trên Paychex. Mô hình cho rằng đó là lỗi đánh máy của W-2 và tìm kiếm sai biểu mẫu. Gợi ý nhắm vào cách hiểu sai trước đó, không chỉ là câu trả lời cuối cùng.
Các đánh giá cho thấy điều gì
- Gợi ý hoạt động hiệu quả trước khi huấn luyện: Trên 985 lượt lỗi công cụ được giữ lại, mô hình cơ sở không thay đổi đã tránh được lỗi ban đầu trong 93,7% trường hợp khi có gợi ý, tăng từ 75,1%. Tỷ lệ thực hiện hành động sửa lỗi tăng từ 60,6% lên 82,3%. Đối với các lượt phản hồi của người dùng, tỷ lệ sửa lỗi hoặc đi đúng hướng tăng từ 40,0% lên 75,0% đối với bằng chứng rõ ràng. Đối với ý định suy luận, tỷ lệ này tăng từ 32,5% lên 80,0%.
- Lỗi công cụ ngoại tuyến đã giảm: Tỷ lệ lỗi công cụ được ghi lại là 2,79% đối với GLM 5.2 gốc và 1,35% chỉ với RFT. Checkpoint RFT cộng OPSD đạt mức 0,87%. Perplexity lưu ý rằng các checkpoint này sử dụng dữ liệu huấn luyện khác nhau, vì vậy đây không phải là một phép so sánh loại trừ (ablation) tương đương. Kết quả điểm chuẩn ở cấp độ tác vụ trên các bộ như BrowseComp và SpreadsheetBench có kết quả trái chiều.
- Kết quả trực tiếp hẹp hơn: Mỗi thử nghiệm A/B sử dụng khoảng 100.000 người dùng cho mỗi điều kiện. Một checkpoint sớm so với GLM 5.2 gốc cho thấy tỷ lệ lỗi là 2,82% so với 2,94%, không có ý nghĩa thống kê. So sánh checkpoint muộn hơn tạo ra mức giảm 21,2% đáng kể, không cần gợi ý khi suy luận. Mức độ không hài lòng mạnh mẽ chuyển từ 2,58% sang 2,54%, cũng không có ý nghĩa thống kê. Perplexity không so sánh trực tiếp checkpoint muộn hơn với GLM 5.2 gốc trực tuyến.
Những điểm chính
- Perplexity học hỏi từ các phiên thất bại, không chỉ các phiên thành công.
- Các gợi ý đã xác thực biến những sai lầm có thể tránh được thành mục tiêu sửa lỗi KL.
- 1 mô hình đóng vai trò là giáo viên (có gợi ý) và học sinh (không có gợi ý).
- Tỷ lệ lỗi gọi công cụ trực tiếp giảm từ 2,24% xuống 1,77%.
- Sự không hài lòng của người dùng không cho thấy thay đổi đáng kể.
Xem Chi tiết kỹ thuật. Mọi công lao thuộc về nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit 150k+ ML của chúng tôi và Đăng ký Bản tin của chúng tôi. Khoan đã! bạn có dùng telegram không? bây giờ bạn cũng có thể tham gia cùng chúng tôi trên telegram.
Cần hợp tác với chúng tôi để quảng bá GitHub Repo HOẶC Trang Hugging Face HOẶC Ra mắt sản phẩm HOẶC Hội thảo trực tuyến, v.v.? Kết nối với chúng tôi

Michal Sutter
Michal Sutter là một chuyên gia khoa học dữ liệu với bằng Thạc sĩ Khoa học Dữ liệu từ Đại học Padova. Với nền tảng vững chắc về phân tích thống kê, học máy và kỹ thuật dữ liệu, Michal xuất sắc trong việc chuyển đổi các tập dữ liệu phức tạp thành những thông tin chi tiết có thể hành động.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.