🚀 FIT-GGUF brings controllable-size mixed-precision quantization to MiniCPM5-2B Developer @Scorp1o_…
DịchCông cụ FIT-GGUF cho phép người dùng MiniCPM5-2B tùy chỉnh dung lượng file hoặc độ chính xác mong muốn. Hệ thống sẽ tự động phân bổ độ phân giải cho từng tensor, đồng thời dự đoán và xác thực file GGUF đầu ra.
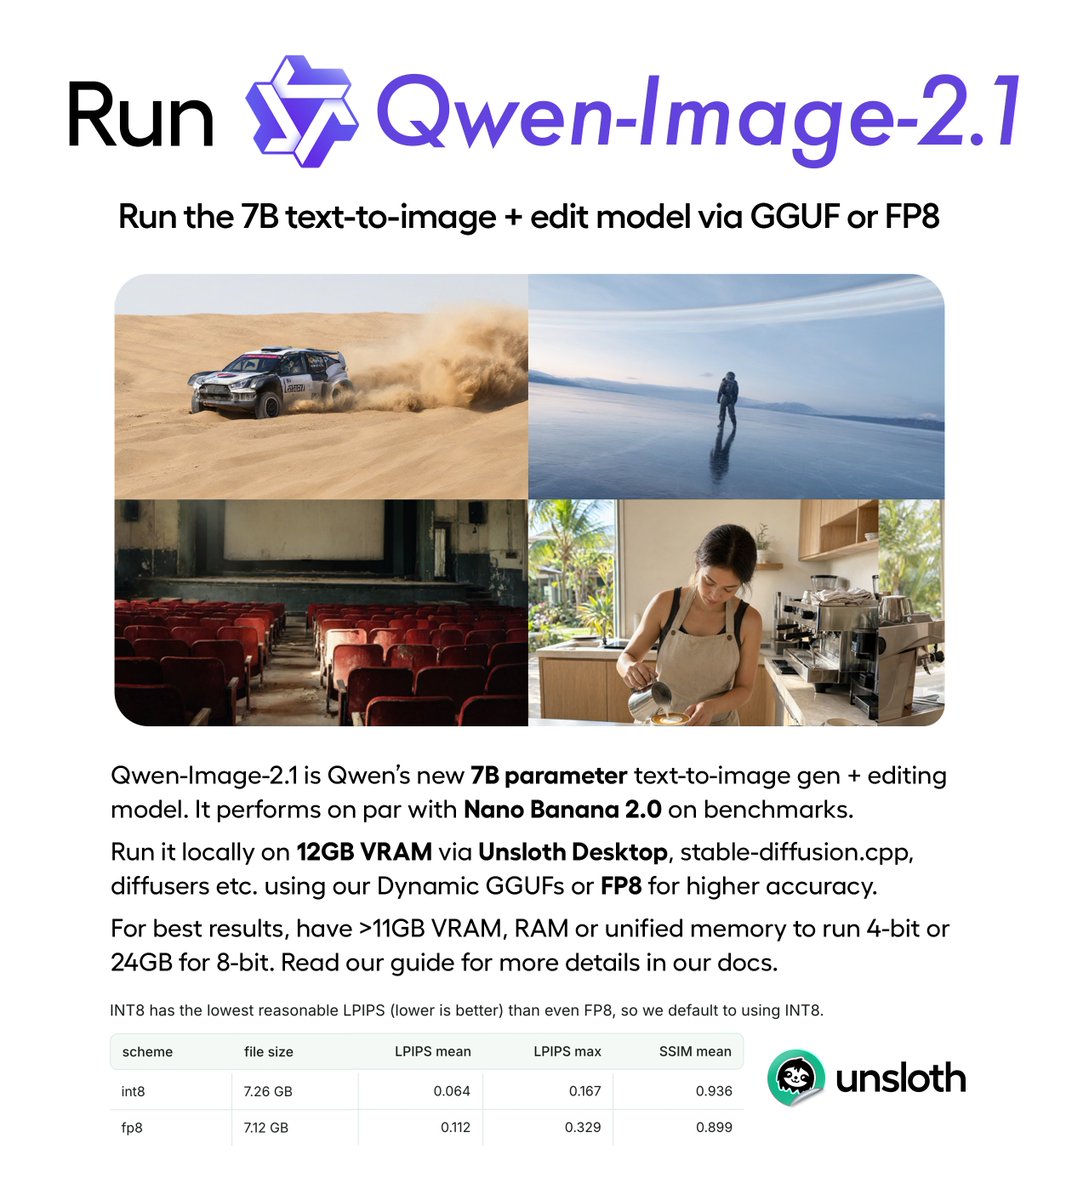
Qwen-Image-2.1 can now run locally on 12GB VRAM with Unsloth GGUFs! 🖼️ The 7B model performs on pa…
DịchUnsloth vừa phát hành phiên bản lượng tử hóa GGUF cho mô hình Qwen-Image-2.1, cho phép chạy cục bộ trên các thiết bị có VRAM 12GB với hiệu suất ngang ngửa Nano Banana 2.0.
Hugging Face đã cập nhật thư viện Transformers, cho phép người dùng tải trực tiếp các mô hình GGUF từ Hub thông qua hàm from_pretrained và tận dụng tối ưu hóa từ nhân Metal của ggml.
Vì sao đáng đọc: Đây là cập nhật quan trọng giúp đơn giản hóa quy trình triển khai mô hình AI cục bộ, kết hợp sức mạnh của hệ sinh thái Hugging Face với hiệu suất tối ưu của llama.cpp.
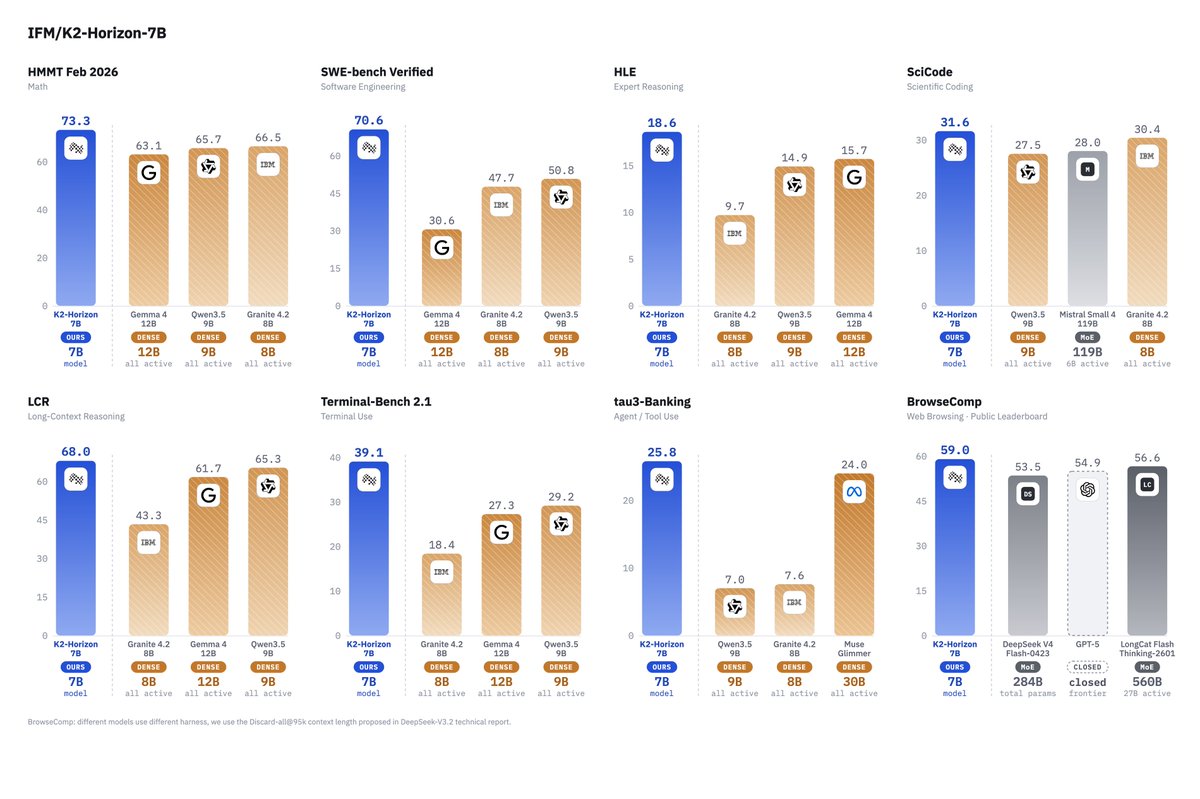
@UnslothAI guys, we need unsloth/K2-Horizon-7B-GGUF-UD-Q4_K_XL.gguf
DịchNgười dùng trên X đang tích cực yêu cầu Unsloth sớm ra mắt định dạng GGUF (Q4_K_XL) cho mô hình K2-Horizon-7B để tối ưu hóa hiệu suất chạy trên các thiết bị cá nhân.
Unsloth vừa giới thiệu định dạng Dynamic 3.0 GGUF, tập trung vào việc cải thiện hiệu suất và khả năng tương thích cho các mô hình ngôn ngữ lớn khi chạy trên thiết bị cá nhân.
Atomic has released Dynamic Quants for Qwen3.8-27B-GGUF, a quantized version of Qwen3.8 27B, compres…
DịchAtomic vừa phát hành phiên bản Qwen3.8-27B với công nghệ nén GGUF động, giảm dung lượng từ 28.9GB xuống chỉ còn 8.5GB. Đáng chú ý, phiên bản AD-IQ3_S có thể chạy mượt trên MacBook Air 16GB mà vẫn giữ được 92.4% độ chính xác so với bản gốc BF16.
27B on 17GB RAM. Are you ready to create something incredible? 😎 Thanks for highlighting it! @Unslo…
DịchNhờ công nghệ Unsloth Dynamic GGUF, mô hình Qwen2.5-27B mạnh mẽ nhất trong phân khúc hiện đã có thể vận hành mượt mà trên máy tính cá nhân với yêu cầu RAM tối thiểu chỉ 17GB.
 ModelBest OpenBMB@OpenBMB