Thủ thuật
Giải mã các định dạng mô hình LLM phổ biến: GGUF, GPTQ, AWQ và EXL2 (2026)
(giờ Việt Nam)
Tóm tắt AI
Bài viết tổng hợp từ MarkTechPost giúp phân biệt rõ ràng giữa các định dạng lưu trữ và phương pháp lượng tử hóa LLM, đồng thời giải thích chi tiết cơ chế hoạt động của GGUF, GPTQ, AWQ và EXL2/EXL3.
Bản dịch AI
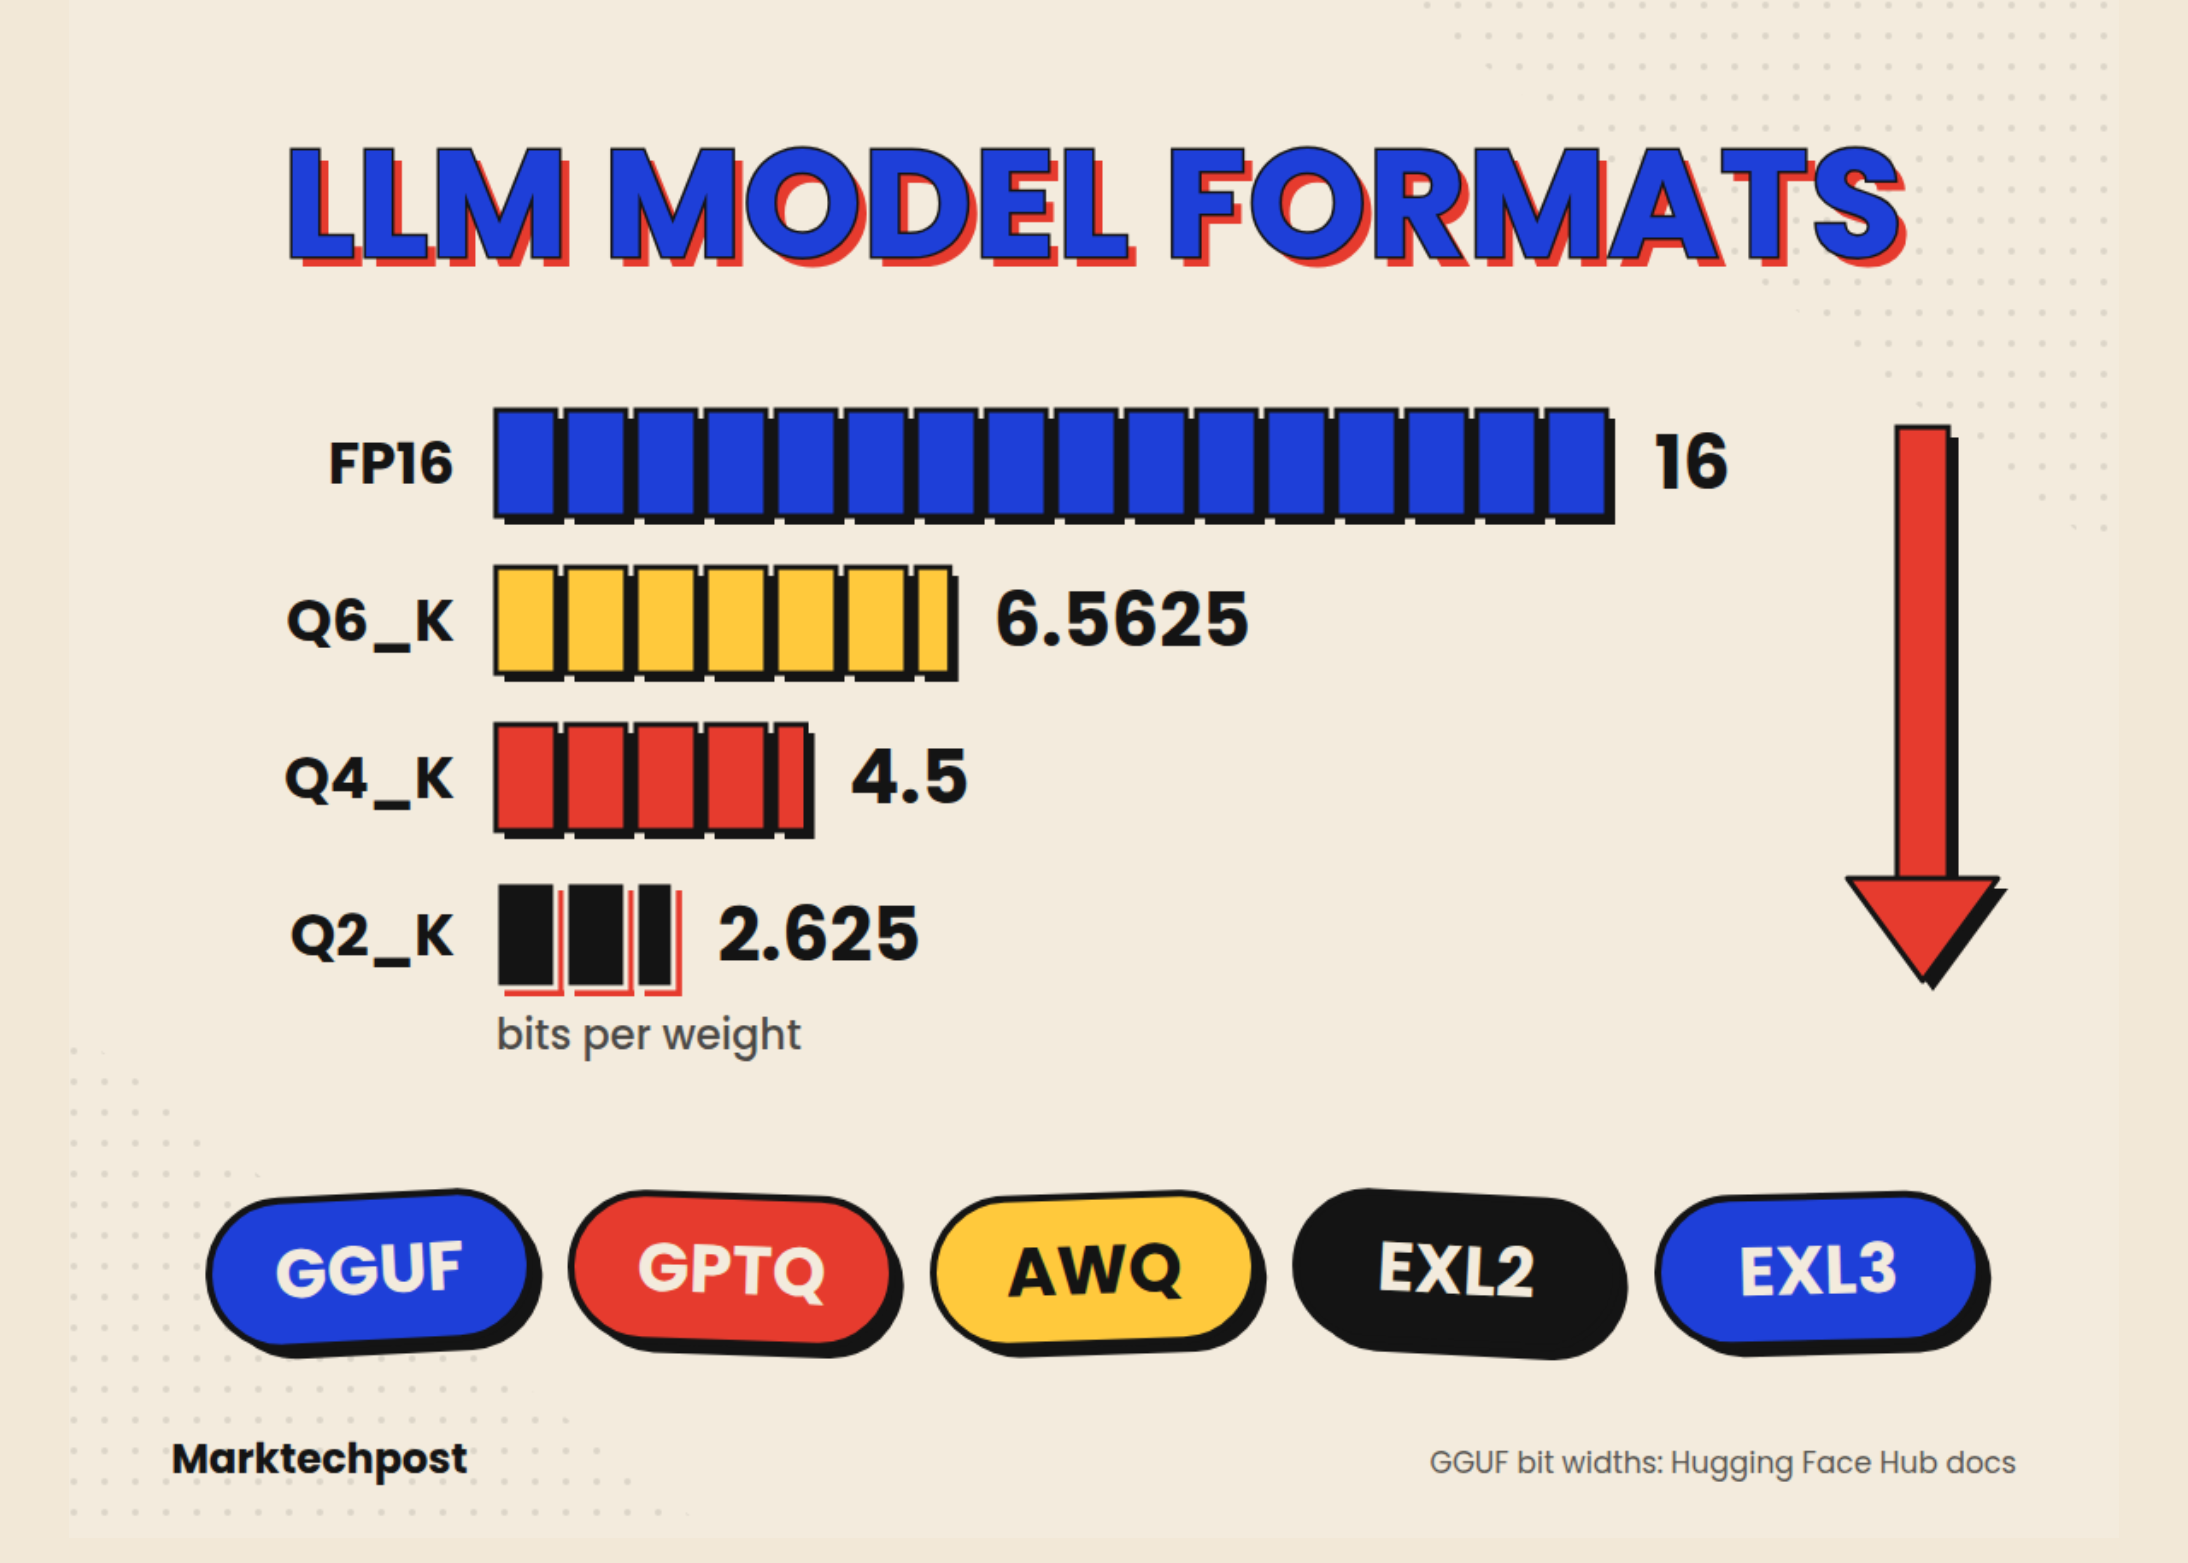
Trước hết, hãy tách biệt 2 khái niệm: container (định dạng lưu trữ) và phương pháp lượng tử hóa (quantization methods).
Hầu hết sự nhầm lẫn đến từ việc trộn lẫn 2 lớp này.
Một container xác định cách các tensor được lưu trữ trên ổ đĩa. Một phương pháp lượng tử hóa xác định cách các trọng số (weights) được nén vào ít bit hơn.
Quy tắc tính nhanh bộ nhớ
Bộ nhớ trọng số ≈ số tham số × số bit mỗi trọng số ÷ 8.
Đây là phép tính số học, không phải điểm chuẩn của nhà cung cấp. Nó chỉ bao gồm các trọng số. Bộ nhớ đệm KV (KV cache) và chi phí vận hành (runtime overhead) sẽ làm tăng thêm dung lượng cần thiết.
1. Độ chính xác đầy đủ (Full precision): safetensors và PyTorch.bin
Các mô hình chưa lượng tử hóa thường được phân phối dưới dạng trọng số 16-bit, trong tệp pytorch_model.bin hoặc model.safetensors.
Các tệp.bin /.pt cũ hơn sử dụng Python pickle. Việc tải tệp pickle có thể thực thi mã tùy ý, điều này khiến các checkpoint không đáng tin cậy trở thành một rủi ro bảo mật.
Safetensors, được tạo ra tại Hugging Face, loại bỏ rủi ro đó. Một tệp bao gồm phần tiêu đề JSON nhỏ cộng với các bộ đệm tensor thô, không chứa bất kỳ thứ gì có thể thực thi. Các tensor có thể được ánh xạ bộ nhớ (memory-mapped) và tải từng cái một mà không cần đọc toàn bộ tệp. Safetensors hiện được liệt kê là một dự án của PyTorch Foundation.
Lưu ý quan trọng: hầu hết các mô hình GPTQ, AWQ, EXL2, EXL3 và MLX cũng được lưu trữ trong các tệp.safetensors. Việc lượng tử hóa nằm trong nội dung tensor và tệp cấu hình, chứ không phải trong một container mới.
2. GGUF (llama.cpp)
Nó là gì
GGUF là định dạng nhị phân để chạy các mô hình với GGML và các trình thực thi dựa trên GGML như llama.cpp. Nó được tạo ra bởi Georgi Gerganov, người cũng đứng đầu dự án llama.cpp (tài liệu Hugging Face). Nó được giới thiệu vào ngày 21 tháng 8 năm 2023 để thay thế cho định dạng GGML cũ hơn.
Tại sao nó thay thế GGML
Các tệp GGML, GGMF và GGJT cũ hơn không thể xác định mô hình thuộc kiến trúc nào. Việc thêm một siêu tham số (hyperparameter) mới sẽ làm hỏng mọi tệp hiện có. GGUF đã chuyển sang sử dụng siêu dữ liệu (metadata) dạng khóa-giá trị (key-value) có kiểu dữ liệu, vì vậy các trường mới có thể được thêm vào mà không làm hỏng các tệp cũ.
Mục tiêu thiết kế
Đặc tả liệt kê 5 mục tiêu: triển khai một tệp duy nhất, khả năng mở rộng, tương thích mmap, tải dễ dàng và thông tin đầy đủ bên trong tệp. Không giống như các định dạng chỉ chứa tensor, GGUF có thể mang theo tokenizer, các token đặc biệt và mẫu chat Jinja cùng với các trọng số.
Đọc tên các loại lượng tử hóa GGUF
Hậu tố trong một cái tên như Q4_K_M.gguf cho bạn biết lược đồ (scheme) của nó. Các số liệu dưới đây lấy từ tài liệu GGUF của Hugging Face.
*Được suy luận thủ công, không liệt kê trong bảng của HF: 32 trọng số cộng với một thang đo 16-bit (và một giá trị tối thiểu 16-bit cho Q4_1).
Kiểm tra toán học của Q4_K: Một siêu khối (super-block) chứa 256 trọng số. 256 × 4 bit = 1.024 bit. Thêm 8 khối × 12 bit cho các thang đo và giá trị tối thiểu (96 bit). Thêm một siêu thang đo 16-bit và một siêu giá trị tối thiểu 16-bit (32 bit). Tổng cộng: 1.152 ÷ 256 = 4,5 bit mỗi trọng số.
Ý nghĩa của _S, _M, _L: Đây là các hỗn hợp (mixes), không phải các loại mới. Ví dụ, llama.cpp mô tả Q4_K_M sử dụng Q6_K cho một nửa các tensor attention.wv và feed_forward.w2, và Q4_K cho các phần còn lại (tài liệu Unsloth). Đó là lý do tại sao một tệp Q4_K_M có mức trung bình trên 4,5 bit mỗi trọng số.
Các loại mới hơn: Bảng của HF cũng liệt kê TQ1_0 và TQ2_0 cho các trọng số bậc ba (ternary), cộng với MXFP4, một loại dấu phẩy động vi tỷ lệ (microscaling floating-point) 4-bit.
Một điểm kỳ lạ trong cách đặt tên: Hugging Face xếp Q8_0 vào các loại "di sản" (legacy). Trên thực tế, Q8_0 vẫn là lựa chọn GGUF tiêu chuẩn gần như không mất dữ liệu (near-lossless).
Chất lượng so với kích thước
Bảng tham chiếu của Hugging Face cho một mô hình thuộc lớp Llama-2-7B cho thấy sự đánh đổi:
Chỉ mang tính minh họa. Những con số này đến từ một mô hình 7B thời kỳ 2023; các mô hình mới hơn có thể phản ứng khác.
Ma trận tầm quan trọng (imatrix)
Lượng tử hóa GGUF có thể sử dụng dữ liệu hiệu chuẩn. Công cụ llama-imatrix của llama.cpp tính toán ma trận tầm quan trọng từ một tệp văn bản. Sau đó, llama-quantize --imatrix sử dụng nó để cải thiện chất lượng. Đối với các hỗn hợp 1-bit và 2-bit, llama-quantize sẽ cảnh báo nếu không có imatrix được cung cấp.
Quy ước đặt tên
Đặc tả định nghĩa tên tệp bao gồm tên cơ sở, nhãn kích thước, tinh chỉnh (fine-tune), phiên bản, mã hóa, loại và shard. Các shard sử dụng bộ đếm 5 chữ số như 00003-of-00009. Các tiền tố tùy chọn mmproj- và mtp- đánh dấu các bộ chiếu thị giác (vision projectors) và các mô-đun dự đoán đa token (multi-token-prediction).
Nơi GGUF hoạt động
GGUF là định dạng gốc của llama.cpp và hệ sinh thái của nó. Tài liệu của Hugging Face sử dụng nó với llama.cpp, LM Studio, GPT4All và Ollama.
Hỗ trợ vLLM đã tồn tại nhưng còn hạn chế. vLLM gọi đây là tính năng thử nghiệm cao và chưa được tối ưu hóa, và GGUF hiện cần plugin vllm-gguf-plugin bên ngoài.
GPTQ được viết bởi Elias Frantar (IST Austria), Saleh Ashkboos và Torsten Hoefler (ETH Zurich), và Dan Alistarh (IST Austria & Neural Magic). Nó xuất hiện lần đầu trên arXiv vào ngày 31 tháng 10 năm 2022 và được công bố tại ICLR 2023.
Cách thức hoạt động
GPTQ là một phương pháp lượng tử hóa trọng số sau huấn luyện (post-training), thực hiện trong một lần (one-shot). Nó sử dụng thông tin bậc hai xấp xỉ (Hessian) để quyết định cách làm tròn trọng số. Sai số làm tròn ở một cột được bù đắp bằng cách điều chỉnh các trọng số chưa được lượng tử hóa. Nó cần một tập dữ liệu hiệu chuẩn nhỏ nhưng không cần huấn luyện lại.
Kết quả chính
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.