V-Rubrics giải quyết vấn đề 'phân bổ tín dụng' trong mô hình đa phương thức bằng cách chia nhỏ đánh giá thành các tiêu chí chi tiết, giúp mô hình học từ cả những suy luận đúng ngay cả khi kết quả cuối cùng sai.
Vì sao đáng đọc: Nghiên cứu quan trọng được chấp nhận tại EMNLP 2026, giải quyết bài toán hóc búa trong huấn luyện mô hình đa phương thức bằng phương pháp đánh giá phân đoạn sáng tạo.
⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…
DịchNghiên cứu từ Tencent Hunyuan cho thấy việc điều chỉnh learning rate giúp tăng hiệu suất huấn luyện GRPO và PPO, giúp tăng tốc độ xử lý lên 2,29 lần và tiết kiệm 29% thời gian huấn luyện.
⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…
DịchNhóm nghiên cứu Tencent Hunyuan tối ưu hóa học tăng cường cho LLM bằng cách mở rộng kích thước batch, giúp tăng tốc độ xử lý của PPO lên 2,29 lần và rút ngắn 29% thời gian huấn luyện GRPO mà vẫn đảm bảo hiệu suất.
An basic idea in scaling RL: Can we allocate more compute to the harder problems? We did this: If …
DịchNghiên cứu mới giải quyết 'hiệu ứng Matthew' trong học tăng cường (RL) bằng cách buộc mô hình tiếp tục lấy mẫu khi gặp câu trả lời sai, giúp GRPO vượt qua giới hạn ở các bài toán phức tạp.
Hugging Face ra mắt AsyncGRPOTrainer giúp tách biệt quá trình huấn luyện LoRA và suy luận vLLM trên các máy chủ khác nhau mà không cần NCCL, giúp tăng tốc độ huấn luyện lên 3.9 lần.
Vì sao đáng đọc: Đây là giải pháp kỹ thuật thực tiễn cao, giải quyết bài toán khó về hạ tầng khi huấn luyện RLHF, giúp tiết kiệm tài nguyên và tăng hiệu suất đáng kể cho các kỹ sư AI.
GAPO cải tiến phương pháp GRPO bằng cách điều chỉnh ngưỡng cắt tỉa dựa trên lợi thế của từng nhóm, giúp tối ưu hóa tín hiệu học tập từ các mẫu dữ liệu khó và nâng cao hiệu quả huấn luyện mô hình RL.
Hugging Face chia sẻ cách dùng thư viện TRL để tinh chỉnh mô hình LiquidAI trên GPU miễn phí. Chỉ với 500 mẫu và 100 bước huấn luyện, hiệu suất đạt chuẩn IFStruct đã cải thiện đáng kể từ 22.6% lên 29.7%.
Nghiên cứu từ Apple cho thấy phương pháp GRPO duy trì hiệu suất ổn định trong các tác vụ suy luận đa ngôn ngữ, chứng minh RLVR vẫn cực kỳ hiệu quả ngay cả khi không sử dụng tiếng Anh làm ngôn ngữ huấn luyện chính.
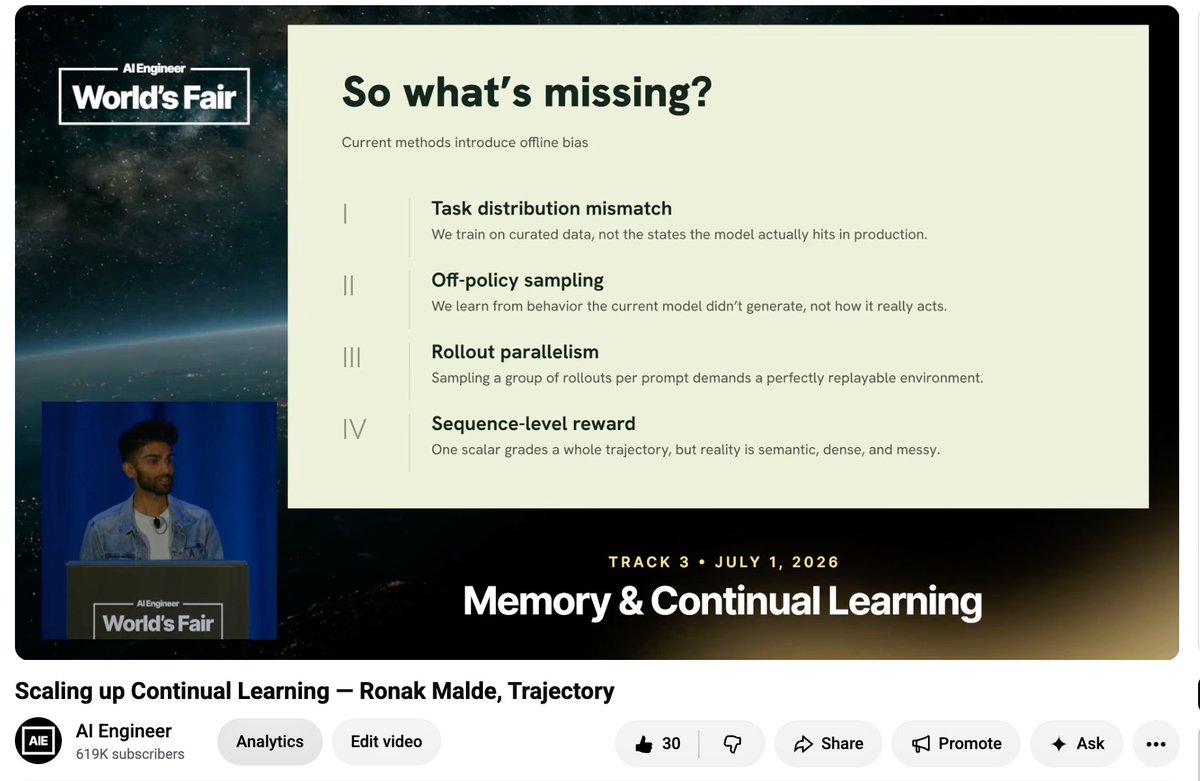
Trajectory have generally impressed me with their tasteful execution on ambitious goals. on our Cont…
DịchChuyên gia swyx khen ngợi Trajectory là đơn vị tiên phong trong học liên tục. Đội ngũ Trajectory đã chia sẻ giải pháp kỹ thuật vượt qua hạn chế của GRPO, chuyển hướng sang on-policy và tối ưu hóa các thuật toán như SDPO.
Hướng dẫn chi tiết cách tối ưu hóa quy trình hậu huấn luyện Tulu 3 trên phần cứng hạn chế (16GB VRAM), thay thế các thành phần phân tán phức tạp bằng công cụ nhẹ để thực hiện SFT, DPO và học tăng cường dựa trên xác thực (GRPO).