We're sharing new research on our post-training approach, which teaches the Perplexity Computer agen…
DịchPerplexity giới thiệu kỹ thuật hậu huấn luyện mới cho AI Agent, kết hợp mô phỏng hành vi tối ưu và tinh chỉnh RFT, giúp giảm 21% tỷ lệ lỗi khi gọi công cụ trong các thử nghiệm thực tế.
Training models is becoming easier and easier - just look at this and TRL - especially with agents! …
DịchHalo là khung hậu huấn luyện mã nguồn mở mới, cho phép tăng tốc độ xử lý gấp 2,8 lần so với TRL truyền thống mà vẫn tiết kiệm bộ nhớ và giữ nguyên định dạng Hugging Face.
White Circle just unveiled Halo, an open-source, distributed post-training framework for models that…
DịchHalo là framework hậu huấn luyện phân tán giúp tối ưu hóa hiệu suất vượt trội so với HuggingFace TRL, đạt tốc độ nhanh gấp 2.8 lần và tiết kiệm 25% bộ nhớ mà vẫn giữ nguyên định dạng mô hình gốc.
Trong bối cảnh giới toán học lo ngại về việc AI 'đánh cắp' ý tưởng trên đám mây, StartLux gây chú ý khi đạt hiệu suất vượt trội với mô hình 27B. Chúng tôi thảo luận về cách họ tối ưu hóa hậu huấn luyện để đạt kết quả ấn tượng dù quy mô tham số nhỏ.
Nghiên cứu giới thiệu khung 'Exploration-Guided Prompt Scaffolding' giúp tối ưu hóa hậu huấn luyện RL cho mô hình đa phương thức (MLLM) thông qua chỉ số EPS, giúp đánh giá tiềm năng khám phá mà không tốn thêm chi phí tính toán.
DịchTailSFT là giải pháp hậu huấn luyện nhẹ nhàng và hiệu quả, giúp cải thiện độ bao phủ và nâng cao hiệu suất RL cho các mô hình ngôn ngữ như Olmo 3 mà không tốn kém chi phí như các phương pháp truyền thống.
Google giới thiệu autofinetune, sử dụng AI Agent kết hợp Gemini Flash 3.7 để tự động hóa quy trình SFT và GRPO cho LLM trên hạ tầng TPU, giúp tối ưu hóa việc huấn luyện mô hình.
Miles v0.1 là hệ thống hậu huấn luyện toàn diện, tối ưu cho môi trường sản xuất, giúp chuẩn hóa quy trình huấn luyện RL với thiết kế linh hoạt, dễ tùy chỉnh và kiểm chứng.
RISE là phương pháp mới giúp mô hình tự tạo ra 'giáo viên' từ quá trình huấn luyện RLVR của chính nó. Bằng cách ngoại suy các thay đổi tham số, phương pháp này chuyển đổi các phản hồi thưa thớt thành mục tiêu học tập dày đặc ở cấp độ token mà không cần mô hình bên ngoài.
Vì sao đáng đọc: Đây là một bước tiến kỹ thuật quan trọng trong việc tối ưu hóa hậu huấn luyện (post-training) cho LLM, giải quyết hiệu quả bài toán phụ thuộc vào mô hình giáo viên bên ngoài.
02/09
Thứ Tư · 1 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Bài báo đề xuất phương pháp hậu huấn luyện dựa trên lưu lượng truy cập thực tế, giúp tối ưu hóa hiệu suất LLM tự lưu trữ trên các tác vụ phức tạp như gọi hàm và tuân thủ chỉ dẫn, đảm bảo bảo mật dữ liệu doanh nghiệp.
Nghiên cứu chỉ ra rằng chiến lược tiến hóa (ES) giúp tối ưu hóa suy luận LLM hiệu quả hơn GRPO, tránh được hiện tượng suy giảm entropy và cải thiện đáng kể tỷ lệ thành công (Pass@K) nhờ các cập nhật trọng số chọn lọc.
OPDVR là phương pháp mới kết hợp học tăng cường dựa trên phần thưởng kiểm chứng (RLVR) với chưng cất chính sách trực tuyến (OPD) mà không cần thêm siêu tham số, giúp tối ưu hóa mô hình hiệu quả hơn.
Today's edition of my newsletter just went out. 🔗 https://www.rohan-paul.com/p/study-finds-1-in-3-...
DịchGiáo sư Tang Jie nhận định việc chạy đua mô hình nghìn tỷ tham số là hướng đi lệch lạc, thay vào đó, tối ưu hóa giai đoạn hậu huấn luyện (post-training) mới là yếu tố quyết định sự đột phá của AI.
Brilliant piece by Zhipu Founder Tang Jie. AI scaling is moving past parameter growth. "How many …
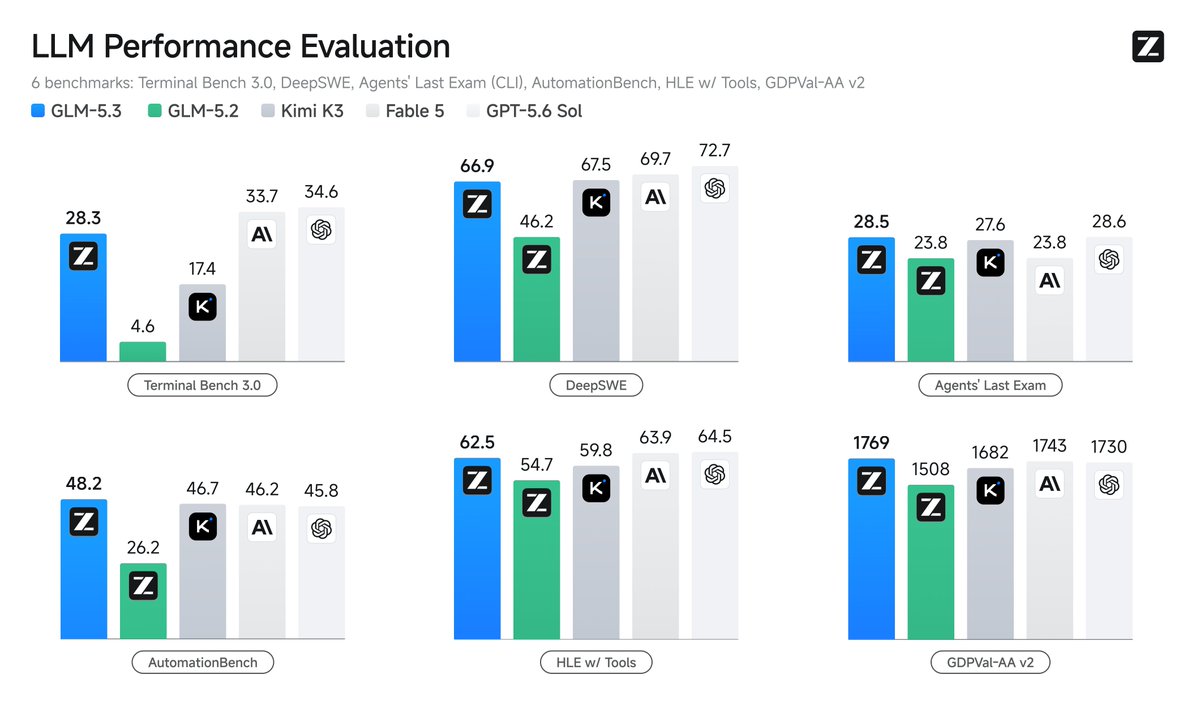
DịchĐường cong tăng trưởng mô hình không còn phụ thuộc vào tham số, mà nằm ở dữ liệu, tính toán và hậu huấn luyện. Zhipu chứng minh GLM-5.3 dù cùng cấu trúc với bản cũ nhưng nhờ tối ưu hóa suy luận và RL, hiệu suất đã vượt trội đáng kể.
Giữa làn sóng chạy đua thông số benchmark khô khan, chuyên gia Ma Dong-seok bắt đầu chuỗi bài phân tích hệ thống về kỹ thuật hậu huấn luyện, hứa hẹn mang đến góc nhìn chuyên sâu hơn về sự tiến hóa của các mô hình AI.
CEO của Z.ai chia sẻ về sự thay đổi trong cách đánh giá sức mạnh mô hình AI, nơi quy luật mở rộng hậu huấn luyện dần thay thế tầm quan trọng của số lượng tham số truyền thống.
I wish every neolab had a professor as cofounder of the level of @jietang and so able to put in pers…
DịchTang Jie từ Zhipu AI khẳng định chi phí suy luận đang dần chiếm ưu thế trong vòng đời mô hình. Thử nghiệm trên GLM-5.3 cho thấy việc tối ưu hóa hậu huấn luyện bằng RL có thể nâng cao năng lực đáng kể mà không cần thay đổi kiến trúc hay tham số.
Tang Jie phản biện Scaling Law, khẳng định hiệu năng không chỉ phụ thuộc vào số lượng tham số mà còn ở dữ liệu và tối ưu hóa hậu huấn luyện. Thử nghiệm trên GLM-5.3 cho thấy chỉ cần tinh chỉnh RL trong một tháng đã mang lại bước tiến lớn mà không cần thay đổi kiến trúc.
Thoughts About Scaling Law Scaling, but not only of parameters. Every model release now ends with t…
DịchTang Jie khẳng định Scaling Law không chỉ nằm ở quy mô tham số mà còn ở dữ liệu và tính toán. Thử nghiệm GLM-5.3 cho thấy việc tối ưu hóa hậu huấn luyện (RL) giúp cải thiện hiệu suất vượt trội mà không cần thay đổi kiến trúc hay tăng tham số.
GLM-5.3 from @Zai_org is live on OpenRouter! The same base model as GLM-5.2, with gains entirely fr…
DịchGLM-5.3 đã có mặt trên OpenRouter. Dù dùng chung nền tảng với bản 5.2, mô hình này đạt bước tiến lớn về khả năng lập trình và giải quyết vấn đề nhờ quy trình hậu huấn luyện chuyên sâu.
StreamOPD giới thiệu phương pháp hậu huấn luyện không cần bộ nhớ suy luận, giúp cải thiện đáng kể hiệu suất hiểu video trên các bộ dữ liệu chuẩn, tiệm cận kết quả của các mô hình lớn hơn.
Congrats to @Zai_org on GLM-5.3. It massively beats every American open model: Nemotron, Laguna, Ink…
DịchGLM-5.3 vừa ra mắt đã cho thấy hiệu suất vượt trội so với các đối thủ từ Mỹ như Nemotron. Điểm đáng chú ý là sự cải tiến này hoàn toàn đến từ quy trình hậu huấn luyện (post-training) trên cùng một nền tảng với phiên bản cũ.
Something has happened with post-training as shown by DeepSeek flash & GLM-5.3 updates. Same ba…
DịchZhipu ra mắt GLM-5.3 với khả năng lập trình và tác tử vượt trội. Các chuyên gia nhận định mô hình này chứng minh sức mạnh của kỹ thuật hậu huấn luyện trong việc đưa hiệu suất lên tầm cao mới, vượt xa các phương pháp chưng cất truyền thống.
Z.ai vừa trình làng GLM-5.3, phiên bản nâng cấp dựa trên nền tảng 743B cũ thông qua kỹ thuật hậu huấn luyện chuyên sâu. Mô hình đạt hiệu suất ấn tượng trong lập trình và các tác vụ phức tạp, vượt qua nhiều đối thủ sừng sỏ như Mythos 5 và GPT-5.6 Sol.
I made a short video covering the history of Shoggoths, as used as a post-training meme and also dee…
DịchNathan Lambert chia sẻ về nguồn gốc của 'Shoggoth' - một meme kinh điển trong cộng đồng hậu huấn luyện AI, đồng thời là ẩn dụ đầy ám ảnh về bản chất của các mô hình ngôn ngữ hiện đại.
 Aravind Srinivas (Perplexity CEO)@AravSrinivas