Tin ngành
Linkup Research ra mắt SPARSEUP: Mô hình nhúng thưa 149M tham số hiệu năng cao
(giờ Việt Nam)
Tóm tắt AI
Linkup Research vừa phát hành mã nguồn mở SPARSEUP, mô hình nhúng dựa trên ModernBERT với 149M tham số. Đây hiện là mô hình mã hóa thưa mạnh nhất trong phân khúc dưới 150M tham số, đạt điểm nDCG@10 là 56.4 trên benchmark BEIR-13.
Bản dịch AI
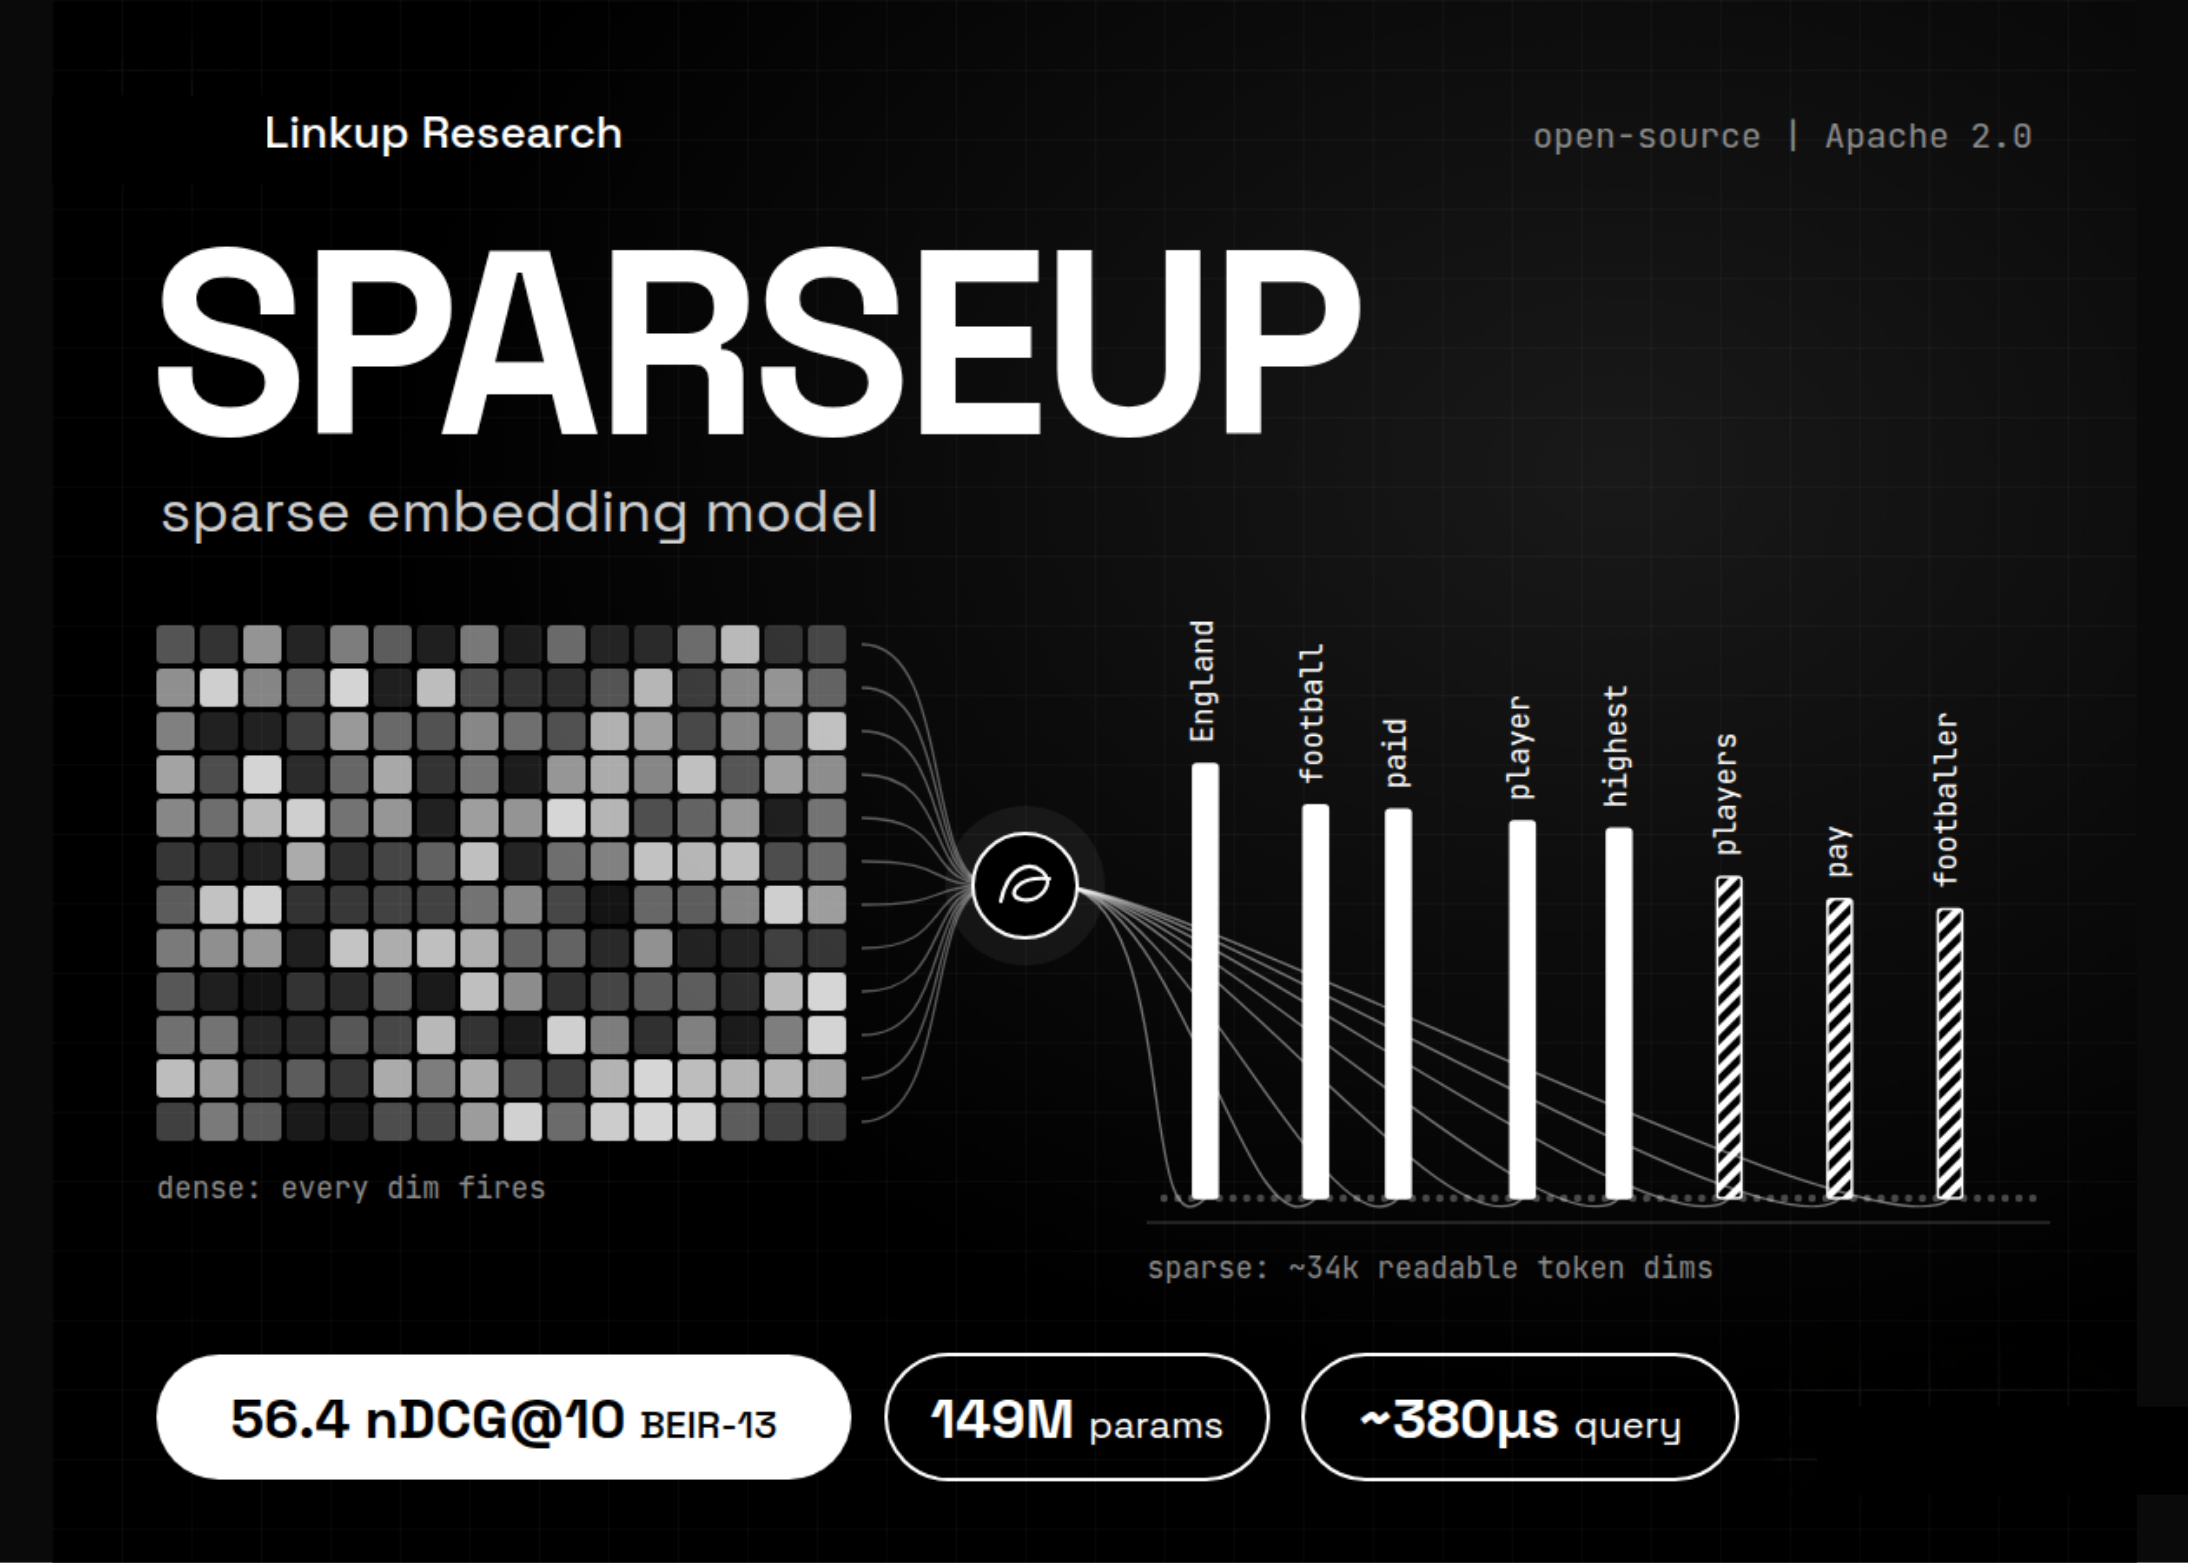
Nhóm nghiên cứu Linkup vừa phát hành SPARSEUP, một mô hình nhúng thưa (sparse embedding) mã nguồn mở đã qua học máy. Mô hình này chạy trên nền tảng ModernBERT với 149 triệu tham số và được phát hành theo giấy phép Apache 2.0. Nhóm Linkup báo cáo đạt điểm trung bình 56.4 nDCG@10 trên tập dữ liệu BEIR-13. Họ khẳng định đây là bộ mã hóa thưa dựa trên từ vựng công khai mạnh mẽ nhất mà họ biết với quy mô dưới 150 triệu tham số.
Mô hình có thể triển khai được không? Có. Các trọng số hiện có trên Hugging Face theo giấy phép Apache 2.0. Mô hình có thể được tải thông qua Transformers hoặc Sentence Transformers với tham số trust_remote_code=True.
Tại sao lại là mô hình thưa (Sparse Model) và tại sao lại là bây giờ?
Hầu hết các mô hình truy xuất mã nguồn mở hiện nay đều là mô hình dày (dense): 1 vector cho mỗi văn bản. Ngược lại, các mô hình thưa xuất ra các trọng số trên một bộ từ vựng. Mỗi chiều ánh xạ tới một token thực tế, vì vậy các vector này phù hợp với chỉ mục đảo ngược (inverted indexes) và con người có thể đọc được. Chúng cũng có xu hướng khớp tốt với các từ hiếm.
Động lực thúc đẩy là sự ra mắt của DenseOn và LateOn từ LightOn. LightOn đã công bố dữ liệu mở, công thức huấn luyện, một mô hình dày và một mô hình tương tác trễ (late-interaction). SPARSEUP lấp đầy khoảng trống cho mô hình thưa. Nó sử dụng cùng dòng nền tảng và dữ liệu tinh chỉnh, vì vậy cả 3 kiểu truy xuất có thể được so sánh trực tiếp với nhau.
SPARSEUP được xây dựng như thế nào?
Quá trình huấn luyện bắt đầu từ LateOn-unsupervised. Điểm kiểm tra (checkpoint) đó không có lớp MLM, vì vậy nhóm đã ghép lại lớp gốc của ModernBERT. Việc tinh chỉnh sử dụng hỗn hợp tinh chỉnh của LightOn chỉ với học tương phản (contrastive learning). Mỗi truy vấn nhận được 7 mẫu phủ định khó (hard negatives) được lấy từ một nhóm 50 mẫu, cùng với các mẫu phủ định trong cùng một batch. Không có quá trình chưng cất cross-encoder và việc huấn luyện có thể thực hiện trên một GPU H100 duy nhất.
Một mô hình SPLADE thông thường trên nền tảng này tạo ra rất nhiều từ dừng (stopwords). Linkup đã khắc phục điều này bằng 3 thay đổi:
Các truy vấn và tài liệu được thêm tiền tố [Q] và [D], và việc tính điểm là tích vô hướng (dot product). Độ dài tối đa khi đánh giá là 128 token cho truy vấn và 512 cho tài liệu.
Kết quả đánh giá (Benchmark)
So với các bộ mã hóa thưa khác trên BEIR-13 (nDCG@10, không bao gồm MS MARCO), theo thẻ mô hình (model card):
Sự so sánh có kiểm soát cho thấy kết quả ít ấn tượng hơn. Với nền tảng và dữ liệu cố định, LateOn đạt 58.9 điểm, DenseOn đạt 57.9 và SPARSEUP đạt 56.4. SPARSEUP sử dụng tìm kiếm Seismic xấp xỉ, trong khi LightOn báo cáo tìm kiếm chính xác. SPARSEUP thắng ở ArguAna và Touché, đồng thời vượt qua DenseOn ở HotpotQA. Nó tụt hậu ở các tập dữ liệu mang tính ngữ nghĩa hơn, với FiQA cho thấy khoảng cách lớn nhất. DBPedia cũng là một điểm yếu khác.
Trên tập BEIR đã khử nhiễm (decontaminated), khoảng cách với DenseOn thu hẹp xuống còn 0.17 điểm. Linkup cảnh báo rằng các tập NQ và MS MARCO đã khử nhiễm chỉ có lần lượt 21 và 46 truy vấn, vì vậy các kết quả đó có độ nhiễu cao.
Tốc độ và độ thưa
Trên MS MARCO, SPARSEUP đạt trung bình 47 thuật ngữ khác không (non-zero) cho mỗi truy vấn và 190 cho mỗi tài liệu. SPLADE-v3 đạt trung bình lần lượt là 25 và 170. Với chỉ mục đảo ngược Seismic, nó đạt độ thu hồi (recall) hơn 97% so với tìm kiếm chính xác trong khoảng 380 micro giây mỗi truy vấn, chạy đơn luồng. Linkup cho biết việc tăng kích thước vector có thể thêm 1 đến 2 điểm BEIR, nhưng họ chọn giữ nguyên độ thưa.
Những điểm chính cần lưu ý
Hãy xem Trọng số mô hình và Chi tiết kỹ thuật. Mọi công lao thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit ML 150k+ của chúng tôi và Đăng ký Bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá GitHub Repo, Trang Hugging Face, Phát hành sản phẩm hoặc Hội thảo trực tuyến của bạn, v.v.? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về tin tức học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào với hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với độc giả.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.