Tin ngành
Google Cloud tích hợp sẵn thuật toán tìm kiếm BM25 cho AlloyDB và Cloud SQL
(giờ Việt Nam)
Tóm tắt AI
Google Cloud bổ sung hỗ trợ BM25 trực tiếp trên AlloyDB và Cloud SQL, cho phép thực hiện tìm kiếm toàn văn bản kết hợp với tìm kiếm vector mà không cần hạ tầng phụ trợ, giúp tối ưu hiệu suất truy vấn lên đến 10 lần.
Bản dịch AI

Vector search (tìm kiếm vector) là một thành phần quan trọng trong các kiến trúc generative AI, retrieval-augmented generation (RAG) và data agent, nhưng đôi khi chỉ riêng vector search là chưa đủ. Mặc dù các vector embedding rất xuất sắc trong việc hiểu ý nghĩa khái niệm, chúng lại gặp khó khăn với các ID chữ-số cụ thể và mã SKU sản phẩm chính xác. Để xây dựng các ứng dụng AI và tìm kiếm thực sự mạnh mẽ, bạn có thể cần sự kết hợp giữa tìm kiếm vector ngữ nghĩa và tìm kiếm toàn văn bản (full-text search) theo từ khóa chính xác truyền thống — điều mà chúng tôi gọi là hybrid search (tìm kiếm kết hợp).
Trong tìm kiếm, Best Matching 25, hay BM25, là thuật toán then chốt được sử dụng để ước tính mức độ liên quan của một tài liệu đối với một truy vấn nhất định. Cho đến nay, nếu muốn sử dụng xếp hạng BM25 với AlloyDB hoặc Cloud SQL, bạn cần phải thêm một backend tìm kiếm toàn văn bản bổ sung. Điều này dẫn đến tình trạng phân mảnh dữ liệu (data silos), độ trễ đồng bộ và sự phức tạp trong vận hành. Hôm nay, chúng tôi loại bỏ hoàn toàn sự bất tiện khi phải duy trì một backend tìm kiếm toàn văn bản riêng biệt, với bản xem trước của chỉ mục BM25 gốc trong AlloyDB và Cloud SQL cho PostgreSQL 17+, được hiện thực hóa thông qua tiện ích mở rộng mã nguồn mở pg_textsearch do TigerData tạo ra.
Giờ đây, với một backend hybrid search thống nhất, bạn không còn cần phải cấp phát, quản lý hoặc trả phí cho các hệ thống riêng biệt để có được khả năng truy xuất toàn văn bản hiện đại. Mọi thứ diễn ra trực tiếp bên trong cơ sở dữ liệu nơi lưu trữ dữ liệu vận hành của bạn, mang lại:
Xếp hạng từ khóa theo tiêu chuẩn ngành: Được hỗ trợ bởi pg_textsearch của TigerData, mang khả năng tính điểm BM25 cực nhanh, được tối ưu hóa bằng C trực tiếp vào các bảng Postgres của bạn.
Không phức tạp, nhất quán tuyệt đối: Loại bỏ tình trạng trùng lặp dữ liệu, các đường ống ETL và độ trễ đồng bộ hóa vốn xảy ra khi bạn duy trì nhiều backend cho việc truy xuất vector và toàn văn bản.
Tìm kiếm ngữ nghĩa siêu tốc (Độc quyền trên AlloyDB): Đạt tốc độ truy vấn vector search nhanh hơn gấp 6 đến 10 lần (so với PostgreSQL tiêu chuẩn) nhờ các loại chỉ mục ScaNN và HNSW.
Tại sao lại là pg_textsearch?
Nếu bạn đã từng sử dụng ts_rank tích hợp sẵn của PostgreSQL cho tìm kiếm toàn văn bản ở quy mô đáng kể, bạn hẳn đã biết những hạn chế của nó. Chất lượng xếp hạng suy giảm khi kho dữ liệu của bạn lớn dần. Không có hỗ trợ cho tần suất tài liệu nghịch đảo (inverse document frequency), vì vậy các từ phổ biến có trọng số giống như các từ hiếm. Không có sự bão hòa tần suất thuật ngữ (term-frequency saturation), do đó một tài liệu đề cập đến "database" 50 lần sẽ xếp hạng cao hơn tài liệu chỉ đề cập một lần.
BM25 là tiêu chuẩn vàng trong truy xuất thông tin, cung cấp tần suất tài liệu nghịch đảo (các thuật ngữ hiếm quan trọng hơn), sự bão hòa tần suất thuật ngữ (việc lặp lại không chiếm ưu thế) và chuẩn hóa độ dài tài liệu. Bạn có thể tìm hiểu thêm trong bài đăng trên blog này của TigerData về cách họ xây dựng công cụ tìm kiếm BM25 trên các trang PostgreSQL.
Ví dụ về tìm kiếm toàn văn bản
Dưới đây là cách bắt đầu với tìm kiếm toàn văn bản BM25 trên cả AlloyDB và Cloud SQL. Hãy xem xét một bảng mẫu, cymbal_products, chứa định dạng định danh duy nhất uniq_id, cột product_name, cột product_description chứa mô tả văn bản của từng sản phẩm và cột product_embedding được tạo tự động. cymbal_products chứa thông tin về nhiều loại sản phẩm bán lẻ, bao gồm cả cây trồng trong nhà và ngoài trời.
Tạo chỉ mục
Để sử dụng BM25, hãy kích hoạt tiện ích mở rộng pg_textsearch.
Tạo chỉ mục trên cột product_description từ bảng cymbal_products.
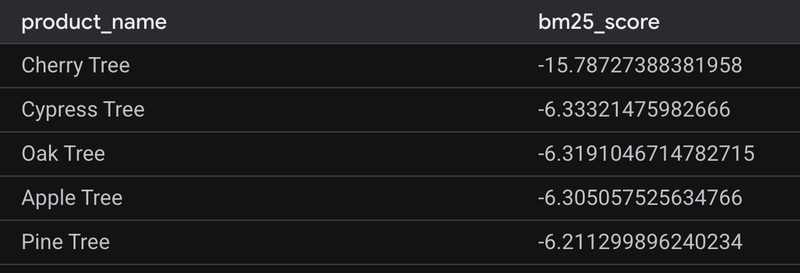
Một truy vấn tìm kiếm toàn văn bản BM25 có thể được thực hiện bằng cách sử dụng toán tử đặc biệt <@>. Trong đoạn mã dưới đây, chúng ta tìm kiếm ‘cherry tree’.
Kết quả mẫu được hiển thị bên dưới. Điểm số càng âm (càng nhỏ) cho thấy mức độ liên quan càng mạnh.
Ví dụ về hybrid search trên AlloyDB
Việc thiết lập hệ thống hybrid search trong AlloyDB rất đơn giản. Bạn có thể tạo cả chỉ mục vector và chỉ mục từ khóa trên cùng một bảng và hợp nhất kết quả một cách liền mạch bằng cách sử dụng hàm do người dùng định nghĩa (UDF) cho hybrid search.
Tạo chỉ mục vector
Đây là cách tạo chỉ mục tìm kiếm vector ScaNN:
Hybrid search
AlloyDB cung cấp sẵn UDF hybrid search giúp việc chạy các truy vấn hybrid search trở nên rất đơn giản. UDF này hợp nhất các kết quả đã xếp hạng từ mỗi thành phần tìm kiếm thành một danh sách thống nhất duy nhất bằng cách sử dụng thuật toán Reciprocal Rank Fusion (RRF). Truy vấn này sử dụng UDF để thực hiện tìm kiếm vector cho ‘trees that grow taller than houses’ (những cái cây cao hơn nhà) và tìm kiếm từ khóa cho ‘California’ trong mô tả sản phẩm.
Như hiển thị trong kết quả mẫu bên dưới, các kết quả được xếp hạng theo thứ tự giảm dần của điểm RRF.
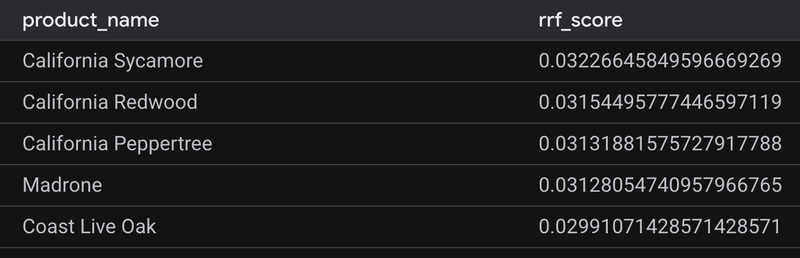
Ở đây, hybrid search thu hẹp khoảng cách giữa trực giác ngữ nghĩa và khớp từ khóa chính xác. Trong khi các vector embedding vượt trội trong việc nắm bắt các truy vấn khái niệm, như "trees that grow taller than houses", thì tìm kiếm toàn văn bản truyền thống cung cấp độ chính xác tuyệt đối cần thiết cho các định danh nghiêm ngặt như "California". Bằng cách kết hợp cả hai, AlloyDB giúp đảm bảo ứng dụng của bạn ưu tiên các kết quả cụ thể, phù hợp tại địa phương như ‘California Sycamore’ ngay ở đầu danh sách.
Ví dụ về hybrid search trên Cloud SQL
Trong Cloud SQL, bạn có thể tạo cả chỉ mục vector và từ khóa trên cùng một bảng và hợp nhất kết quả một cách liền mạch bằng cách sử dụng Common Table Expressions (CTEs) và gộp điểm RRF, như hiển thị bên dưới.
Tạo chỉ mục vector
Đây là cách tạo chỉ mục HNSW trong Cloud SQL.
Hybrid search
Đây là truy vấn hybrid search.
Kết quả đầu ra giống hệt với kết quả hybrid search trên AlloyDB hiển thị ở trên.
Xem thực tế
Xem cách tất cả những điều này kết hợp với nhau trong video demo này.
Bài viết được AI dịch và tổng hợp tự động từ Google Cloud: Databases. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.