Sản phẩm
LiteParse cập nhật tháng 9: Tăng tốc PDFium 25%, bổ sung định vị thị giác và API định tuyến
(giờ Việt Nam)
Tóm tắt AI
LlamaIndex ra mắt LiteParse 2.14.6 với tối ưu hóa bộ nhớ, giúp giảm thời gian trích xuất văn bản xuống còn 2,76ms/trang, đồng thời bổ sung tính năng định vị thị giác và API is-complex.
Bản dịch AI
Kể từ khi ra mắt LiteParse vào đầu năm nay, chúng tôi đã chứng kiến sự tăng trưởng đầy ấn tượng. Hơn 300 nghìn lượt tải gói hàng tuần, hơn 12 nghìn lượt sao (stars) trên GitHub và hơn 1000 lượt commit từ hơn 30 cộng tác viên. Thông báo tính năng lớn gần đây nhất là việc bổ sung đầu ra markdown dựa trên heuristic, nhưng chúng tôi vẫn tiếp tục phát triển thêm các tính năng đó để giúp LiteParse nhanh hơn, chính xác hơn và giàu tính năng hơn, bao gồm:
Tối ưu hóa PDFium
Khi xem xét độ trễ tổng thể của LiteParse, nút thắt lớn nhất nằm ở các lệnh gọi PDFium để trích xuất văn bản. Nếu bạn chưa biết, PDFium là một thư viện do Google duy trì để làm việc với các tệp PDF. Chúng tôi có một bản fork riêng mà chúng tôi tự duy trì, nhờ đó có khả năng phân tích sâu nút thắt này và thực hiện các cải tiến.
Chúng tôi đã thực sự sửa khá nhiều vấn đề để đạt được điều này, cho cả các tài liệu thông thường lẫn các trường hợp đặc biệt (long-tail issues):
Bản sửa lỗi thú vị nhất cho đến nay hoàn toàn xoay quanh việc cấp phát bộ nhớ. Quá trình phân tích cho thấy hai hàm của PDFium (FPDF_LoadPage và FPDFText_LoadPage) chiếm hơn một nửa thời gian chạy. Trong thời gian này, chúng tôi quan sát thấy vô số các thao tác cấp phát và dọn dẹp bộ nhớ nhỏ lẻ. Vì vậy, để tối ưu hóa, chúng tôi đã tích hợp trực tiếp mimalloc vào bản fork. Để giảm thiểu rủi ro, thay đổi này chỉ thay thế các kênh cấp phát của riêng PDFium, nghĩa là libc malloc vẫn không bị ảnh hưởng, do đó tiến trình Node hoặc Python của bạn vẫn tiếp tục sử dụng bộ cấp phát riêng của nó.
Kết quả cuối cùng là hiệu suất trích xuất văn bản được cải thiện 20-25% (tùy thuộc vào tài liệu). Khi đo lường quá trình trích xuất văn bản (ví dụ: lit parse doc.pdf --no-ocr) trên một tập hợp các tệp PDF thực tế, chúng ta có thể thấy tốc độ cải thiện như sau:
Trong cùng khoảng thời gian kể từ phiên bản 2.1, các cải tiến về độ chính xác của markdown đã làm tăng thêm một chút độ trễ, và những thay đổi ở PDFium giúp chúng tôi bù đắp lại khoảng thời gian đó. Dưới đây là so sánh đầy đủ hơn về đầu ra markdown so với các công cụ khác trên cùng các tài liệu:
Độ chính xác của Markdown Heuristics
Markdown trong LiteParse đã có nhiều cải tiến về cả độ chính xác lẫn độ trễ. Về độ trễ, chúng tôi đã hợp nhất các bản sửa lỗi cho việc trích xuất khung bao (bounding box) và phát hiện chồng lấn đối với các tài liệu dày đặc, giới hạn kích thước ảnh chụp màn hình trang để tránh tràn bộ nhớ, và nhiều cải tiến khác (giúp bù đắp một phần độ trễ tăng thêm do các heuristic trang được cải thiện).
Về độ chính xác, chúng tôi đã thực hiện rất nhiều công việc để nâng cao chất lượng đầu ra markdown. Chẳng hạn như bao gồm tốt hơn các đường kẻ (rule-lines), phát hiện cột chính xác hơn, xử lý tiêu đề nhiều dòng, và xử lý văn bản từ phải sang trái so với từ trái sang phải trong các tài liệu đa ngôn ngữ.
Công việc này được thể hiện rõ nhất qua các chỉ số độ chính xác cập nhật của chúng tôi, bạn có thể xem trong các bảng dưới đây. Tất cả kết quả được báo cáo khi đã tắt OCR (mặc dù bật OCR sẽ mang lại những cải thiện nhỏ, đặc biệt là khi sử dụng PaddleOCR).
opendataloader-bench — 200 tài liệu. NID = thứ tự đọc, TEDS = cấu trúc bảng, MHS = phân cấp tiêu đề.
olmOCR-bench — 1.403 trang, % số lần kiểm tra quy tắc đạt yêu cầu.
old_scans là 13.3 và cả hai danh mục toán học đều là 0.0 đối với mọi công cụ không dùng mô hình (model-free), vì vậy chúng bị lược bỏ bên dưới.
ParseBench — 2.049 tài liệu.
Cột Biểu đồ (Charts) là 0.00–0.02 cho mọi công cụ ở đây (không công cụ nào tái tạo dữ liệu biểu đồ), vì vậy nó bị lược bỏ. ParseBench đã thay đổi hệ thống chấm điểm kể từ bài đăng trước của chúng tôi, vì vậy chúng tôi đã chạy lại phiên bản 2.1 thông qua bộ công cụ hiện tại thay vì trích dẫn con số cũ so với một thước đo khác.
Visual Grounding (Định vị trực quan)
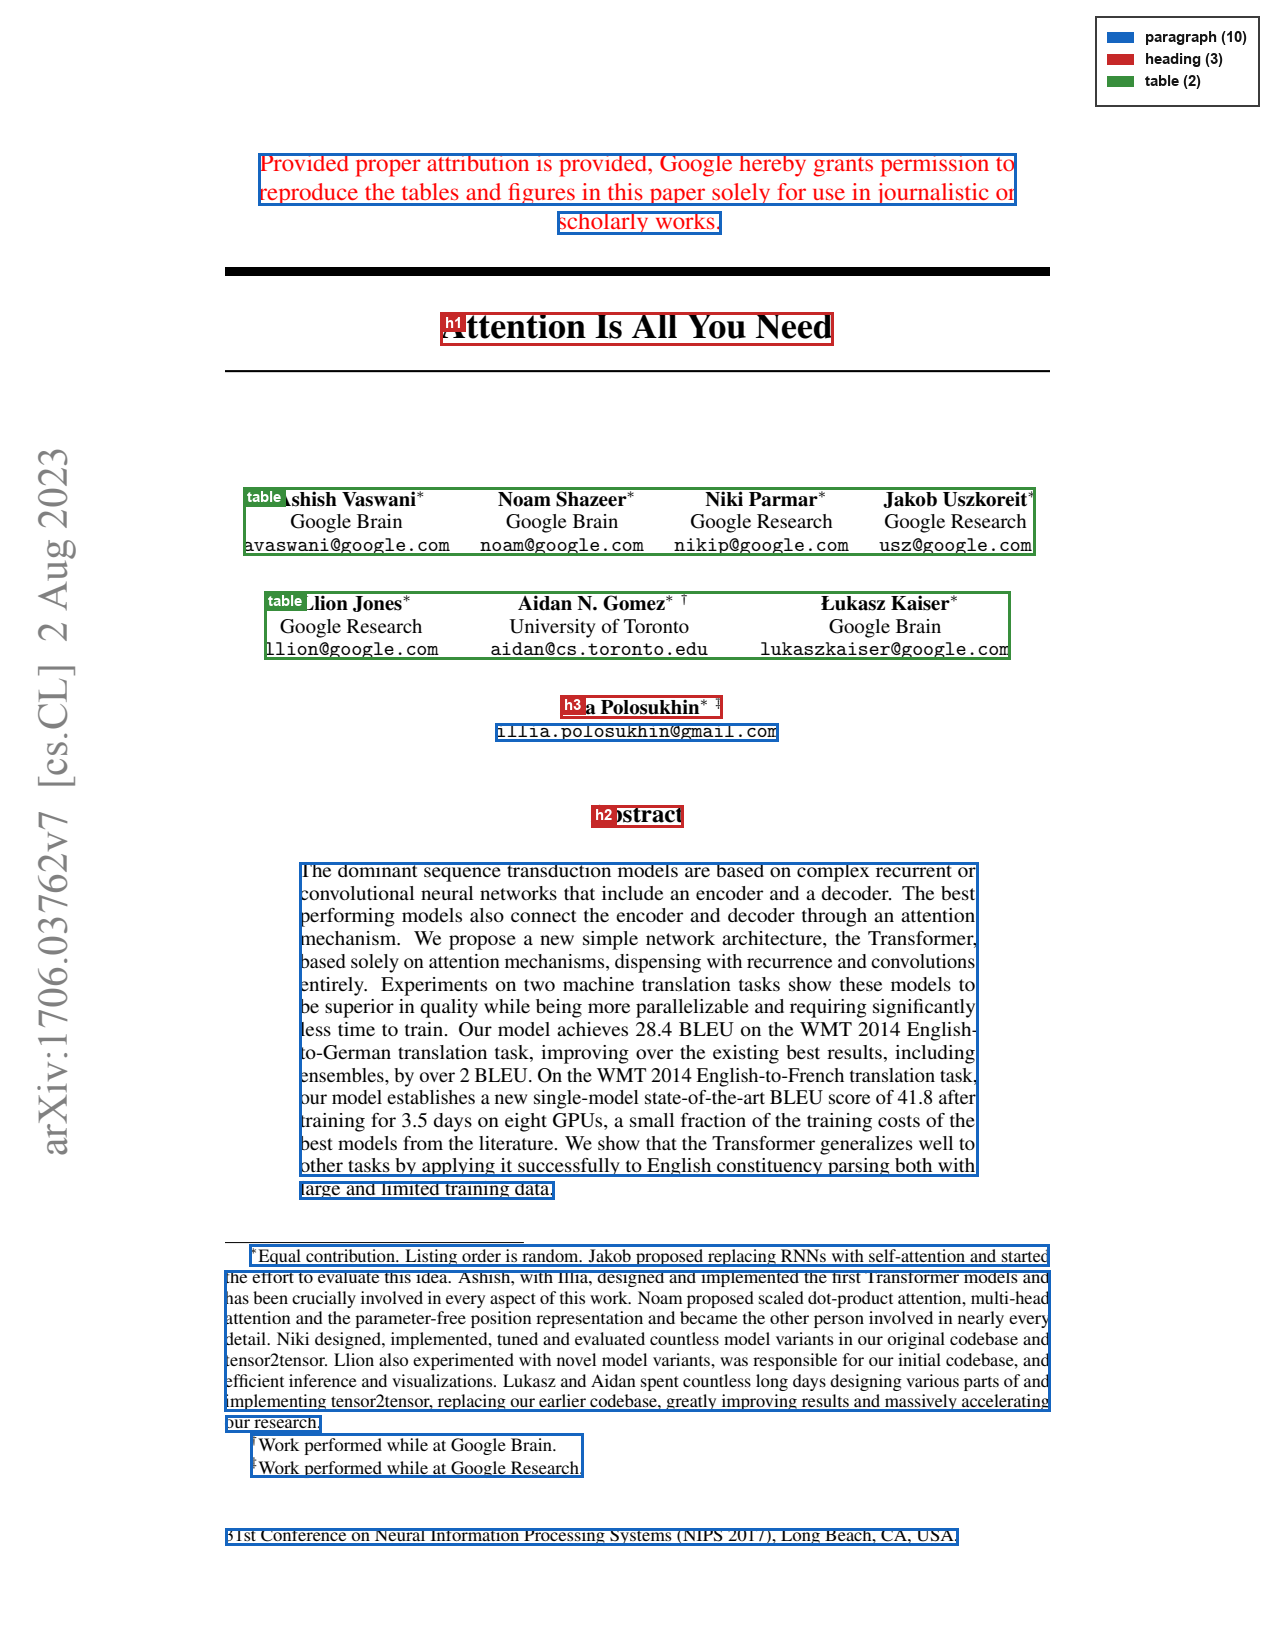
Một yêu cầu lớn khác (chúng tôi từng có nhiều issue trên GitHub mở cho cùng một vấn đề) là khả năng truy cập tốt hơn vào các đối tượng khối markdown thực tế. Thay vì chỉ xuất văn bản markdown thuần túy, giờ đây chúng tôi có tùy chọn xuất cấu trúc khối thực tế (các đối tượng tồn tại trước khi chuyển đổi thành chuỗi markdown). Kết hợp với khung bao (bounding boxes), người dùng hiện có thể quy chiếu đầu ra markdown cho các phần tử cụ thể trên trang tài liệu gốc.
Độ phức tạp của tài liệu
Mặc dù LiteParse rất tốt, nhưng nó không bao giờ có thể đánh bại các quy trình phân tích nâng cao hơn cho các tài liệu phức tạp (như LlamaParse). Nếu không có (các) mô hình lớn hơn, thông minh hơn trong quy trình, LiteParse sẽ có giới hạn về các loại tài liệu mà nó có thể xử lý. Vậy nếu LiteParse có thể cho bạn biết điều này trước thì sao?
Lệnh và API is-complex thực hiện chính xác điều này: báo cáo xem một trang có phải là bản quét hay không, liệu phông chữ và văn bản có bị lỗi hiển thị hay không, độ bao phủ văn bản, và cũng sử dụng các heuristic markdown của chúng tôi để phát hiện các phần tử bố cục như bảng và văn bản nhiều cột.
Sử dụng API này, bạn có thể có một bộ định tuyến quyết định rất nhanh (~3.5ms/trang) để điều hướng đến quy trình xử lý phù hợp.
API này có rất nhiều chi tiết, tài liệu của chúng tôi là nơi tốt nhất để tìm hiểu thêm: https://developers.llamaindex.ai/liteparse/guides/complexity/
Tích hợp LiteParse ngay hôm nay!
LiteParse được cấp phép theo Apache-2.0 và chạy như một công cụ duy nhất trên bốn hệ sinh thái, bao gồm cả chạy trực tiếp trên trình duyệt:
Hoặc sử dụng nó trực tiếp với tác nhân lập trình (coding agent) của bạn như một kỹ năng:
Bài viết được AI dịch và tổng hợp tự động từ LlamaIndex: Sản phẩm、. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.