Raven V0.2.0 giới thiệu khung Harness cho phép AI tự tối ưu hóa các module, code và prompt, giúp các Agent như Claude Code và Codex phối hợp hiệu quả hơn thông qua cơ chế tự cải thiện đệ quy.
Vì sao đáng đọc: Bài viết mang tính chuyên môn cao, giới thiệu cách tiếp cận mới về RSI cho Agent, rất hữu ích cho cộng đồng phát triển AI và kỹ thuật hệ thống.
RRSI Regularized Recursive Self-Improvement of Agent Harnesses paper: https://huggingface.co/paper...
DịchRRSI là khung tác tử AI mới sử dụng phương pháp chính quy hóa để tối ưu hóa quá trình tự cải thiện đệ quy, giúp nâng cao hiệu suất và độ ổn định của hệ thống.
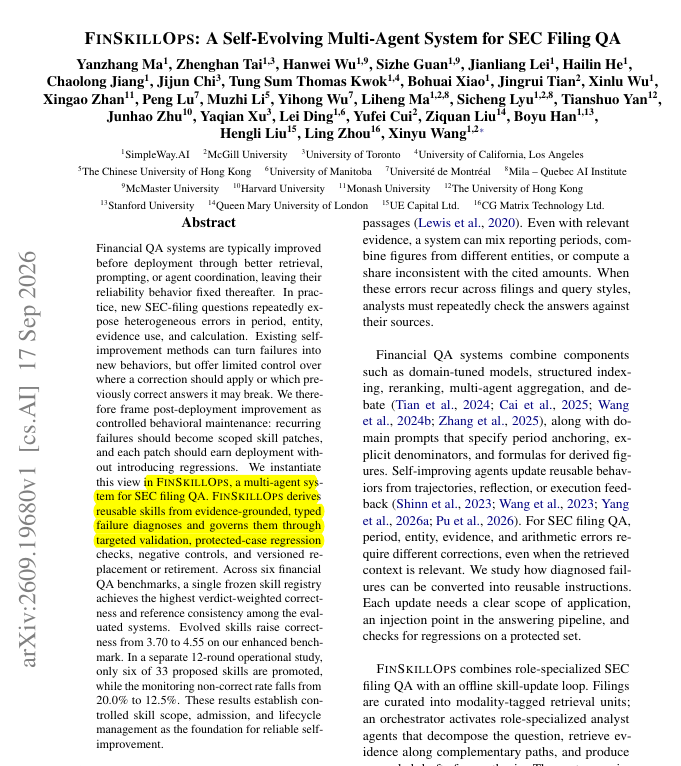
New Harvard + MIT + other labs paper shows a cleaner path to self-improving financial AI: let the …
DịchCác nhà nghiên cứu giới thiệu FINSKILLOPS, hệ thống cho phép AI học hỏi từ lỗi sai trong phân tích tài chính thông qua cơ chế kiểm thử hồi quy nghiêm ngặt, giúp chuyển đổi RAG tĩnh thành hệ thống tự học bền vững.
ModularRSI giải quyết các hạn chế của việc tự cải thiện đệ quy (RSI) bằng cách tách biệt các mô-đun, giúp tác nhân AI tối ưu hóa cơ chế thực thi mà không bị phụ thuộc vào dữ liệu kiểm thử cụ thể, từ đó tăng khả năng tổng quát hóa cho các tác vụ mới.
MetaRSI-v1 là kiến trúc đầu tiên cho phép AI không chỉ tự cải thiện mô hình mà còn tự tiến hóa cả quy trình cải thiện đó. Công nghệ này giúp các mô hình nhỏ đạt hiệu suất vượt trội mà không cần giáo viên hướng dẫn, mở ra kỷ nguyên 'tự cải thiện bình phương'.
Vì sao đáng đọc: Đây là nghiên cứu mang tính đột phá về khả năng tự tiến hóa của AI, giải quyết giới hạn của các hệ thống RSI hiện tại. Nội dung có tính học thuật cao, tầm ảnh hưởng lớn đến tương lai của AGI.
FlowBalance tối ưu hóa khả năng suy luận của AI bằng cách kết hợp phản hồi từ bộ kiểm chứng với hướng dẫn nội tại, giúp mô hình tự điều chỉnh dựa trên kết quả thực tế thay vì chỉ dựa vào dữ liệu huấn luyện sẵn có.
Người dùng @SPAC89 đã thử nghiệm so sánh Muse Spark 1.3 Ultra và Fable 5.1 trong 2 giờ với cùng một yêu cầu: AI phải tự lặp lại quy trình cải thiện cho đến khi đạt điểm đánh giá từ 9.5/10 trở lên.
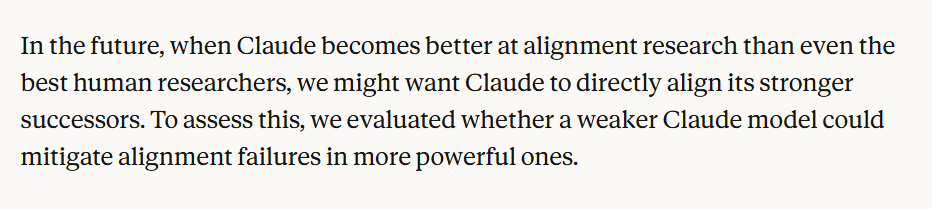
Anthropic just published one of the clearest previews of recursive self-improvement yet. But we stil…
DịchAnthropic giới thiệu phương pháp cho phép Claude tự thực hiện quy trình cải thiện căn chỉnh cho các mô hình AI khác. Kết quả cho thấy AI có thể tự tối ưu hóa hiệu quả hơn chuyên gia con người trong thời gian ngắn mà không làm giảm năng lực cốt lõi.
PILOT giới thiệu cơ chế giám sát-thực thi cho phép các tác nhân AI dài hạn tự tối ưu hóa quy trình và cập nhật công cụ ngay trong quá trình vận hành thông qua khả năng tự tiến hóa trực tiếp.
Meta^n giới thiệu phương pháp tự cải thiện đệ quy bằng cách mở rộng chiều sâu xử lý thông qua các thao tác meta cố định. Mô hình này vượt trội hơn các tác nhân tự cải thiện hiện có trên 8 bộ tiêu chuẩn, đặc biệt là kết quả ấn tượng tại ARC-AGI-2.
Recuris giới thiệu kiến trúc bộ nhớ đệ quy cho phép AI Agent theo dõi tiến trình và tự cập nhật kỹ năng thông qua các vòng lặp tiến hóa có cấu trúc, giúp nâng cao hiệu suất trong các tác vụ kéo dài.
CAFE là mô hình cho phép tác nhân tìm kiếm và bộ phê bình cùng tiến hóa thông qua học tăng cường trực tuyến và tối ưu hóa ưu tiên, giúp giảm thiểu ảo giác và nâng cao hiệu suất vượt trội trên nhiều tiêu chuẩn đánh giá.
Nghiên cứu giới thiệu Chain-of-Experience (CoE), cho phép các mô hình ngôn ngữ lớn tự học hỏi và cải thiện hiệu suất thông qua phản hồi lặp lại từ chính mình hoặc môi trường, thay vì chỉ dựa vào suy luận một lần.
Vì sao đáng đọc: Đây là hướng tiếp cận đột phá giúp LLM vượt qua giới hạn zero-shot, có tính ứng dụng cao trong việc tối ưu hóa mô hình mà không cần huấn luyện lại.
Tổng 13 tin, không còn tin nào nữa
40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (37 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả