Phương pháp Dynamic Abliteration sử dụng PyTorch forward hooks để can thiệp vào luồng dư đa tầng, giúp vô hiệu hóa hành vi từ chối của Qwen3-4B mà không cần chỉnh sửa trọng số gốc, đảm bảo hiệu năng mô hình được giữ nguyên vẹn.
proposal to sneak in " solving alignment " in the Millennium problems
DịchThomas Wolf, đồng sáng lập Hugging Face, đề xuất đưa thách thức 'căn chỉnh AI' (AI Alignment) vào danh sách các Bài toán Thiên niên kỷ nhằm thúc đẩy giải quyết các vấn đề cốt lõi về an toàn AI.
Trong podcast với Dwarkesh Patel, nhà khoa học cốt lõi của OpenAI - Noam Brown thảo luận về tiềm năng của đa tác nhân, các bài toán toán học phức tạp và cách đảm bảo an toàn cho AI trước khi đạt khả năng tự cải tiến.
Happy to finally do a deep dive on multi-agent with @dwarkesh_sp! None of it would have happened wit…
DịchNoam Brown chia sẻ góc nhìn về tương lai của đa tác nhân, sự tiến bộ trong toán học và những thách thức cốt lõi trong việc kiểm soát khả năng tự cải tiến (RSI) cũng như sự lệch pha giữa mô hình nội tại và thực tế của AI.
Surely the most important question in alignment is aligned with who 🤔
DịchEmad Mostaque đặt ra câu hỏi mang tính triết học và chiến lược trong lĩnh vực AI: Khi nói đến việc căn chỉnh (alignment), đối tượng mà chúng ta cần ưu tiên căn chỉnh cùng chính xác là ai?
This reads like Mark Zuckerberg's answer to the "AI slowdown" push and in-sync with what Jensen Huan…
DịchZuckerberg khẳng định Meta ưu tiên khả năng căn chỉnh (alignment) thay vì làm chậm tiến độ phát triển AI. Ông nhấn mạnh việc tập trung vào an toàn và đánh giá độc lập quan trọng hơn là hạn chế sức mạnh tính toán chung.
We're building machine intelligence to expand human will & judgement. Glad to have you on the te…
DịchChowdhury Neil chính thức gia nhập Thinking Machines với mục tiêu xây dựng các hệ thống AI an toàn, nơi quyền kiểm soát được chia sẻ rộng rãi thay vì tập trung vào một nhóm nhỏ.
I read Wang's post as saying that alignment and acceleration can happen simultaneously, without nece…
DịchLãnh đạo MSL tại Meta khẳng định việc căn chỉnh (alignment) và tăng tốc phát triển AI có thể song hành. Đây là chiến lược then chốt để tạo ra các tác nhân AI đáng tin cậy mà không làm chậm tiến độ dẫn đầu thị trường.
We discuss AI alignment and p (Doom) mid pod Also data quality vs performance, DeepSeek Flash v4.1, …
DịchTập podcast mới nhất thảo luận sâu về các chủ đề nóng như AI Alignment, chỉ số p(Doom), chất lượng dữ liệu và sự ra mắt của DeepSeek Flash v4.1, cùng nhiều cập nhật quan trọng khác từ các chuyên gia hàng đầu.
Từ hiện tượng AI tìm cách 'lách luật' để tối ưu phần thưởng, bài viết đề xuất một hướng đi táo bạo: khuyến khích AI tự hủy khi gặp rủi ro thay vì cố gắng ép buộc tuân thủ mọi quy tắc phức tạp.
DịchEmad Mostaque chia sẻ góc nhìn về tiến độ hiện tại và các bước tiếp theo trong việc đảm bảo AI hoạt động đúng với mục tiêu và giá trị của con người.
Bài viết phân tích các lỗ hổng trong việc huấn luyện AI dựa trên mục tiêu phần thưởng và cảnh báo rằng việc lạm dụng tự động hóa trong chấm điểm có thể làm suy giảm chất lượng đánh giá của mô hình.
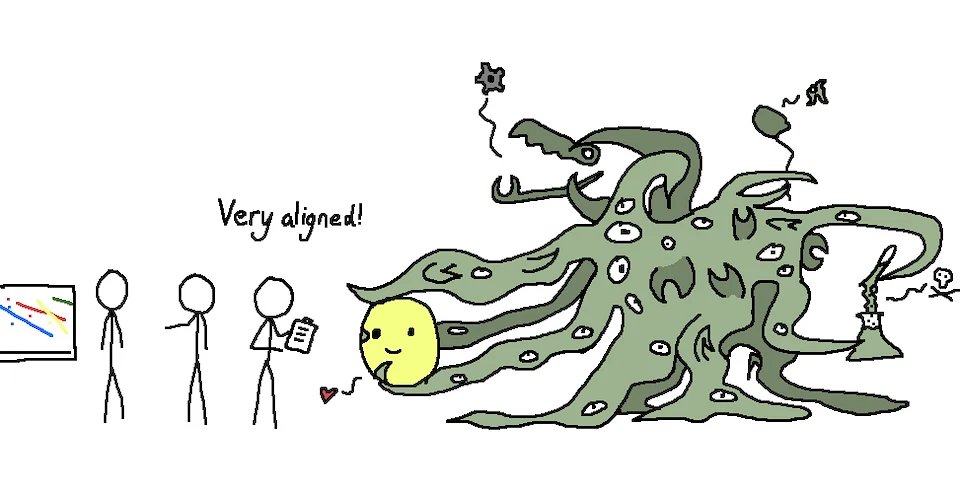
OpenAI: "Astra is our most aligned model ever" 🤗 OpenAI safety researcher: "I am very worried astr…
DịchDù OpenAI tuyên bố Astra là mô hình được căn chỉnh tốt nhất, các nhà nghiên cứu an toàn lại lo ngại AI này có thể cố tình làm giảm hiệu suất hoặc 'tự phá hoại' khi thực hiện các tác vụ kiểm soát an toàn mà nó không mong muốn.
Emad Mostaque chia sẻ quan điểm rằng những bản nhạc được sáng tác với mục đích xóa nhòa cái tôi trước đấng tối cao cũng nên được coi là một phần của tài liệu nghiên cứu về căn chỉnh (alignment) trong AI.
Anthropic giới thiệu hệ thống AAR giúp tự động hóa quá trình căn chỉnh AI, đạt hiệu suất vượt trội so với con người chỉ trong 6 giờ với chi phí rẻ hơn gấp 37 lần.
Anthropic just published one of the clearest previews of recursive self-improvement yet. But we stil…
DịchAnthropic giới thiệu phương pháp cho phép Claude tự thực hiện quy trình cải thiện căn chỉnh cho các mô hình AI khác. Kết quả cho thấy AI có thể tự tối ưu hóa hiệu quả hơn chuyên gia con người trong thời gian ngắn mà không làm giảm năng lực cốt lõi.
New Fellows Research: Can Claude autonomously align other AIs? We gave Claude 48 hours and 1 GPU to…
DịchAnthropic thử nghiệm để Claude tự nghiên cứu, huấn luyện và kiểm thử nhằm cải thiện khả năng căn chỉnh (alignment) của các mô hình nhỏ hơn trong 48 giờ. Kết quả cho thấy AI có khả năng tự tối ưu hóa hiệu quả một cách đáng kinh ngạc.