Banger paper from Stanford and Together AI. They show why it might be a good idea to let your agent…
DịchNghiên cứu mới đề xuất phương pháp Self-Organizing Agent Teams (SAT), cho phép các mô hình như o3-mini, Claude Sonnet 4 và DeepSeek-V3 tự rút kinh nghiệm từ quá trình cộng tác để tối ưu hóa hiệu suất, đạt trung bình 66,7% trên 5 bộ tiêu chuẩn.
New Stanford+Oxford paper MedRSI shows that medical agents can improve themselves from their own mis…
DịchNghiên cứu MedRSI chỉ ra rằng AI y tế có thể tự cải thiện từ sai sót, nhưng cần kiểm chứng kỹ lưỡng trước khi áp dụng. Việc giới hạn công cụ và chọn lọc dữ liệu giúp độ chính xác tăng từ 76,9% lên 94,4%, đồng thời ưu tiên xử lý các lỗi gây nguy hiểm lâm sàng cao.
Designer-RSI là khung thích nghi liên tục cho phép AI điều khiển phần mềm thiết kế chuyên nghiệp, tự xây dựng và tinh chỉnh bộ nhớ quy trình từ các tác vụ thực tế mà không cần con người gắn nhãn.
New interview of Barack Obama. He talks about recursive self-improvement stage of AI. "I do not be…
DịchCựu Tổng thống Obama nhận định AI đang bước vào giai đoạn tăng trưởng theo cấp số nhân nhờ khả năng tự học. Tỷ lệ dữ liệu máy tự tạo ra để học tập đã tăng vọt, báo hiệu một bước ngoặt quan trọng trong sự phát triển của trí tuệ nhân tạo.
Former President Barack Obama talks about recursive self-improvement stage of AI. (from "C-SPAN" Y…
DịchCựu Tổng thống Obama nhận định AI đang bước vào giai đoạn 'tự học đệ quy', nơi tỷ lệ máy tự học đã tăng vọt lên 50%. Ông cũng cảnh báo rằng dù công nghệ AI là thật, nhưng định giá của các công ty AI hiện nay có thể đang bị thổi phồng quá mức.
Banger paper from MIT and Sakana AI. They show that self-improving coding agents work. The best pa…
DịchNghiên cứu mới từ MIT và Sakana AI giới thiệu phương pháp SIFT, cho phép các tác nhân AI tự tối ưu hóa khả năng viết code với chi phí vận hành chỉ bằng 1/10 so với các mô hình hiện tại.
Agents can self-improve without retraining. EvoSkill v2 achieves this with persistent agent skills….
DịchEvoSkill v2 cho phép các Agent tự học và lưu trữ kỹ năng mới vào tệp tin sau mỗi lần thất bại. Khi gặp tác vụ tương tự, Agent sẽ tự động tải các kỹ năng này để tối ưu hiệu suất mà không cần thay đổi trọng số mô hình.
Agent memory is no longer just context. Persistent skills can change future behavior, so treat them…
DịchEvoSkill v2 cho phép AI tự đúc kết kỹ năng từ các nhiệm vụ thất bại và lưu trữ vào bộ nhớ ngoài. Cơ chế này giúp AI cải thiện hiệu suất mà không cần thay đổi trọng số mô hình hay huấn luyện lại.
RSIAgent giới thiệu khung làm việc RSI cho phép AI tự học hỏi từ kinh nghiệm thực tế và hiểu rõ quan hệ nhân quả trong môi trường mới mà không cần tái huấn luyện tham số, vượt qua cả GPT-6 Astra trong nhiều bài kiểm tra khó.
Vì sao đáng đọc: Bài viết giới thiệu hướng đi mới đầy tiềm năng trong việc tối ưu hóa AI Agent thông qua 'tích lũy kinh nghiệm' thay vì chỉ tăng quy mô mô hình, rất có giá trị cho cộng đồng nghiên cứu AI.
Thay vì bắt chước đáp án mẫu, phương pháp Negative Self-Distillation (NSD) giúp mô hình ngôn ngữ tự tối ưu hóa bằng cách nhận diện và tránh xa các suy luận sai lầm, từ đó thúc đẩy tư duy phản biện và tự sửa lỗi.
Vì sao đáng đọc: Đây là một hướng tiếp cận mới đầy tiềm năng trong việc huấn luyện LLM, giải quyết trực tiếp điểm yếu của phương pháp tự chưng cất (self-distillation) truyền thống.
Nghiên cứu giới thiệu StudyBench, một bộ tiêu chuẩn đánh giá khả năng tự học của AI từ tài liệu thô. Kết quả cho thấy việc học thuộc lòng sách giáo khoa không đảm bảo khả năng giải quyết các bài toán Olympic khó.
S3Gym là bộ tiêu chuẩn đánh giá mới giúp đo lường khả năng tự cải thiện của các tác nhân AI thông qua quy trình tự kiểm thử, tự đánh giá và tự tối ưu hóa trong môi trường trò chơi văn bản.
DiagEvo giúp mô hình AI tự học bằng cách lưu trữ các lỗi sai vào bộ nhớ phân tầng, từ đó tự tạo ra các bài tập thực hành phù hợp để khắc phục điểm yếu mà không cần dữ liệu bên ngoài.
Nghiên cứu giới thiệu khung 5 cấp độ (L0-L4) giúp các mô hình suy luận lớn (LRM) tự tiến hóa mà không cần sự can thiệp của con người, thông qua việc tự động hóa quá trình xác thực và tạo lộ trình học tập.
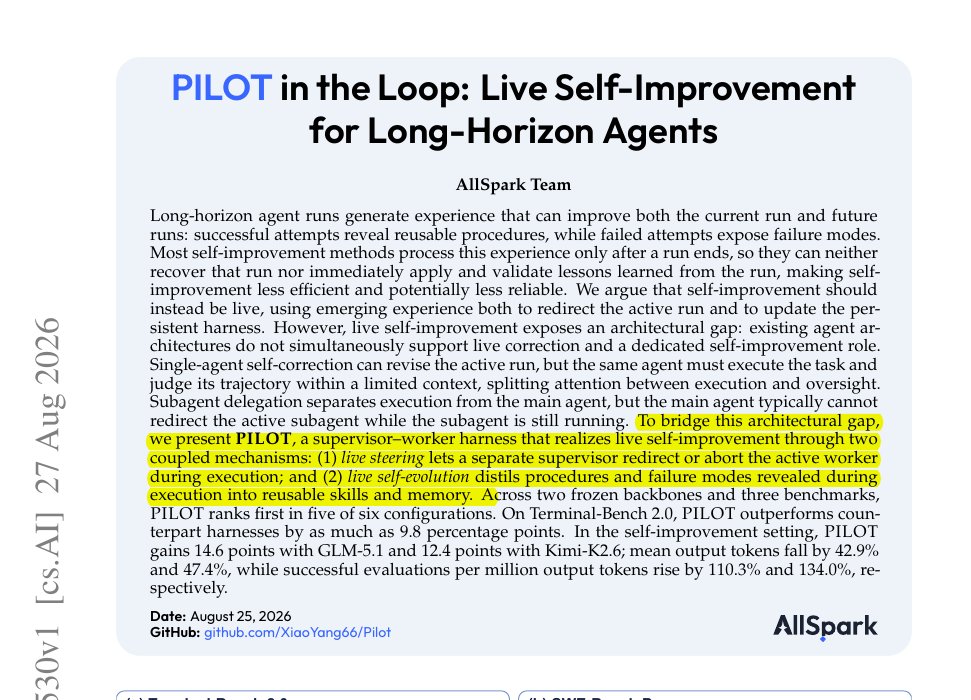
Most agent self-improvement happens too late: the system learns from a run only after that run is al…
DịchPILOT cho phép AI tự học và điều chỉnh hành vi theo thời gian thực thay vì đợi kết thúc tác vụ. Phương pháp này giúp tăng đáng kể tỷ lệ thành công trên các bài kiểm tra kỹ thuật, đồng thời tối ưu hóa hiệu suất và giảm thiểu lượng token tiêu thụ.
WikiSkill là khung làm việc đột phá giúp AI Agent chuyển hóa kinh nghiệm thực thi thành tri thức bền vững, cho phép các kỹ năng tự cập nhật và tối ưu hóa liên tục. Phương pháp này không chỉ vượt trội so với các kỹ thuật hiện có mà còn hỗ trợ khả năng chuyển đổi kỹ năng linh hoạt giữa các dòng mô hình.
Excited to introduce our first interactive AI Agents tutorial. Learn to build effective agent skill…
DịchKhóa học mới giúp bạn nắm vững lý thuyết và thực hành xây dựng kỹ năng cho AI Agent ngay trên nền tảng Pi. Đây là lộ trình lý tưởng cho những ai muốn bắt đầu phát triển các tác nhân AI hiệu quả.
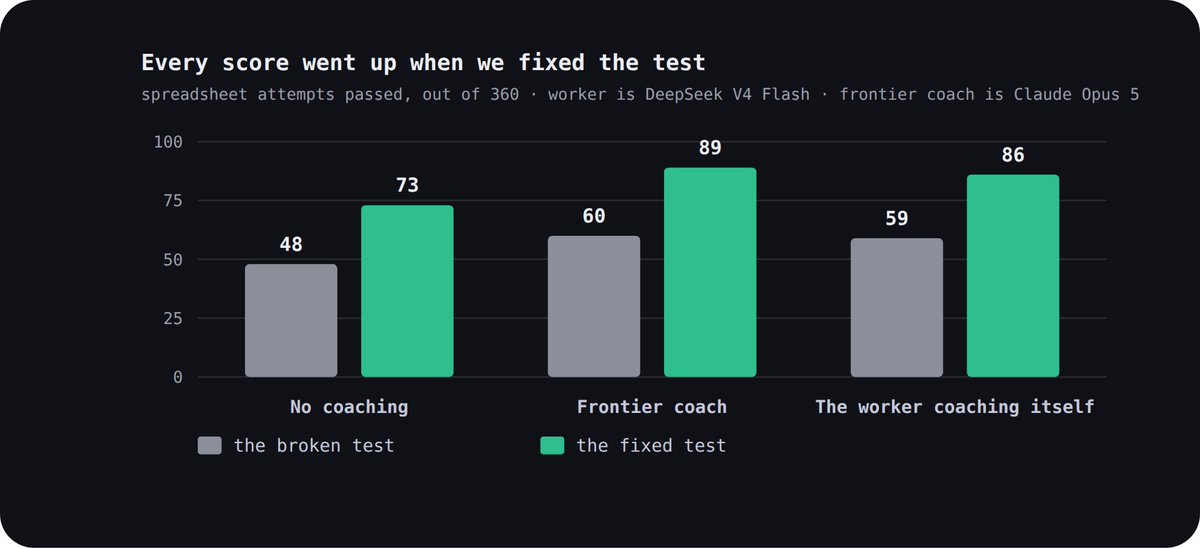
New Tsinghua and other Chinese Univ paper finds AI agents can optimize a training plan for hours, bu…
DịchNghiên cứu chỉ ra rằng các tác nhân AI dù tối ưu hóa tốt nhưng rất hiếm khi tự nhận ra sai lầm trong chiến lược cốt lõi. Ngay cả khi bổ sung công cụ hỗ trợ, AI vẫn chủ yếu lặp lại các phương pháp cũ thay vì thay đổi tư duy giải quyết vấn đề.
Tuần này nổi bật với hai nghiên cứu EnvHarness và SPADE, tập trung vào việc tối ưu hóa môi trường mô phỏng và cơ chế tự chơi (self-play) để nâng cao khả năng học tập cho các tác nhân AI.
FlowEvo là khung làm việc không cần huấn luyện, cho phép AI tự động chuyển đổi các quy trình thành công thành kỹ năng có thể tái sử dụng, giúp hệ thống liên tục phát triển và tối ưu hóa hiệu suất qua từng tác vụ.
Vì sao đáng đọc: Đột phá trong việc tối ưu hóa khả năng tự học của AI mà không cần huấn luyện lại, đạt kết quả vượt trội trên nhiều benchmark quan trọng. Rất đáng chú ý cho giới nghiên cứu.
Holy: NVIDIA's coding agent AVO scored 100% on ARC-AGI-3's 25 public games, solving all 183 levels. …
DịchTác nhân AI AVO của NVIDIA đã đạt điểm tuyệt đối 100% trong bài kiểm tra ARC-AGI-3 bằng cách tự học qua thử sai mà không cần quy tắc định sẵn. Được vận hành bởi Claude Opus 5, AVO thể hiện khả năng ghi nhớ dài hạn và giải quyết vấn đề phức tạp vượt trội.
SkillEvo giải quyết hạn chế của các phương pháp hiện tại bằng cách sử dụng phản hồi từ tương tác đa vòng để liên tục cải thiện kỹ năng của AI, thay vì chỉ dựa vào các đánh giá đơn lẻ vốn dễ bị đình trệ.
SPADE: Self-Play in Adaptive Synthetic Executable Environments
DịchSPADE là phương pháp huấn luyện tác nhân tự đối đầu, nơi chính AI sẽ tạo ra và cải tiến các môi trường cũng như nhiệm vụ của mình dựa trên chỉ số hối tiếc (regret). Đây là bước tiến quan trọng trong việc giúp AI tự quyết định lộ trình học tập tối ưu.
SkillForge là khung tự chưng cất giúp AI tự tạo và giải quyết các vấn đề đặc thù của dự án bằng cách tái hiện chức năng cốt lõi, từ đó tích lũy kỹ năng chuyên biệt để nâng cao hiệu suất sửa lỗi phần mềm.
LOPD giải quyết hạn chế của các phương pháp tự học truyền thống bằng cách cho phép AI tự tạo ra ngữ cảnh ưu tiên thay vì dựa vào dữ liệu thủ công, giúp hệ thống tự cải thiện hiệu quả và linh hoạt hơn.
Giáo sư Tom Yeh ra mắt chuyên mục 'AI by Hand', sử dụng phương pháp vẽ tay trực quan để giải thích cặn kẽ toán học và kiến trúc đằng sau các hệ thống AI, giúp người đọc nắm bắt bản chất thay vì chỉ nhìn vào các 'hộp đen' công nghệ.
Oumi has introduced a new development platform that allows LLMs to keep learning from their own prod…
DịchOumi giới thiệu nền tảng cho phép LLM tự đánh giá, tổng hợp dữ liệu và tự huấn luyện từ chính lưu lượng truy cập thực tế. Giải pháp này giúp doanh nghiệp xây dựng trí tuệ nhân tạo độc quyền, tạo lợi thế cạnh tranh thay vì phụ thuộc vào các mô hình dùng chung.
 DAIR.AI@dair_ai