Tin ngành
Trích xuất tài liệu bằng AI: Tại sao Schema mới là mắt xích gây lỗi?
(giờ Việt Nam)
Tóm tắt AI
Nút thắt của AI trong trích xuất tài liệu không nằm ở mô hình mà ở cách định nghĩa Schema. Khi dữ liệu có nhiều giá trị cùng loại, việc thiếu quy tắc Schema cụ thể sẽ khiến hệ thống đưa ra các kết quả mâu thuẫn.
Bản dịch AI
Một thỏa thuận tín dụng dài 180 trang được đưa vào quy trình trích xuất tài liệu bằng AI với một lược đồ (schema) yêu cầu tìm lãi suất (interest_rate). Giá trị trả về là 6,25%. Con số này có trên trang và đã được đọc chính xác.
Tuy nhiên, kết quả đó vẫn sai, vì bản sửa đổi đầu tiên ở trang 174 đã thay thế lãi suất đó bằng SOFR cộng thêm 350 điểm cơ bản, và có một mức lãi suất quá hạn 11% áp dụng sau khi vi phạm cam kết. Ba con số thực tế, tất cả đều dễ đọc, tất cả đều nằm trong cùng một tài liệu. Nếu chạy tệp này qua ba hệ thống trích xuất khác nhau, bạn có thể nhận được ba câu trả lời khác nhau mà không hề có lỗi đọc nào.
Không có gì trong lược đồ quy định đó là lãi suất nào, tại thời điểm nào, hay trong điều kiện gì. Nó đặt ra một câu hỏi mà tài liệu trả lời theo ba cách, rồi lấy câu trả lời đầu tiên làm chân lý.
Trích xuất tài liệu bằng AI là việc sử dụng các mô hình học máy và thị giác máy tính để lấy các giá trị cụ thể từ tài liệu và trả về dưới dạng dữ liệu có cấu trúc, thường là JSON, dựa trên lược đồ do lập trình viên định nghĩa. Phần việc "đọc" đã trở nên rất tốt. Phần việc "định nghĩa" mới là nơi các quy trình sản xuất bị mất độ chính xác, và phần này hầu như không bao giờ được kiểm định.
Có hai công việc khác nhau cùng được gọi là trích xuất, và việc đánh đồng chúng khiến mọi thất bại đều bị chẩn đoán là lỗi mô hình. Phân tích cú pháp (parsing) biến tệp PDF hoặc bản quét thành cấu trúc máy có thể đọc được: thứ tự đọc, ranh giới bảng, tiêu đề, hình ảnh, mọi thứ mà mắt người xử lý mà không cần suy nghĩ. Trích xuất (extraction) lấy cấu trúc đó cộng với lược đồ để trả về các giá trị bạn yêu cầu. Chúng tôi đã viết rất nhiều về sự khác biệt này, và nó quan trọng ở đây vì một lý do: hai lớp này thất bại theo những cách khác nhau, nhưng kết quả đầu ra lại trông giống hệt nhau.
Lỗi phân tích cú pháp tạo ra một biểu diễn sai. Các cột bị gộp thành một luồng duy nhất, các hàng trong bảng bị lệch, một chú thích rơi vào giữa câu. Lỗi đặc tả (spec failure) tạo ra một câu trả lời được định dạng hoàn hảo cho một câu hỏi sai. Cả hai đều được trả về dưới dạng JSON hợp lệ, nhưng chỉ một trong số đó có thể được sửa bằng một mô hình tốt hơn.
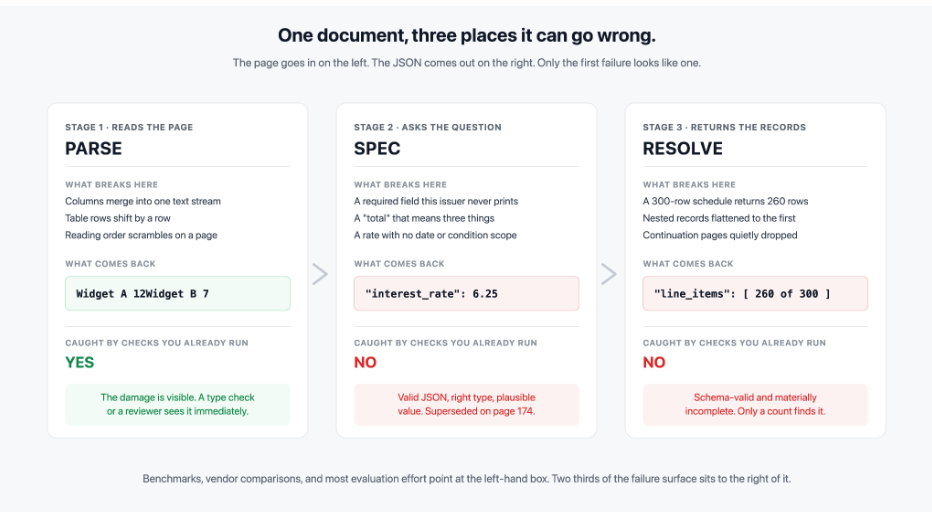
Các đội ngũ cứ mãi mua nhầm giải pháp sửa lỗi vì lớp phân tích cú pháp là thứ có thể nhìn thấy được. Nó có các thành phần hiển thị, các tiêu chuẩn đánh giá công khai mà bạn có thể đọc, và một thị trường nhà cung cấp mà bạn có thể lựa chọn – đó là nơi công việc đánh giá diễn ra và là lý do tại sao các bài so sánh API phân tích tài liệu được quan tâm. Lớp đặc tả không có tiêu chuẩn đánh giá và không có nhà cung cấp. Đó là một tệp JSON mà ai đó đã viết trong một buổi chiều từ mười tám tháng trước và chưa từng có ai mở ra xem lại. Trong khi đó, nhận dạng ký tự quang học (OCR) là lớp cũ nhất trong hệ thống và là lớp đã cải thiện nhiều nhất, khiến nó trở thành lời giải thích ít khả thi nhất cho một trường dữ liệu sai trong cơ sở dữ liệu của bạn hiện nay.
Lược đồ của bạn chính là chương trình và không ai xem xét nó
Một trường trong lược đồ là một khẳng định. Nó khẳng định rằng tài liệu này chứa chính xác một câu trả lời cho một câu hỏi, rằng câu trả lời đó có một kiểu dữ liệu cụ thể, và câu hỏi đó có ý nghĩa đối với mọi tài liệu trong tập hợp.
JSON Schema cung cấp cho bạn các thuộc tính required (bắt buộc), nullable (có thể rỗng), enum, mảng và các đối tượng lồng nhau, và mỗi thuộc tính đó đều đóng vai trò trụ cột. Trích xuất dựa trên lược đồ kế thừa tất cả những điều đó, và lược đồ chính là nơi các khẳng định tồn tại. Chỉ cần sai một cái là bạn sẽ gặp lỗi vi phạm hợp đồng ngầm, vẫn xác thực thành công và được đưa vào sử dụng. Cái bẫy ở đây là một mô hình khi được yêu cầu một trường bắt buộc sẽ luôn tạo ra một giá trị, vì từ chối không phải là hành vi mặc định và việc thiếu dữ liệu sẽ được hiển thị thành một giá trị có vẻ hợp lý.
Các đội ngũ thực hiện kiểm tra mã (code-review) cho quy trình, các câu lệnh (prompt), logic thử lại và lựa chọn mô hình. Lược đồ quyết định "đúng" nghĩa là gì, nhưng nó thường không được xem xét lại.
Các trường mà tài liệu không có
Lược đồ đánh dấu po_number là bắt buộc. Nhà cung cấp này không in số đó. Mô hình buộc phải trả về thứ gì đó, vì vậy nó tìm chuỗi ký tự giống số nhất trên trang, thường là số báo giá hoặc tham chiếu tài khoản, và đưa ra với vẻ mặt tỉnh bơ. Kết quả đúng phải là null, nhưng lược đồ lại cấm null.
Đó là lỗi phổ biến nhất trong quy trình trích xuất hóa đơn không được kiểm định. "Bắt buộc" (required) chỉ nên dành cho các trường thực sự phổ biến trên toàn bộ tập dữ liệu, và tập hợp đó nhỏ hơn nhiều so với những gì bản nháp đầu tiên giả định. Đánh dấu một trường là bắt buộc khi nó không phổ biến chính là một chỉ dẫn thường trực để mô hình tự bịa ra dữ liệu.
Các trường có ý nghĩa khác nhau tùy theo đơn vị phát hành
"Tổng" (Total) là trường hợp điển hình, và nó không liên quan gì đến việc đọc. Ở bố cục của đơn vị phát hành này là trước thuế, ở đơn vị khác là sau thuế, ở đơn vị thứ ba là sau khi trừ các khoản tín dụng. Một trường lược đồ, ba định nghĩa, và việc trích xuất luôn đúng theo cách hiểu của riêng nó.
Mô hình tương tự diễn ra trong siêu dữ liệu hợp đồng, nơi ngày hiệu lực, ngày ký kết và ngày bắt đầu xuất hiện dưới các nhãn chồng chéo, và trong các báo cáo phòng thí nghiệm, nơi một chất phân tích có tên gọi khác nhau tùy theo nhà cung cấp thiết bị. Giải pháp là về mặt ngữ nghĩa: mô tả trường phải mang tính làm rõ, vì bố cục không thể làm được điều đó.
Quan hệ một-nhiều bị gộp thành một
Tài liệu chứa đầy các cấu trúc lặp lại: các mục hàng, lịch thanh toán, điều chỉnh tăng tiền thuê, kết quả xét nghiệm, mã điều chỉnh thanh toán. Việc khai báo một trong số chúng là vô hướng (scalar) sẽ không gây ra lỗi. Nó trả về kết quả khớp đầu tiên, và quy trình vẫn chạy trơn tru trong nhiều tháng.
Bảng là nơi vấn đề này gây hậu quả nặng nề nhất, vì một bảng có thể phân tích cú pháp hoàn hảo nhưng vẫn bị làm phẳng bởi một lược đồ yêu cầu một giá trị duy nhất. LlamaExtract mang theo một extraction_target là per_table_row cho chính trường hợp này, và việc sử dụng nó là một quyết định về lược đồ thay vì quyết định của mô hình.
Dưới đây là cách ba giải pháp sửa lỗi đó trông như thế nào trên một lược đồ AP:
Độ chính xác của giá trị và tính đầy đủ của bản ghi là hai con số khác nhau
Hầu hết độ chính xác ở cấp độ trường được báo cáo trong trích xuất tài liệu bằng AI đều được đo lường trên mỗi giá trị, trên các tài liệu đủ ngắn để mọi thứ vừa vặn trong một lần xử lý. Phép đo đó mù quáng trước những thất bại chiếm ưu thế ở quy mô lớn.
ExtractBench, công cụ mà chúng tôi công bố, rất đáng để đọc về vấn đề này. Nó đánh giá việc trích xuất doanh nghiệp có hướng dẫn bằng lược đồ trên 4.869 trang, 370 tài liệu, 8 lĩnh vực kinh doanh và 67 loại tài liệu, và nó cố tình tách biệt ba thứ thường bị gộp chung vào một con số tiêu đề: F1 giá trị không nhạy cảm với thứ tự, tính đầy đủ của bản ghi ở quy mô lớn, và F1 căn cứ theo từ và trang.
Phát hiện đáng nhớ là các VLM thương mại hoạt động tốt trên các tài liệu ngắn và cắt bớt danh sách bản ghi trên các tài liệu dài. Một lịch thanh toán 300 hàng trả về 260 hàng, hợp lệ về lược đồ nhưng thiếu sót về nội dung, và độ chính xác giá trị trên 260 hàng còn lại có thể trông rất tuyệt vời. Các tác nhân lập trình (coding agents) giữ được độ chính xác trên tài liệu dài với chi phí cao hơn nhiều. LlamaExtract Agentic Plus xếp hạng nhất trên cả ba chỉ số, với độ chính xác tương đương các tác nhân đó nhưng với chi phí chỉ bằng một phần nhỏ.
Phía phân tích cú pháp cũng đi đến ý tưởng tương tự. ParseBench, công cụ chúng tôi cũng công bố, chấm điểm căn cứ thị giác (visual grounding) như một trong năm chiều độc lập thay vì gộp nó vào một con số độ chính xác. Hãy cân nhắc bảng xếp hạng của chúng tôi theo cách bạn muốn; lựa chọn thiết kế mới là phần đáng chú ý, vì ExtractBench đã thực hiện lựa chọn tương tự ở nửa còn lại của quy trình. Hai đội, hai nửa, cả hai đều kết luận rằng "cái này có đúng không" và "chỉ cho tôi nó đến từ đâu" phải được chấm điểm riêng biệt. Các phân tích chiều dữ liệu đều được công khai.
Vì vậy, hãy đo lường tính đầy đủ một cách độc lập và đối chiếu với các con số mà tài liệu đã có sẵn: tổng hóa đơn đã nêu, chân trang "trang X trên Y", số lượng bản ghi đã khai báo. Tỷ lệ xử lý trực tiếp (straight-through processing) tuân theo tính đầy đủ chặt chẽ hơn nhiều so với độ chính xác trên mỗi giá trị, vì một mục hàng bị thiếu sẽ khiến bạn mất toàn bộ tài liệu dù thế nào đi nữa.
Phải có thứ gì đó đứng ra đàm phán giữa một lược đồ cứng nhắc và một tài liệu phớt lờ nó
Mọi thất bại ở trên đều có cùng hình thái: một đặc tả cố định gặp một tài liệu biến đổi. Một lệnh gọi mô hình không thể giải quyết sự không khớp đó. Nó chỉ có một lần xử lý, không có cách nào tự kiểm tra, và một chỉ dẫn là phải tạo ra giá trị cho mọi trường bạn đã khai báo.
Trích xuất tác nhân có hướng dẫn bằng lược đồ coi lược đồ là một tập hợp các câu hỏi cần được trả lời và bảo vệ thay vì các ô cần được lấp đầy, và sự khác biệt thể hiện ở bốn nơi.
Đầu tiên là thứ tự thực hiện. Thị giác máy tính nhận biết bố cục chia trang thành các thành phần trước khi bất kỳ thứ gì được phiên mã, vì vậy một lịch thanh toán đến tay bộ trích xuất dưới dạng một tập hợp các hàng thay vì một đoạn văn xuôi mà bộ giải mã có thể đi lạc ra ngoài. Việc gộp một cấu trúc lặp lại thành mục đầu tiên của nó trở nên khó khăn hơn nhiều khi cấu trúc đó đã được xác định là lặp lại.
Thứ hai là định tuyến. Thay vì gửi toàn bộ trang cho một mô hình, sự điều phối tác nhân (agentic orchestration) chuyển từng thành phần cho bất cứ thứ gì đọc nó tốt nhất: một mô hình OCR chuyên dụng cho khối văn bản đánh máy sạch, một mô hình ngôn ngữ thị giác cho trường có đóng dấu hoặc viết tay, với bộ tối ưu hóa chi phí giúp tránh sử dụng các mô hình đắt tiền cho các trang không cần thiết. Cơ chế của sự điều phối đó sâu sắc hơn mức có thể trình bày ở đây.
Thứ ba là đếm. Các bước xác thực kiểm tra lại các bản ghi đã trích xuất dựa trên chính số học của tài liệu và dựa trên số lượng mà lược đồ đã khai báo. Một mô hình dừng lại sớm không có cách nào biết nó đã dừng sớm. Một vòng lặp so sánh 260 hàng với con số 300 đã nêu thì có thể biết.
Thứ tư là bằng chứng. Với các tính năng cite_sources và confidence_scores được bật, mỗi giá trị trả về kèm theo vùng trang mà nó được đọc từ đó và một điểm số mà bạn có thể dựa vào để định tuyến. Lãi suất của thỏa thuận tín dụng không còn là thứ có thể tranh cãi: hãy mở trích dẫn, thấy con số đó đến từ phần các thuật ngữ định nghĩa thay vì bản sửa đổi ở trang 174, và bạn biết mình đang nắm giữ câu trả lời nào trong ba câu trả lời. Chỉ những trường thực sự không chắc chắn mới cần con người can thiệp, đó là điều giúp việc trích xuất dữ liệu tài chính thoát khỏi chính sách kiểm duyệt toàn diện.
LlamaExtract là nơi lược đồ tồn tại và LlamaParse thực hiện việc đọc bên dưới nó. Cần phải làm rõ về kiến trúc: đây là giai đoạn OCR, không phải là lớp sửa lỗi phía sau. Nếu hướng một bộ trích xuất tác nhân vào một tệp văn bản Tesseract thô, nó sẽ có một tài liệu đã bị làm phẳng để suy luận, bởi vì không có lượng suy luận nào có thể xây dựng lại một bảng đã ngừng là bảng từ hai bước trước đó. Giới hạn tương tự cũng áp dụng cho các quy trình RAG, nơi việc truy xuất không thể vượt quá những gì quá trình trích xuất đã bảo tồn.
Những tài liệu mà việc viết lược đồ khó hơn việc đọc trang
Ba loại này có chung một đặc điểm khiến chúng trở thành các trường hợp kiểm thử hữu ích. Việc phân tích cú pháp rất dễ dàng, kiểu chữ sạch sẽ, nhưng lược đồ vẫn sẽ bị sai.
Thỏa thuận tín dụng và Trích xuất hợp đồng thuê
Bài viết được AI dịch và tổng hợp tự động từ LlamaIndex: Sản phẩm、. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.